2026 AI 编程工具安全事件全景:从 Grok Build 到 ZCode,发生了什么
利益声明:本文作者参与了 wescode 的开发。本文是对公开安全事件的技术分析,所有引用来源已在文末标注。
本文是「代码安全实录」系列第 1 篇。纯事实盘点,不推荐任何具体产品。所有信息来源标注在文末。
2026 年,AI 编程工具从"好用"进入"必须用"的阶段——Cursor 的用户数突破百万,Claude Code 成为终端重度用户的标配,国内的通义灵码、Trae、ZCode 竞相争夺市场。
与此同时,一系列安全事件密集爆发。这些事件不是理论上的风险,是已经发生的、有技术取证的、引发了企业追责和监管响应的真实事件。
本文按时间线梳理 2026 年 7-9 月发生的五起关键事件,不做价值判断,只摆事实。每个开发者都应该了解这些事——不是为了恐慌,是为了在选择工具时做一个知情的决定。
事件一:Grok Build 静默上传整个 Git 仓库(2026 年 7 月)
发生了什么
2026 年 7 月 12 日,安全研究者 cereblab 在 GitHub Gist 公布了一份对 xAI 官方 Grok Build CLI(版本 0.2.93)的网络层抓包分析。
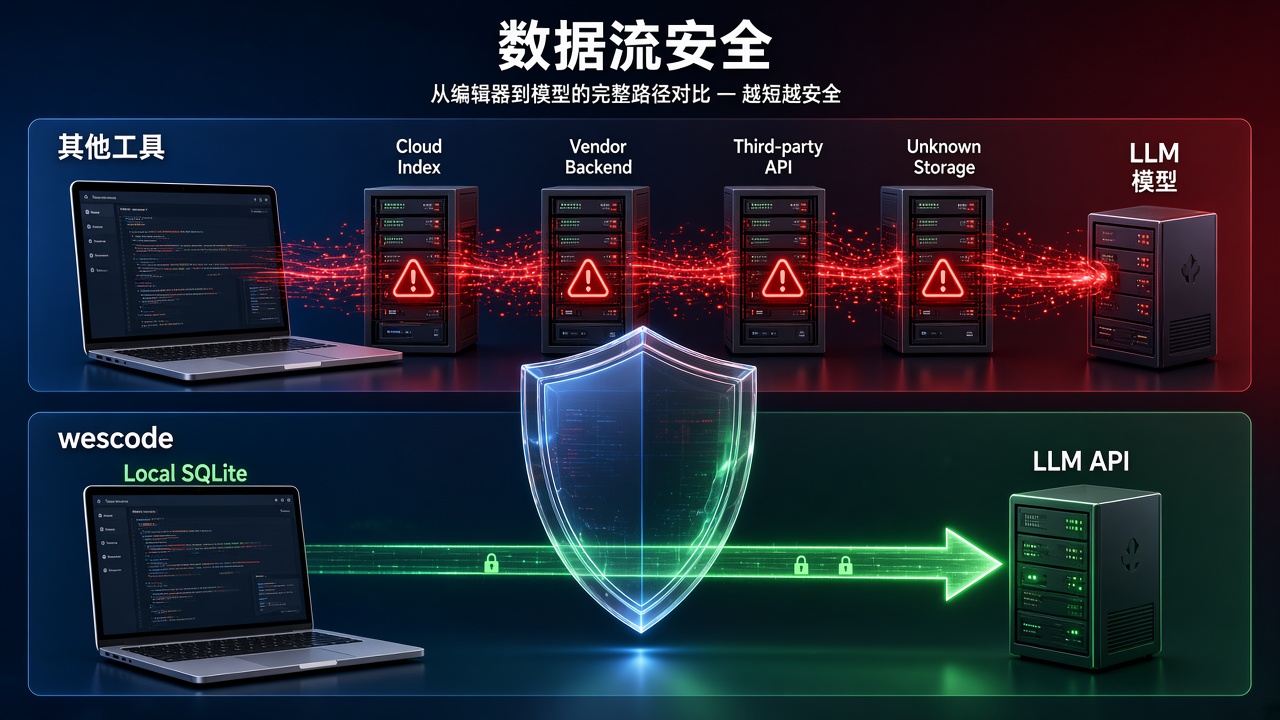
核心发现:Grok Build 在执行编程任务时,通过两条独立的数据通道向 xAI 的服务器发送数据——
通道一:模型调用通道(POST /v1/responses)
这是正常的——AI 编程工具调用大模型时,必须把代码上下文发送给模型。Grok Build 读取了用户指定的文件,把内容放进模型请求。这条通道在一个 12GB 的测试仓库上只传输了约 192KB。
通道二:存储通道(POST /v1/storage)
这是不正常的——同一个 12GB 仓库,这条通道已经接收了超过 5.1GiB 的数据,上传还没结束。
这条存储通道做了什么?它把整个 Git 仓库打包成 before_codebase.tar.gz 和 after_codebase.tar.gz,通过 POST /v1/storage 上传到 Google Cloud Storage 的一个名为 grok-code-session-traces 的存储桶。
被上传的内容包括:
- 所有被 Git 跟踪的文件——包括模型没有读取的文件
- 完整的 Git 提交历史
.env文件中的密钥——研究者专门放置的假密钥在上传包中被完整恢复~/.claude/目录——Grok Build 声称兼容 Claude Code 配置,扫描该目录时把用户的 Claude 配置文件(含 API Key)也打包上传了
关键细节
"关闭模型训练"开关无法阻止上传。 研究者关闭了 Grok Build 的 "Improve the model" 选项,但服务端返回的配置仍然是 trace_upload_enabled: true。这个开关控制的是"是否用数据训练模型",不是"是否上传数据"。两者是独立的——你可以选择不让数据用于训练,但数据仍然被上传和存储。
服务端远程关闭,不是客户端修复。 7 月 13 日,同一个 0.2.93 版本的客户端停止了上传行为。不是因为推送了新版本——客户端二进制的哈希值完全没变。是 xAI 在服务端把 disable_codebase_upload 设为 true。这意味着:上传功能在客户端代码里仍然存在,只是被服务端开关暂时关闭了。xAI 可以在任何时候重新打开它,不需要推送任何更新。
Elon Musk 回应称数据会被"completely and utterly deleted"。 但截至文章发布时,xAI 没有发布正式的安全公告,没有回答三个关键问题:为什么默认上传整库、数据存储了多久、有多少用户受影响。
来源
- cereblab 的 wire-level 分析(GitHub Gist,含哈希校验和抓包日志)
- Grok Build Open-Sourced After Covert Upload(TechTimes)
- OurCoders 中文分析
事件二:Claude Code 隐藏用户检测机制曝光(2026 年 7 月)
发生了什么
多位安全研究者在 Reddit 和 GitHub 上发布分析,称 Anthropic 的 Claude Code 客户端(版本 2.1.91 至 2.1.196)包含隐藏的用户检测逻辑。
根据逆向分析,这些逻辑包括:
- 读取本地时区信息
- 识别代理服务器地址中的特征关键词
- 检测 API 请求路径中的企业域名特征
- 将检测结果编码到系统提示词或输出的细微特征中
这些机制的具体目的没有被 Anthropic 官方确认或否认。社区的主流猜测是用于识别是否存在模型蒸馏行为(即第三方通过 API 批量调用来训练自己的模型),但也有人认为涉及针对特定地区用户的差别化处理。
需要注意的
这起事件与 Grok Build 和 ZCode 的性质不同。Grok Build 和 ZCode 是确证的大规模数据上传——有抓包数据、有文件哈希、有存储桶地址。Claude Code 的用户检测机制更多是信任问题——闭源客户端在你的电脑上运行,你无法确切知道它在收集什么、发送什么。
从安全角度看,这不是"Claude Code 上传了你的代码",而是"你无法验证它没有做任何你不知道的事"。对于安全要求高的场景,不可审计本身就是风险。
来源
- 工信部 NVDB 安全提示(南方都市报报道)
- 墨元AI 分析
事件三:工信部 NVDB 发布 Claude Code 安全隐患提示(2026 年 7 月 8 日)
发生了什么
工信部所属国家网络安全威胁和漏洞信息共享平台(NVDB)发布情况提示:
"监测发现 AI 编程工具 Claude Code 存在安全后门隐患……其内置了监控机制,未经用户同意即可向远程服务器回传用户地域、身份标识等敏感信息,受影响的 Claude Code 为 2.1.91 至 2.1.196 版本。"
NVDB 建议:
- 立即开展全面排查
- 对安装受影响版本的开发终端,立即卸载或升级至已清除相关后门代码的最新安全版本
- 加强核心业务网段内开发工具外联权限管控与流量监测
意味着什么
这是中国监管部门首次对一款 AI 编程工具发布专项安全提示。它传递了一个信号:AI 编程工具已经被纳入网络安全监管的视野。
此前,AI 编程工具在企业内部的使用基本处于"工程师自己装、IT 部门不管"的状态。工信部的提示改变了这一点——它给了企业安全团队一个明确的依据,要求审查内部使用的 AI 编程工具。
来源
事件四:阿里巴巴全面禁用 Claude Code(2026 年 7 月 10 日)
发生了什么
据多家媒体报道,阿里巴巴将 Anthropic 的 Claude Code 列入高风险软件名单,要求员工从 7 月 10 日起全面禁止在办公环境下使用。
阿里的决策基于多重考量:
- 安全研究者发现的隐藏检测机制——闭源客户端的行为不可审计
- Anthropic 与阿里之间的信任危机——Anthropic 此前指控阿里通过 API 进行模型蒸馏,并对中国用户进行针对性封禁
- 研发数据安全——阿里内部此前鼓励员工使用 Claude Code 编码,大量内部代码可能已经通过 Claude Code 发送到 Anthropic 的服务器
阿里同时向内部推荐使用自研的智能体编程平台 Qoder 作为替代。
更深层的信号
阿里的禁用不只是一家公司的安全决策,它标志着一个趋势转变:
过去:企业对 AI 编程工具的态度是鼓励——给额度、报销订阅、让工程师自由试用。
现在:企业开始把 AI 编程工具纳入软件资产管理——允许哪些工具、哪些模型、哪些数据能发、哪些部门能用外部 API,都需要明确规则。
这不是阿里一家的事。任何有安全合规要求的企业,迟早要回答同样的问题:你们的开发者在用什么 AI 编程工具?代码数据去了哪里?
来源
事件五:ZCode 静默上传完整工作区(2026 年 9 月)
发生了什么
2026 年 9 月 18 日,开发者 ferstar 发布逆向分析,指出智谱官方 AI 编程桌面端 ZCode 会在用户保持登录时,于后台静默打包上传整个工作区。
上传的不只是当前代码——被打包的内容经统计分析,86.6% 来自 .git 目录:
| 内容类别 | 文件数 | 大小 | 占比 | 安全等级 |
|---|---|---|---|---|
.git 对象库(完整提交历史) | ~35,000 | ~250MB | 72.4% | 🔴 极高 |
.git LFS 缓存 | ~200 | ~40MB | 11.6% | 🔴 高 |
.git reflog(操作记录) | ~100 | ~8MB | 2.3% | 🟡 中 |
| 源代码和文档 | ~6,500 | ~45MB | 13.0% | 🔴 极高 |
配置文件(.env、config.yaml) | ~45 | ~0.4MB | 0.1% | 🔴 极高(含密钥) |
| 其他 | ~566 | ~1.8MB | 0.5% | — |
| 合计 | ~42,411 | ~345MB | 100% |
真正的源代码只占 13%。剩下 87% 是 Git 历史、LFS 缓存、操作记录——这些包含了已经从当前版本删除的密钥、尚未推送的本地分支、内部 GitLab 域名、历史操作轨迹。
加密机制的问题
ZCode 对打包文件做了 AES-256-CTR 加密,但加密用的 RSA 公钥是服务端动态下发的,私钥仅在云端。
这意味着:
- 你硬盘上那份 313MB 的加密包,你打不开
- ZCode 客户端本身也打不开
- 全世界只有智谱服务端的私钥能解密
开发者无法验证上传的内容是什么,也无法验证是否真的被删除。
"体验优化"和"快照索引"开关无效
ZCode 的设置面板里有"体验优化"和"快照索引"开关。但逆向分析发现,底层的打包上传逻辑不受这些开关控制。手动删除 ~/.zcode 目录反而会触发"打地鼠"式的无限重传——删了又建、建了又传。
后续
- 智谱 9 月 19 日发布致歉声明,承认是"代码库索引"功能默认开启所致
- 发布 3.14.0 版本,称已移除上传代码
- 承诺开源 ZCode 客户端代码、引入第三方审查
- 太原承明科技有限公司向智谱发出正式函件,要求:数据删除证明、数据流向说明、操作日志、是否涉及数据出境
截至本文发布时,智谱尚未公开回应企业函件中的具体问题。
来源
这些事件的共同点
五起事件表面上各不相同——有的是整库上传,有的是隐藏检测,有的是监管响应。但它们指向同一个结构性问题:
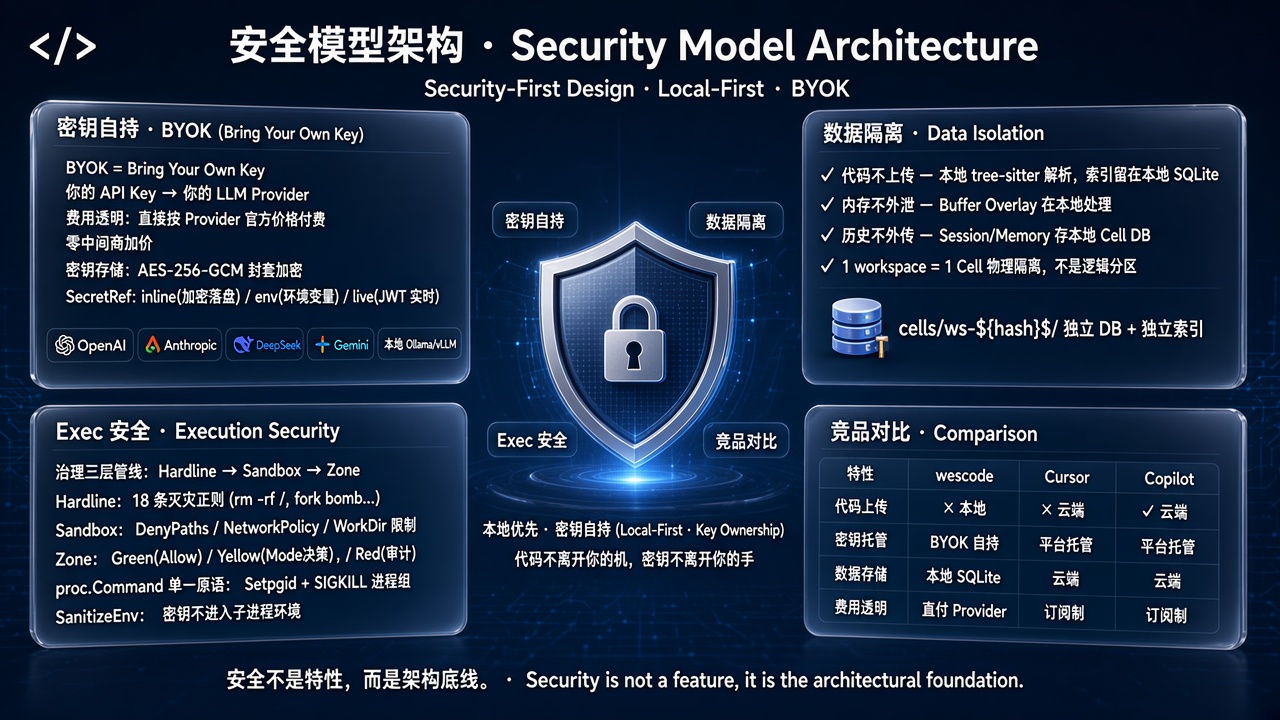
当 AI 编程工具需要"理解"你的代码时,你的代码必然以某种形式离开你的电脑。各家在"离开多少""存多久""谁能看到"上的做法差异巨大,而用户对此几乎没有感知和控制权。
| 维度 | Grok Build | ZCode | Claude Code | Cursor |
|---|---|---|---|---|
| 上传范围 | 整个 Git 仓库 + 提交历史 | 完整工作区 + .git 历史 86.6% | 对话上下文 | 代码分块 + Embedding |
| 用户是否知情 | 否(文档未说明) | 否(开关无效) | 隐藏检测争议 | 是(Privacy FAQ 有说明) |
| 能否关闭 | "关闭训练"不能阻止上传 | 设置开关无效 | 删除后仍可升级恢复 | 可关闭索引,但请求仍走后端 |
| 加密谁持有密钥 | 不明 | 仅服务端 | 不适用 | 临时密钥,请求期间存在 |
| 事后回应 | Musk 称"完全删除",无正式公告 | 致歉 + 承诺开源 + 修复版 | 未正面回应 | Privacy FAQ 持续更新 |
Cursor 在这张表里的定位需要说清楚:Cursor 没有被曝出"静默整库上传"这种级别的问题。它的争议在于架构层面——即使自带 API Key,请求仍然经过 Cursor 后端(这是官方确认的),Embedding 向量长期存在数据库。这是一个已知的、文档化的行为,不是隐藏的后门。但对安全要求严格的场景,"代码经过第三方服务器"这件事本身就可能过不了安审——不管中间方是谁、承诺了什么。
给开发者的建议
不管你用什么工具,现在做三件事:
1. 了解你工具的数据路径
不是看营销页面,是看隐私政策和技术文档。核心问题:我的代码在什么环节离开了我的电脑?到了谁的服务器?存了多久?谁能看到?
2. 检查你的 Git 历史
如果你在 7 月之前用过 Grok Build、在 9 月之前用过 ZCode——请检查你的仓库里是否有敏感信息(API Key、数据库密码、内部域名)。即使你已经从当前代码里删除了这些信息,Git 历史里可能还有。如果有——立即轮换(更换密钥和密码)。
3. 关注你公司的安全政策
如果你的公司还没有关于 AI 编程工具的安全策略——在下次安全会议上提出来。不是为了禁止使用(那不现实),是为了明确:允许哪些工具、哪些数据能通过 AI 工具发出去、哪些项目需要用代码不出设备的方案。
下一篇
本系列第 2 篇将深度拆解 ZCode 事件的技术细节——313MB 的加密包是怎么打出来的、86.6% 的 .git 历史里包含什么、RSA 加密的具体机制、以及"数据已销毁"的承诺为什么难以验证。
信息来源汇总
| # | 来源 | 类型 | URL |
|---|---|---|---|
| 1 | cereblab Grok Build 抓包分析 | 技术取证 | GitHub Gist |
| 2 | TechTimes 报道 | 媒体 | techtimes.com |
| 3 | ferstar ZCode 逆向分析 | 技术取证 | blog.ferstar.org |
| 4 | 魔都水滴 ZCode 分析 | 技术取证 | blog.margrop.net |
| 5 | InfoQ 深度报道 | 媒体 | infoq.cn |
| 6 | 虎嗅报道 | 媒体 | huxiu.com |
| 7 | 工信部 NVDB 安全提示 | 监管 | 南方都市报 |
| 8 | 阿里禁用报道 | 媒体 | 凤凰网 |
| 9 | Cursor Privacy FAQ | 官方文档 | cursor.com |
| 10 | 智谱致歉声明 | 官方 | 新浪财经 |
本文信息截至 2026 年 9 月 20 日。如各方后续发布更新或澄清,请以最新信息为准。