你的代码出去了几跳:六款工具数据流技术拆解
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
本文是「代码安全实录」系列第 6 篇。技术拆解,逐工具画数据流,不做价值判断。所有信息来源标注在文末。
在前几篇里,我们回顾了 2026 年发生的安全事件、拆解了 ZCode 的加密机制、分析了 Cursor 的 Embedding 存储。这些都是具体的个案。这一篇退后一步,做一件更基本的事——
画出每款工具的完整数据流:你的代码从按下回车到被模型处理,中间经过了几个节点?
我们把这个指标叫做**"跳数"**——代码从你的电脑到模型供应商之间,经过了几个由不同实体控制的中间服务器。跳数不是越少越好的绝对标准,但它直接决定了攻击面大小、合规审查复杂度和信任链长度。
什么是"跳"
先定义清楚。
一"跳"(hop)是指代码数据经过的一个由独立实体控制的服务节点。这里的"独立实体"是指一家独立的公司或组织——它有自己的服务器、自己的运维团队、自己的数据处理策略。
不算跳的情况:
- 你电脑上的进程之间传递数据(编辑器 → 本地插件)——同一台机器,同一个控制者
- 你的电脑到你自己部署的 Ollama 服务——虽然可能跨网络,但仍然是同一个控制者(你自己)
算一跳的情况:
- 你的代码发送到 Cursor 的后端服务器——Cursor 是一个独立实体,你的数据进入了它的控制范围
- Cursor 的服务器把请求转发给 OpenAI——OpenAI 是另一个独立实体
为什么以"独立实体"而非"网络请求次数"为标准:因为安全审计关心的是谁能看到你的数据,而不是 TCP 连接建了几次。你电脑上一个进程调了三次本地 API——零跳。你的代码经过一家代理公司转发到模型供应商——两跳,即使只有一个 HTTP 请求。
六款工具的完整数据流
1. Cursor(自带 Key 模式)——2 跳
你的电脑                        Cursor 的服务器              模型供应商(OpenAI/Anthropic/…)
┌──────────────┐               ┌──────────────────┐         ┌──────────────────┐
│              │  ① 代码分块   │                  │  ③ API  │                  │
│   VS Code    │──────────────→│  Cursor 后端     │────────→│  OpenAI / Claude │
│   (Cursor    │  + Embedding  │                  │  请求   │                  │
│    Fork)     │  请求         │  · Embedding 计算│         │  · 模型推理      │
│              │               │  · Prompt 组装   │         │  · 返回结果      │
│  · 代码编辑  │  ② Embedding  │  · 缓存索引      │  ④ 响应 │                  │
│  · 文件读写  │  向量返回     │  · 请求转发      │←────────│                  │
│              │←──────────────│                  │         │                  │
└──────────────┘               └──────────────────┘         └──────────────────┘

跳数:2(你 → Cursor → 模型供应商)
关键细节:
-
即使你自带 API Key,请求仍然经过 Cursor 后端。这不是猜测——Cursor 官方在 Privacy FAQ 中明确说明:
"When you use your own API key, your request is still routed through our backend."
原因是 Cursor 的 Prompt 组装逻辑(包括上下文选择、Embedding 匹配、代码分块)运行在它的服务器上。你的 Key 被用来在最后一步调用模型 API,但代码上下文已经经过了 Cursor 的服务器。
-
Embedding 向量存储在 Cursor 的数据库。当你打开一个项目时,Cursor 会对代码做分块和 Embedding 计算。这些向量存储在 Cursor 控制的数据库中——不是你本地的数据库。
-
Privacy Mode 的实际效果:开启后 Cursor 承诺不存储代码片段用于训练,但请求仍然经过它的后端。Privacy Mode 控制的是数据用途(不训练),不是数据路径(不经过)。
2. GitHub Copilot——2 跳
你的电脑                        GitHub / Microsoft 服务器    模型供应商(OpenAI)
┌──────────────┐               ┌──────────────────┐         ┌──────────────────┐
│              │  ① 编辑器     │                  │  ③ API  │                  │
│   VS Code    │──────────────→│  Copilot 后端    │────────→│  OpenAI          │
│   + Copilot  │  上下文       │                  │  请求   │  (Codex/GPT)     │
│   扩展       │               │  · 上下文处理    │         │                  │
│              │               │  · 用量统计      │  ④ 响应 │  · 模型推理      │
│              │  ② 补全结果   │  · 代码片段过滤  │←────────│  · 返回结果      │
│              │←──────────────│                  │         │                  │
└──────────────┘               └──────────────────┘         └──────────────────┘

跳数:2(你 → GitHub → OpenAI)
关键细节:
- GitHub Copilot 的所有请求都经过 GitHub/Microsoft 的服务器。Business 版和 Enterprise 版提供了更多安全承诺——不用数据训练、可配置允许列表、有 SOC 2 认证。
- Copilot 的上下文窗口相对保守(主要是当前文件 + 打开的标签页),传输的代码量通常小于全仓库索引的工具。
- 企业版提供了代码片段过滤功能——如果模型的建议与公开代码高度相似,会被过滤掉。
3. Claude Code(Anthropic 直连)——1 跳
你的电脑                                          模型供应商(Anthropic)
┌─────────────────────────┐                       ┌──────────────────┐
│                         │  ① API 请求           │                  │
│   终端                  │──────────────────────→│  Anthropic API   │
│   + Claude Code CLI     │  (代码上下文 +       │                  │
│                         │   对话历史)           │  · 模型推理      │
│  · 本地文件读写         │                       │  · 返回结果      │
│  · 本地 Shell 执行      │  ② 响应               │                  │
│  · Prompt 本地组装      │←──────────────────────│                  │
│                         │                       │                  │
└─────────────────────────┘                       └──────────────────┘

跳数:1(你 → Anthropic)
关键细节:
- Claude Code 的 Prompt 组装在本地完成——CLI 在你的电脑上读文件、分析上下文、构造请求,然后直连 Anthropic 的 API。没有中间服务器。
- 但 Claude Code 本身是闭源的。前面几篇提到的"隐藏用户检测机制"争议就源于此——你无法审计闭源客户端在你电脑上到底做了什么。
- 1 跳意味着你只需要信任一个外部实体(Anthropic),而不是两个。但 Anthropic 的数据保留策略仍然适用——请求数据默认保留 30 天(可通过企业合同调整)。
4. wescode(BYOK + 云端模型)——1 跳
你的电脑                                          模型供应商(OpenAI/Anthropic/DeepSeek/…)
┌─────────────────────────┐                       ┌──────────────────┐
│                         │  ② API 请求           │                  │
│   VS Code Fork          │──────────────────────→│  模型供应商 API  │
│   (wescode)             │  (Prompt,含代码     │                  │
│                         │   上下文片段)         │  · 模型推理      │
│  ① 本地完成:           │                       │  · 返回结果      │
│  · tree-sitter 代码解析 │  ③ 响应               │                  │
│  · CKG 知识图谱构建     │←──────────────────────│                  │
│  · SQLite 本地存储      │                       │                  │
│  · Prompt 本地组装      │                       │                  │
│  · 上下文选择和排序     │                       │                  │
└─────────────────────────┘                       └──────────────────┘

跳数:1(你 → 模型供应商)
关键细节:
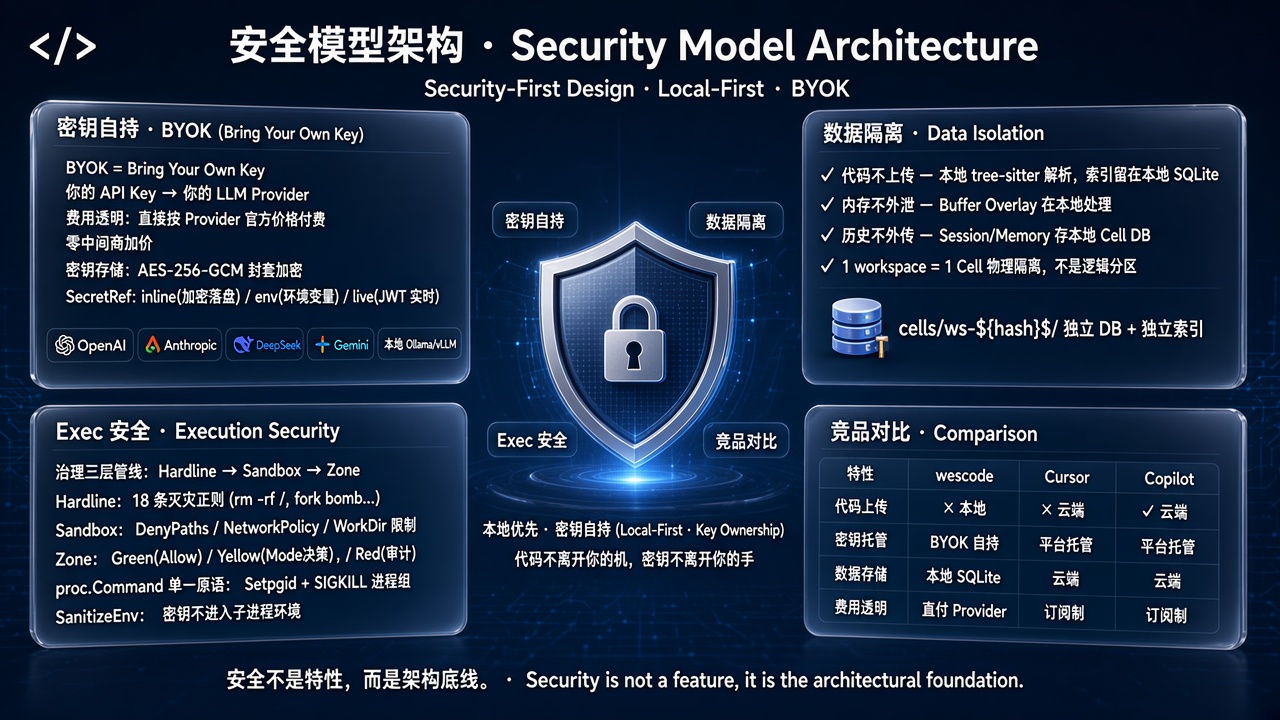
- wescode 基于 Code OSS(VS Code 的开源版本)。代码解析、索引构建、上下文选择、Prompt 组装——这些全部在你的电脑上完成。
- CKG(代码知识图谱) 使用 tree-sitter 在本地解析代码结构,生成函数调用关系、类型引用、导入依赖等六种关系。索引存储在本地 SQLite 数据库。10 万行代码的索引通常在 5-15 秒内完成(内部测试数据)。
- 当你发起一次 AI 对话时,wescode 根据 CKG 和当前上下文在本地组装 Prompt,然后用你自己的 API Key 直连模型供应商。代码不经过 wescode 的任何服务器——wescode 没有运行后端服务来中转这些请求。
- 与 Claude Code 的 1 跳区别:wescode 是基于 Code OSS 的开源方案,代码可审计;Claude Code 是闭源 CLI。
5. wescode(Ollama / vLLM 本地模型)——0 跳
你的电脑
┌──────────────────────────────────────────────────┐
│                                                  │
│   VS Code Fork (wescode)        Ollama / vLLM    │
│   ┌──────────────────┐         ┌──────────────┐  │
│   │                  │  ② API  │              │  │
│   │  ① 本地完成:    │────────→│  本地模型    │  │
│   │  · 代码解析      │  请求   │  (Qwen/Llama │  │
│   │  · CKG 构建      │         │   /DeepSeek  │  │
│   │  · Prompt 组装   │  ③ 响应 │   /Codestral)│  │
│   │  · 上下文选择    │←────────│              │  │
│   │                  │         │              │  │
│   └──────────────────┘         └──────────────┘  │
│                                                  │
│   零出站网络流量                                  │
└──────────────────────────────────────────────────┘

跳数:0(全程本地)
关键细节:
- Ollama 在你的电脑上运行一个模型推理服务(通常监听
localhost:11434)。wescode 把 Prompt 发给这个本地端点,模型的推理结果直接返回。全程没有数据离开你的电脑。 - 这是唯一真正的"零出站"方案——断开网络后仍然可以正常使用。
- 代价是本地模型的推理能力弱于云端大模型。7B 参数模型在补全场景表现尚可,但在复杂推理和大范围代码理解上明显不如 Claude 3.5 Sonnet 或 GPT-4o。
6. 通义灵码 / Trae——2 跳
你的电脑                        阿里云 / 字节云端              模型
┌──────────────┐               ┌──────────────────┐         ┌──────────────────┐
│              │  ① 代码       │                  │  ③ 模型 │                  │
│   VS Code    │──────────────→│  灵码/Trae 云端  │────────→│  通义千问 /      │
│   + 插件     │  上下文       │                  │  调用   │  豆包 /          │
│              │               │  · 上下文处理    │         │  其他模型        │
│              │               │  · 用量统计      │  ④ 响应 │                  │
│              │  ② 结果       │  · 增值服务      │←────────│  · 模型推理      │
│              │←──────────────│                  │         │  · 返回结果      │
└──────────────┘               └──────────────────┘         └──────────────────┘

跳数:2(你 → 阿里云/字节 → 模型)*
*注:当通义灵码调用自家通义千问模型时,中间的云端和模型可能在同一基础设施内,物理上可能是 1 跳。但从控制实体角度看,如果平台层和模型层是同一家公司运营,逻辑上可以视为 1.5 跳。这里统一按最保守的 2 跳计算。
关键细节:
- 国产 AI 编程工具大多采用类似架构:编辑器插件 → 自家云端 → 模型推理。免费策略背后的商业模型是:通过编程工具沉淀开发者生态,推广云服务。
- 通义灵码提供企业版,允许私有部署模型,在这种模式下跳数可以降低。
- Trae 使用字节跳动的云端服务,免费提供 Claude 3.5 Sonnet 等第三方模型调用——这意味着你的代码先到字节的服务器,再由字节转发给 Anthropic。
跳数对照表
| 工具 | 模式 | 跳数 | 代码经过的实体 | Prompt 组装位置 | 索引存储位置 |
|---|---|---|---|---|---|
| Cursor | 自带 Key | 2 | Cursor + 模型供应商 | Cursor 后端 | Cursor 后端 |
| Cursor | 官方订阅 | 2 | Cursor + 模型供应商 | Cursor 后端 | Cursor 后端 |
| Copilot | 标准 | 2 | GitHub + OpenAI | GitHub 后端 | GitHub 后端 |
| Claude Code | 直连 | 1 | Anthropic | 本地 CLI | 无持久索引 |
| wescode | BYOK 云端 | 1 | 模型供应商 | 本地 | 本地 SQLite |
| wescode | Ollama | 0 | 无 | 本地 | 本地 SQLite |
| 通义灵码 | 标准 | 2 | 阿里云 + 模型 | 阿里云端 | 阿里云端 |
| Trae | 免费 | 2 | 字节 + 模型供应商 | 字节云端 | 字节云端 |
每多一跳意味着什么
跳数不是越少越好的绝对标准——2 跳的工具不一定比 1 跳的"差"。但跳数直接影响三个维度:
1. 攻击面(Attack Surface)
每多一跳,代码数据就多经过一个独立实体的基础设施。每个实体都有自己的:
- 服务器被入侵的可能
- 员工越权访问的可能
- 数据泄露事件的可能
- 被政府要求提供数据的管辖范围
2 跳意味着你需要信任两家公司的安全能力和善意。不是说这两家公司一定不安全,而是你的安全面扩大了。
2. 合规审查复杂度
在企业安全审计中,每个数据处理方都需要单独评估:
- 它的数据中心在哪个司法管辖区?
- 它的隐私政策是什么?
- 它有没有 SOC 2 / ISO 27001 / 等保认证?
- 它与上下游的数据处理协议(DPA)是什么?
2 跳的工具意味着安全团队需要审查两家公司的安全资质——不只是最终的模型供应商,还包括中间代理方。
3. 信任依赖链
0 跳:你只需要信任你自己的设备安全。 1 跳:你需要信任一个外部实体(模型供应商)不会滥用你的数据。 2 跳:你需要信任两个外部实体——并且它们之间的数据传输也是安全的。
信任链的每一环都可能断裂。不是一定会断,但断裂的概率随链长增加。
Embedding 的安全含义
在讨论 Cursor 的 2 跳架构时,有一个经常被问到的问题:"Embedding 向量能不能反推出原始代码?"
Embedding 是什么
Embedding 是把代码片段映射成一个高维数字向量(通常是 1536 维或 3072 维的浮点数数组)。映射方式是通过一个预训练的编码器模型(如 OpenAI 的 text-embedding-3-small)。两个语义相似的代码片段,其向量的余弦相似度会比较高。
能推断什么
能:
- 两段代码是否语义相似——如果攻击者同时拥有 Embedding 向量和一个候选代码库,可以判断哪些代码片段出现在你的项目中
- 项目的大致技术栈和领域——通过向量聚类分析,可以推断"这个项目用了 React + GraphQL"或"这是一个金融交易系统"
- 代码库的规模和结构——Embedding 的数量和分布模式可以反映项目大小
不能(在当前技术条件下):
- 精确还原代码文本——从 1536 维向量反推出具体的代码字符串,在计算上是不可行的。Embedding 是单向映射
- 还原变量名和业务逻辑细节——向量捕获的是语义特征,不是字符级信息
对什么级别的安全要求构成风险
- 一般商业软件:Embedding 泄漏的信息量有限,通常不构成直接的商业机密泄露。风险可接受。
- 金融核心系统:Embedding 可能泄漏交易策略的结构特征("这是一个高频交易系统"),对量化基金这类企业可能构成竞争情报风险。
- 军工/涉密系统:任何形式的代码信息外传——包括 Embedding——都不被允许。不是因为 Embedding 有多危险,是因为合规要求"代码不出受控环境"是绝对的。
对比表
| 维度 | 原始代码上传 | Embedding 向量 | 仅 Prompt 片段 | 全程本地 |
|---|---|---|---|---|
| 能否还原完整代码 | ✅ 是 | 不能 | ⚠️ 片段级 | 不适用 |
| 能否推断技术栈 | ✅ 是 | ⚠️ 大致可以 | ⚠️ 大致可以 | 不适用 |
| 能否推断业务逻辑 | ✅ 是 | 不能 | ⚠️ 取决于片段 | 不适用 |
| 合规风险 | 🔴 高 | 🟡 中 | 🟡 中 | 🟢 无 |
| 示例工具 | Grok Build / ZCode | Cursor | Claude Code / wescode BYOK | wescode + Ollama |
各工具的隐私承诺精确对照
每家工具都有自己的隐私承诺,但用词不同、含义不同。这张表把它们放在一起对比:
| 承诺维度 | Cursor | Copilot | Claude Code | wescode | 通义灵码 |
|---|---|---|---|---|---|
| "不用代码训练模型" | ✅ Privacy Mode 开启后 | ✅ Business/Enterprise | ✅ API 政策(不训练) | ✅ 不经过服务器 | ✅ 企业版 |
| "不存储代码" | ⚠️ Embedding 存储在后端 | ⚠️ 临时缓存用于过滤 | ⚠️ 请求保留 30 天 | 是(全部在本地) | ⚠️ 未公开细节 |
| "不经过后端" | 否(即使自带 Key 仍经过) | 否(经过 GitHub 后端) | ✅ 直连 API | ✅ 直连 API | 否(经过云端) |
| "代码不出设备" | 否 | 否 | 否(发给 Anthropic) | 支持(Ollama 模式) | 否(标准版) |
| 客户端可审计 | 闭源 | 闭源 | 闭源 | 是(基于 Code OSS) | ⚠️ 部分开源 |
| 零数据保留(ZDR) | ⚠️ 需联系申请 | ✅ Enterprise 可配 | ⚠️ 需企业合同 | ✅ 不经过服务器 | ⚠️ 需企业合同 |
重要说明:
- "不用代码训练模型"和"不存储代码"是两件事。很多用户把"不训练"理解为"不存储",但数据可以被存储用于其他目的(日志、安全审计、服务质量监控),而不用于训练。
- "不经过后端"和"代码不出设备"也是两件事。"不经过后端"意味着没有中间方,但代码仍然发给了模型供应商;"代码不出设备"意味着代码根本没有离开你的电脑。
企业安审视角:评估 AI 编程工具的 5 个维度
当企业安全团队评估一款 AI 编程工具时,跳数只是第一个维度。以下是完整的评估框架:
维度一:数据路径(跳数)
核心问题:代码从开发者电脑到被模型处理,经过了几个独立实体的服务器?
- 0 跳:最安全,全程本地
- 1 跳:需要审计一个外部实体
- 2 跳:需要审计两个外部实体及其间的数据传输
维度二:数据留存
核心问题:代码数据在每个经手节点存储多久?
- 实时处理、不持久化:最安全
- 会话期间缓存、结束后删除:可接受
- 持久存储(Embedding / 日志 / 审计):需要明确保留期限和删除机制
维度三:可审计性
核心问题:工具的客户端代码是否可以被安全团队审查?
- 开源(如 Code OSS):可自行审计
- 提供审查渠道(如企业版源码查看权限):可协商审计
- 完全闭源:只能依赖厂商的承诺
维度四:离线能力
核心问题:在完全断网环境下能否使用?
- 支持完全离线:可用于涉密环境
- 需要联网但不经中间方:可用于大多数企业
- 必须联网且经中间方:需要额外的网络安全控制
维度五:合规认证
核心问题:工具供应商有哪些安全认证?
- SOC 2 Type II / ISO 27001 / 等保三级
- 数据处理协议(DPA)/ 数据保护影响评估(DPIA)
- GDPR / CCPA / 中国《数据安全法》合规声明
各工具在 5 个维度的评估
| 维度 | Cursor | Copilot | Claude Code | wescode (BYOK) | wescode (Ollama) | 通义灵码 |
|---|---|---|---|---|---|---|
| 跳数 | 2 | 2 | 1 | 1 | 0 | 2 |
| 数据留存 | Embedding 持久化 | 会话级缓存 | API 请求保留 30 天 | 仅供应商侧 | 无外部留存 | 未公开 |
| 可审计性 | 闭源 | 闭源 | 闭源 | Code OSS 开源 | Code OSS 开源 | ⚠️ 部分 |
| 离线能力 | 否 | 否 | 否 | 否(需连模型 API) | 支持 | 否 |
| 合规认证 | SOC 2 | SOC 2, ISO 27001 | SOC 2 | 不适用(无中间方) | 不适用 | 等保三级 |
说明:wescode 在 BYOK 和 Ollama 模式下,"合规认证"标注为"不适用"——不是因为它不安全,而是因为当你的代码不经过 wescode 的任何服务器时,wescode 不是数据处理方,不需要为数据处理行为提供认证。你需要审查的是模型供应商的合规认证(BYOK 模式下)或你自己的设备安全(Ollama 模式下)。
一个容易被忽略的问题:代码在 Prompt 里
很多开发者关注"工具有没有上传我的代码",但忽略了一个更基本的事实:
每一次 AI 编程对话,你的代码片段都作为 Prompt 的一部分发送给了模型。
当你在 Cursor 里问"帮我重构这个函数",Cursor 会把这个函数的代码——以及它认为相关的上下文代码——放进 Prompt 发送给 OpenAI。这不是 bug,这是 AI 编程工具的基本工作原理。模型不读你的代码就无法给你建议。
区别在于:
- 谁组装这个 Prompt——是在你电脑上组装(wescode / Claude Code),还是在远程服务器上组装(Cursor / Copilot)
- Prompt 发给了谁——是直接发给模型供应商(1 跳),还是先经过一个中间方(2 跳)
- Prompt 之外还发了什么——只发了对话需要的代码片段,还是额外上传了 Embedding / 整库 / Git 历史
所以"代码安全"不是一个二元问题。不是"安全 vs 不安全",而是一个程度和场景的问题。每个开发者和每个企业需要根据自己的安全需求,选择合适的跳数和数据路径。
信息来源汇总
| # | 来源 | 类型 | URL |
|---|---|---|---|
| 1 | Cursor Privacy FAQ | 官方文档 | cursor.com |
| 2 | Cursor "requests routed through backend" 声明 | 官方文档 | cursor.com/privacy |
| 3 | GitHub Copilot Trust Center | 官方文档 | github.com |
| 4 | Anthropic API 数据使用政策 | 官方文档 | anthropic.com |
| 5 | wescode 技术架构(Code OSS + CKG + BYOK) | 产品文档 | weisyn.com |
| 6 | Ollama 官方文档 | 官方文档 | ollama.com |
| 7 | 通义灵码隐私政策 | 官方文档 | tongyi.aliyun.com |
本文信息截至 2026 年 10 月。如各方后续发布更新或澄清,请以最新信息为准。