AI 说已修改,文件却一个字没变
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
你让 AI 帮你改一段代码。它处理了几秒,说"已完成修改"。
你打开文件一看——跟之前一模一样。一个字都没变。
你又说了一遍"帮我改掉第 47 行的那个 bug"。AI 又处理了一遍,又告诉你"已修改"。
文件还是没变。
为什么会这样
AI 编辑代码的过程不是"直接改文件"。它分两步:
- AI 生成一段"要替换什么"和"替换成什么"(模型输出)
- 工具在文件里找到"要替换的那段",把它换掉(定位落地)
第一步通常没问题——模型确实生成了正确的改动。出问题的是第二步。
AI 给出的"要替换的原文"和文件里的实际内容之间,往往有微小差异——多一个空格、少一个换行、Tab 和空格混用、Windows 和 Mac 的换行符不同。这些差异人眼看不出来,但字符串匹配认为它们不一样。
工具在文件里搜"要替换的那段",搜不到(因为有不可见的差异),于是什么都不做——但它不一定会告诉你匹配失败了。从 AI 的视角看,它确实发出了修改指令;从工具的视角看,找不到该替换的位置,默默跳过了。
你看到的就是:AI 说改好了,文件没变。
这有多常见
实测数据显示(内部测试数据),约 50% 的 AI 编辑在首次尝试时面临匹配挑战。按差异类型分布:
| 差异类型 | 示例 | 出现频率 |
|---|---|---|
| 缩进差异 | AI 输出 4 空格,文件用 Tab | ~15%(内部测试数据) |
| 行尾空白 | 行末有/无不可见空格 | ~10%(内部测试数据) |
| 换行符不一致 | AI 输出 LF,文件是 CRLF | ~5%(内部测试数据) |
| 空行差异 | 函数间 1 空行 vs 2 空行 | ~8%(内部测试数据) |
| 格式化漂移 | Prettier/ESLint fix 重排了空白 | ~12%(内部测试数据) |
这不是偶发 bug,而是结构性问题——AI 模型输出文本时不保留原始文件的空白细节。
那些"看不见"的匹配失败
光看上面的表格可能觉得抽象。来看几个你一定遇到过的场景:
场景 1:Tab 和空格混用
// 文件实际内容(用 Tab 缩进,你的编辑器显示成 4 格)
function getUser(id: string) {
→   const user = await db.users.findUnique({ where: { id } })
→   if (!user) throw new AppError('USER_NOT_FOUND')
→   return user
}

// AI 输出的 old_text(用 4 个空格,因为模型训练数据大多是空格)
function getUser(id: string) {
    const user = await db.users.findUnique({ where: { id } })
    if (!user) throw new AppError('USER_NOT_FOUND')
    return user
}
在你的编辑器里,这两段代码看起来一模一样。但一个用 Tab(→),一个用空格(·)。字符串匹配:不等。编辑失败。
场景 2:Windows 换行符
// 文件实际内容(Windows CRLF,\r\n 结尾)
const config = {\r\n
  port: 3000,\r\n
  host: 'localhost',\r\n
}\r\n

// AI 输出(Unix LF,\n 结尾)
const config = {\n
  port: 3000,\n
  host: 'localhost',\n
}\n
你在 VS Code 里完全看不出区别——编辑器会自动渲染换行。但每一行都多了一个 \r,字符串匹配完全失败。这在 Windows + Mac 混合开发的团队里极其常见。
场景 3:注释位置漂移
// AI 记忆中的代码
export async function createOrder(data: CreateOrderInput) {
  // 验证输入
  validateInput(data)
  // 创建订单
  const order = await orderRepo.create(data)
  return order
}

// 实际文件(你昨天删了一行注释、加了一行空行)
export async function createOrder(data: CreateOrderInput) {
  validateInput(data)

  // 创建订单
  const order = await orderRepo.create(data)
  return order
}
函数逻辑完全一样,但"验证输入"的注释被删了、多了一个空行。精确匹配失败——AI 怎么也找不到它记忆中的那段代码。
每次匹配失败的真实代价
匹配失败不只是"再来一次"。每轮重试的 token 消耗:
read()       → ~2K tokens(重新读取文件内容)
LLM 推理     → ~1K tokens(分析错误 + 重构编辑指令)
edit() 再试  → ~0.5K tokens(tool call)
──────────────
合计: ~3.5K tokens / 每次重试
一个真实任务的 token 浪费:
假设一次重构任务涉及 10 次编辑操作:
| 状况 | 编辑次数 | 失败次数 | 重试轮数 | 浪费的 token | 浪费的时间 |
|---|---|---|---|---|---|
| 理想情况 | 10 | 0 | 0 | 0 | 0 |
| 普通工具(50% 成功率) | 10 | 5 | 每次 1-2 轮 | ~26K tokens | ~2-3 分钟等待 |
| 严重情况(老项目、混合格式) | 10 | 7 | 每次 2-3 轮 | ~56K tokens | ~5-7 分钟等待 |
更严重的是流程中断:Agent 在执行多步计划时,中间的 edit 失败会打断它的"思路"。它需要从修复匹配错误开始,重新回忆自己在做什么——这个"恢复上下文"的过程本身又消耗 token。一次编辑失败引发的连锁反应,可能比编辑本身的 token 消耗还高。

各工具的处理方式
| 工具 | 匹配失败时怎么处理 | 用户体验 |
|---|---|---|
| Cursor / Copilot | 精确字符串匹配,失败时静默跳过或报模糊错误 | "AI 说改了但没改"或"编辑未能应用" |
| Claude Code | 直接写文件系统,绕过匹配 | 不做替换就不怕匹配失败——但覆盖编辑器里未保存的改动 |
| 通义灵码 / Trae | 精确匹配为主,有限的空白容错 | 匹配失败时提示"无法定位修改位置" |
| wescode | 三级匹配策略:精确 → 归一化 → 语法树 | 97% 的情况一次成功(内部测试数据),失败时告诉你具体原因 |
Claude Code 的"直接写文件"策略值得单独说一下。它绕过了匹配问题,但带来了另一个问题——如果你在编辑器里有未保存的修改,Claude Code 写文件会直接覆盖掉你的改动。你在编辑器里改了 5 分钟,Claude Code 一个 write() 全没了。这不是匹配策略的问题,是"用编辑器改"还是"直接改文件"的架构选择。
wescode 的三级匹配——逐级放宽、逐级兜底
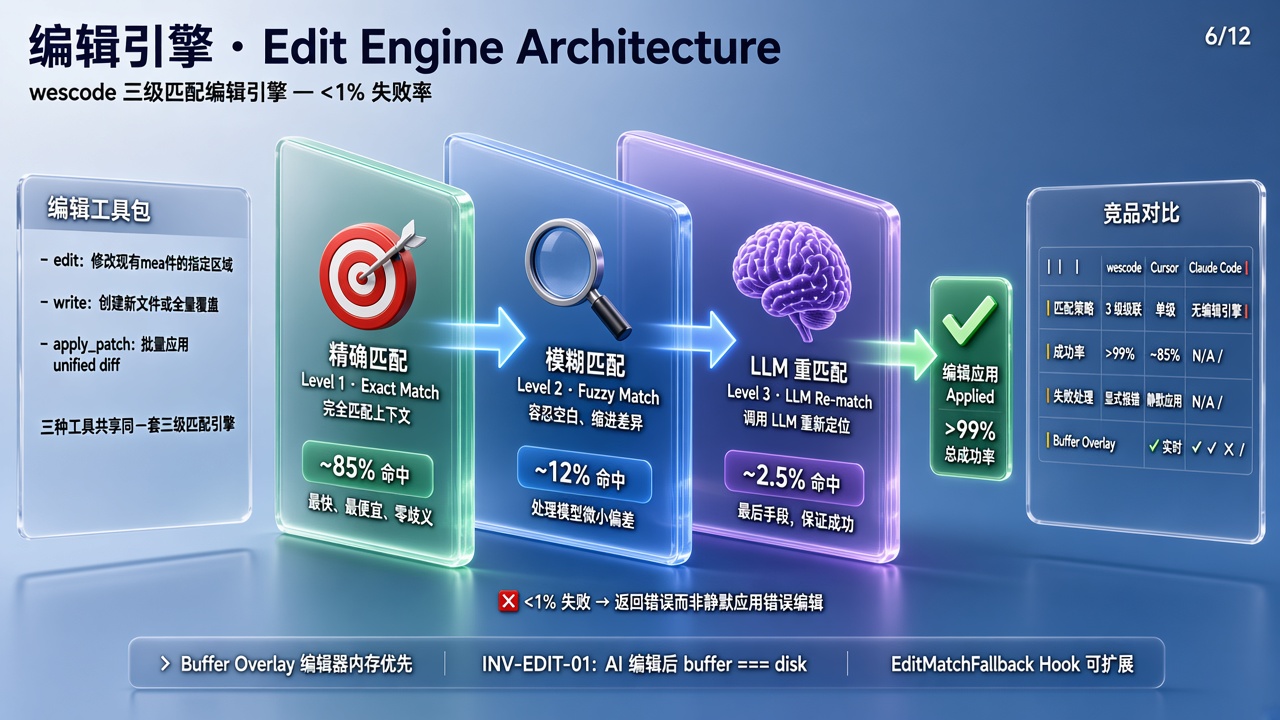
第一级:精确匹配(Exact Match)
做法:old_text 和文件内容做逐字节比较,找到完全一致的位置。
所有编辑工具都做这一步,没什么特别的。唯一值得一提的是唯一性检查——如果 old_text 在文件中出现了两次,不盲目替换第一个,而是返回歧义错误。
耗时:<1ms。命中率:约 50%(内部测试数据)。
第二级:归一化匹配(Fuzzy Match)——大多数问题在这里解决
第一级失败后,把 old_text 和文件内容都做规范化处理,消除不可见差异后再比较。
归一化的每一步做了什么:
| 步骤 | 做了什么 | 为什么要做 | 做完之后什么变了 |
|---|---|---|---|
| Tab → 空格 | 把所有 Tab 替换为空格(个数根据项目 .editorconfig 或文件推断的缩进宽度决定) | AI 模型普遍输出空格,但很多老项目用 Tab | Tab 与空格的缩进现在逐字节相等 |
| CRLF → LF | 统一换行符为 LF | Windows 文件用 CRLF,AI 模型和 Mac/Linux 用 LF | 每行末尾的 \r 被消除 |
| 行尾空白去除 | 删除每行末尾的不可见空格/Tab | VS Code 的 files.trimTrailingWhitespace 和 format on save 经常添加或删除行尾空白 | 两边末尾空白都没了,不会因为多一个看不见的空格而匹配失败 |
| 连续空行压缩 | 多个连续空行压缩为一个空行 | 不同编辑器对"函数间空几行"的设定不同,AI 模型也不稳定 | \n\n\n 和 \n\n 现在等价 |
归一化后再做第一级匹配。关键设计:归一化只用于定位——找到"大概是这个位置"之后,替换操作仍然作用于原始文件的原始空白。这确保了编辑不会改变文件本身的格式风格。
举个例子:你的文件用 Tab 缩进,AI 输出空格缩进。归一化后定位到正确位置,但替换时保留 Tab——编辑完成后文件仍然是 Tab 缩进。不会因为修了一个 bug 就把全文件的缩进格式改了。
为什么这些差异最常见:VS Code 的 format on save、Windows/Mac 混合开发团队、AI 模型不保留原始空白——这三个场景覆盖了日常开发的绝大部分情况。
耗时:<5ms。命中率:在第一级失败的剩余 50% 中,再命中约 35%。也就是说,前两级加起来解决了约 85% 的编辑匹配(内部测试数据)。
第三级:语法树匹配(AST Structural Match)——处理大结构差异
当代码被格式化插件整段重排过,前两级文本匹配都失败时,第三级用 tree-sitter 在语法结构层面定位。
tree-sitter 是什么:一个增量解析器,能把源代码解析成语法树(AST)。和你用 JSON.parse() 把 JSON 字符串变成对象一样,tree-sitter 把 TypeScript/Python/Go 源码变成树形结构。
具体步骤:
- 用 tree-sitter 解析
old_text,得到 AST 片段 A - 用 tree-sitter 解析整个文件,得到 AST 树 T
- 在 T 中搜索与 A 结构等价的子树——匹配的是节点类型和关键标识符(函数名 + 参数名 + 返回类型),不是文本排版
- 找到唯一匹配 → 用该节点的字节范围定位替换位置
- 找到多个匹配 → 返回歧义错误(不猜)
一个具体例子说明为什么需要 AST:
// AI 记忆的 old_text(旧格式,参数在一行)
function processOrder(
  orderId: string, userId: string, options: ProcessOptions
): Promise<OrderResult> {
// 文件实际内容(Prettier 重排后,参数拆成多行)
function processOrder(
  orderId: string,
  userId: string,
  options: ProcessOptions,
): Promise<OrderResult> {
参数从一行变成了三行,多了一个尾逗号。文本匹配完全失败——即使归一化了空白,行结构都不一样。但 tree-sitter 解析后,两段代码的 AST 结构是完全等价的:
function_declaration
├── name: "processOrder"
├── parameters
│   ├── parameter: orderId (string)
│   ├── parameter: userId (string)
│   └── parameter: options (ProcessOptions)
└── return_type: Promise<OrderResult>
AST 匹配找到这个等价节点,拿到它在文件中的字节范围,精确定位替换位置。
能处理什么:
- 代码被 Prettier / gofmt 整段重排(缩进、换行位置完全变了,但语法结构没变)
- 注释被删除或修改导致行号偏移
- 空行和空白被编辑器插件大规模调整
不能处理什么:
- 函数被重命名了(语法结构变了,不是格式差异)
- 函数被拆分成多个(原来的节点不存在了)
- 文件结构被彻底重写
耗时:<50ms(两次 tree-sitter 解析 + 子树搜索)。命中率:在前两级失败的剩余 15% 中,再命中约 12%(内部测试数据)。
三级加起来的总成功率:约 97%(内部测试数据)
| 级别 | 匹配方式 | 耗时 | 处理什么差异 | 累计命中率 |
|---|---|---|---|---|
| 第一级 | 精确字节匹配 | <1ms | 内容完全一致 | ~50%(内部测试数据) |
| 第二级 | 归一化后匹配 | <5ms | Tab/空格、CRLF/LF、行尾空白、空行差异 | ~85%(内部测试数据) |
| 第三级 | tree-sitter 结构匹配 | <50ms | 格式化重排、注释变化、空白大规模调整 | ~97%(内部测试数据) |
三级都失败时怎么办
三级全部失败 → 返回明确的错误信息给 Agent,说的不是"编辑失败"这种笼统话,而是:
- 是匹配失败(不是网络错误、不是权限问题)
- 是哪一级失败的(附带诊断信息:差异类型、最接近的候选位置)
- Agent 根据诊断信息决定下一步——重新 read 文件获取最新内容,或者改用 write 整文件覆盖
不假装成功。不默默跳过。失败就是失败,告诉你为什么失败。
你能做什么
不管用什么工具,几个降低"改了又没改"概率的习惯:
- 统一换行符——
.editorconfig配好end_of_line = lf,全项目统一 - 统一缩进——Tab vs Space 不要混用,
.editorconfig配好 - 关掉 format on save——或者确保 AI 改完之后、你检查之前没有自动格式化跑过(格式化会改变空白,导致 AI 下一次改动匹配不上)
- AI 说改好之后,切到 diff 视图确认一下——Git diff 会明确告诉你改了什么。如果 diff 是空的,说明没改成功
这些都是治标。治本是工具层面要容忍不可见差异而不是精确匹配——wescode 的三级匹配就是这个思路:精确匹配兜底常规情况,归一化消化 85% 的空白差异,语法树兜底格式化重排,三级都失败时明确告诉你原因。