它写的代码能跑,但和我们项目的写法完全不像
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
你让 AI 写一个新的接口。它写了。能跑。类型也对。
但你一看就知道不对劲:
- 项目里所有错误都用自定义的
AppError类,AI 用了原生Error - 项目里数据库操作都走 Repository 层,AI 直接在 Service 里写了 SQL
- 项目里 import 语句的顺序有约定(第三方包 → 内部包 → 相对路径),AI 的顺序是随机的
- 项目里的变量命名用 camelCase,AI 在某些地方用了 snake_case
编译器不管这些。测试也不管。 它们只管"能不能跑"和"结果对不对"。
至于"和项目风格一致吗"——那是你自己的事。
这些"不像"为什么重要
"风格不一致"听起来像是强迫症。但在一个多人维护的项目里,它是实打实的成本:
1. Code Review 的时间变长
你的同事看到 AI 生成的代码,第一反应是"这不像我们项目的风格"——然后他要逐行检查哪些是功能改动、哪些是风格差异。风格差异混在功能改动里,review 效率直线下降。
2. 后来者看不懂
三个月后有人改这段代码,发现它和周围的代码风格不一样——"这段是谁写的?为什么不一样?是有特殊原因还是就是随手写的?"他不敢改,因为怕有他不知道的原因。
3. 有些"风格"其实是逻辑
这是最容易被低估的一点。看几个例子:
例子 A:错误处理惯例 = 中间件路由
"错误都用 AppError 包装"不只是风格——上游有一个中间件专门 catch AppError 做分类处理:
// error-handler.ts — 全局中间件
app.use((err, req, res, next) => {
  if (err instanceof AppError) {
    // AppError 有 code 和 httpStatus
    return res.status(err.httpStatus).json({
      code: err.code,
      message: err.message,
    })
  }
  // 非 AppError → 500
  return res.status(500).json({ code: 'INTERNAL_ERROR' })
})
你换成原生 Error,中间件 instanceof AppError 判断失败,直接走 500 分支——用户看到一个"内部错误",而实际上只是参数校验不过。
例子 B:分层约定 = 审计追踪
"数据库操作走 Repository 层"不只是分层洁癖——审计日志挂在 Repository 的方法上:
// user-repository.ts
class UserRepository {
  async update(id: string, data: Partial<User>): Promise<User> {
    const result = await this.db.users.update(id, data)
    await this.auditLog.record('user.update', { id, changes: data })
    return result
  }
}
直接在 Service 里写 SQL,这次操作就没有审计记录。合规审计的时候一查——"这次修改没有记录",然后你花一天排查是什么时候丢的。
例子 C:命名惯例 = 序列化契约
// 项目里所有 API 响应字段用 camelCase
interface UserResponse {
  userId: string
  firstName: string
  createdAt: string
}

// AI 写的一个新接口用了 snake_case
interface OrderResponse {
  order_id: string    // 前端严格校验会拒绝这个响应
  total_amount: number
}
前端有一个全局的响应校验中间件,对着 camelCase 的 schema 做严格匹配。snake_case 的字段直接被拒——接口返回了数据,前端却显示空。
例子 D:import 顺序 = 依赖可见性
// 项目约定:第三方包 → 内部包 → 相对路径
import express from 'express'           // 第三方
import { AppError } from '@app/errors'   // 内部包
import { validate } from './utils'       // 相对路径

// AI 写的:随机顺序
import { validate } from './utils'
import express from 'express'
import { AppError } from '@app/errors'
看起来只是排列顺序?有些团队用自定义的 ESLint 规则强制 import 顺序,CI 直接不过。更隐蔽的情况是——某些打包工具对 import 顺序敏感(CSS-in-JS 的样式覆盖就和 import 顺序有关),改了顺序可能导致样式不对。
这些不是风格问题,是隐性的功能约束。但它们长得和风格问题一模一样——只有了解项目历史的人才知道区别。
AI 为什么写不出"你们的风格"
两个原因:
1. AI 没读过你所有的代码
向量检索找到和当前任务最相关的几段代码给 AI 看。AI 就从这几段里学到"项目的风格"。但如果这几段里恰好有一段是别人不小心写的不规范代码(每个项目都有),AI 就学到了错的样板。
2. 隐性规矩没有标准格式
"错误用 AppError"、"数据库走 Repository"——这些约定存在于团队的口头传承和 PR review 的反馈里。它们没有被写进任何配置文件、没有 lint 规则检查、没有编译器会报错。
你可以写进 .cursorrules / CLAUDE.md——但你能写全吗?一个五年的项目里这类规矩通常有上百条。你能写出来的可能不到二十条。
ESLint 为什么管不了这件事
你可能想:这不就是 ESLint 干的事吗?
不一样。ESLint 和 CSE 解决的是两个层面的问题。
| 维度 | ESLint / Prettier | wescode CSE |
|---|---|---|
| 规则来源 | 你手动写 .eslintrc,告诉它规则是什么 | 零配置——从项目代码里自动统计发现规则 |
| 检查范围 | 语法层面:分号、引号、缩进、未使用变量 | 业务层面:错误处理惯例、模块边界、API 契约一致性 |
| 能表达什么 | "不允许使用 var""字符串用单引号" | "所有数据库操作走 Repository""catch 块统一用 AppError" |
| 不能表达什么 | "所有 *Repository 只在 *Service 里被引用"这种跨文件的结构规则 | 不是替代 ESLint——语法层面的事 ESLint 已经做得很好 |
| 维护成本 | 配置文件要写、要维护、要跟着项目演进更新 | 不需要配置文件,统计结果随代码变化自动更新 |
ESLint 是"你告诉它规则是什么,它按规则检查"。CSE 是"它从代码里自己发现规则是什么"。
举个具体例子:
// ESLint 能做到的:
// .eslintrc: "no-var": "error" → 禁止使用 var
// .eslintrc: "quotes": ["error", "single"] → 字符串用单引号

// ESLint 做不到的:
// "所有 *Repository 类只在 *Service 类里被引用"
// "catch 块里必须用 AppError 而不是原生 Error"
// "导出函数的参数个数不能比之前多"
第一组是语法规则——ESLint 的表达能力完全覆盖。第二组是跨文件的结构和业务规则——超出了 ESLint 的表达能力。CSE 从 import 图和 AST 统计里发现第二组规则,和 ESLint 互补而不是替代。
CSE 怎么发现"项目的规矩"
CSE(Constraint Satisfaction Engine,约束满足引擎)的工作原理不是猜测——是统计。它扫描项目代码,从实际的编码模式中推导出惯例。
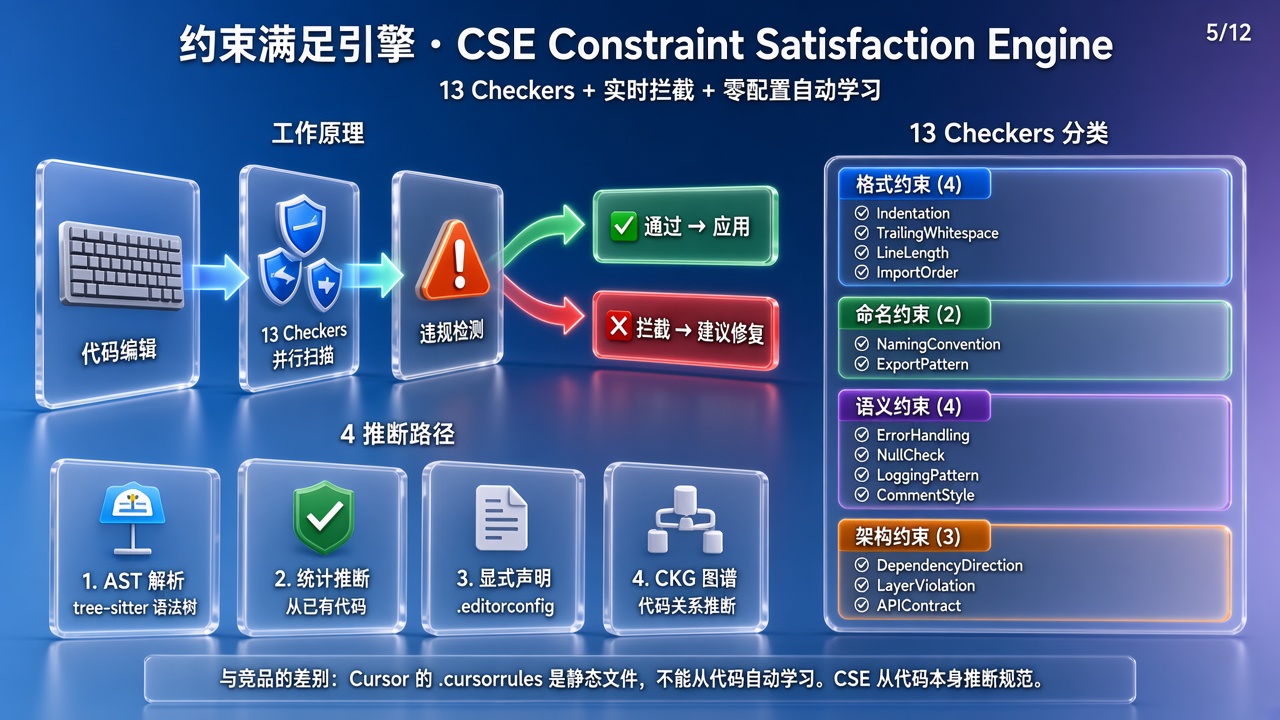
13 个 Checker 覆盖什么
CSE 有 13 个可执行的 Checker,按严格程度分为 5 类:
| 类别 | 严格程度 | 代表性 Checker | 检查什么 |
|---|---|---|---|
| 安全 | 最严格(违反即阻塞) | plaintext_secret / sql_concat | 字面量赋给密码变量 / SQL 字符串拼接变量 |
| 数据完整性 | 高 | — | 数据操作的完整性约束 |
| 架构 | 中 | import_cycle / signature_stable | import 循环 / 导出函数签名变化 |
| 代码质量 | 中 | err_discard / no_panic / nplus1 / goroutine_capture | error 被 _ 丢弃 / 非 main 代码 panic / 循环内查询 / 闭包捕获循环变量 |
| 一致性 | 最宽松(可有意例外) | exported_doc | 导出符号缺注释 |
Checker 不是人工写死的规则列表——它们是可机械判定的谓词。给一个代码 diff,Checker 输出 PASS 或 FAIL,零 LLM 推理,零歧义。
4 条推断路径——CSE 怎么"学会"你的项目规矩
CSE 发现规矩的方式有 4 条路径,从启动到运行持续积累:
路径 1:种子约束(编译期固定,冷启动即可用)
打开项目就有的基础检查——不需要索引,不需要等 CKG 建完。比如 plaintext_secret(密码变量不能赋字面量)、sql_concat(SQL 里不能拼接变量)。这是地板,保证 CSE 开箱就能工作。
具体例子:
// plaintext_secret 检测到这个:
const dbPassword = "admin123"  // 问题:字面量赋给密码变量

// sql_concat 检测到这个:
const query = `SELECT * FROM users WHERE id = ${userId}`  // 问题:SQL 拼接
路径 2:项目统计推断(自动,核心路径)
扫描项目代码的 AST 和 import 图,统计出模式。这是 CSE 最核心的能力——不需要你写任何配置:
| 推断方式 | 看什么 | 发现什么 | 举例 |
|---|---|---|---|
| 统计模式 | 遍历所有 catch 块 | 95% 用了 AppError → 这是惯例 | AI 用原生 Error → 标记违反惯例 |
| 结构模式 | 分析 import 图的边 | 所有 *Repository 只在 *Service 里被引用 → 模块边界 | AI 在 Controller 里直接引用 Repository → 标记违反模块边界 |
| 签名模式 | 比对导出函数签名 | 函数 arity(参数个数和类型)稳定不变 → API 契约 | AI 修改后参数个数变了 → 标记签名变化 |
| 依赖模式 | Tarjan 强连通分量 | import 图中存在循环 → 架构问题 | AI 新增的 import 形成了循环依赖 → 阻塞 |
统计推断的关键细节:它不需要 100% 一致才生成规则。95% 的 catch 块用 AppError 就够了——那 5% 可能是有意的例外。CSE 标注的是"偏离了多数模式",不是"违反了绝对规则"。
这些推断随 CKG 索引进度分级激活——索引建到 30% 就开始部分推断,不需要等全部建完。
路径 3:L2.5 行为回归学习(自动)
验证系统(L2.5)检测到行为回归时,如果回归原因是"导出函数签名变了",自动注册一条 signature_stable 约束。下次有人改同一个函数时,CSE 会提前检查签名是否变化。
路径 4:用户教学(你的操作驱动)
你拒绝或修改了 AI 的编辑 → CSE 分析 diff,看能不能反推出规矩。比如你把 AI 写的 throw new Error('not found') 改成了 throw new AppError('NOT_FOUND', 404)——CSE 学到"这个项目的 catch 分支用 AppError"。
4 条路径的关系:路径 1 是地板(冷启动),路径 2 是主力(覆盖 80%),路径 3 和 4 是飞轮加速器(越用越准)。
一个完整的 before/after 流程
看一个 CSE 从检测到修正的完整过程:
场景: 你让 AI 写一个用户删除接口。
AI 生成的代码(before):
// user-service.ts — AI 写的
async function deleteUser(id: string) {
  // 直接在 Service 里写 SQL(违反分层约定)
  await db.query('DELETE FROM users WHERE id = $1', [id])

  // 用原生 Error(违反错误处理惯例)
  if (!id) throw new Error('id is required')

  // 没有返回值类型注解(违反导出函数规范)
  return { success: true }
}
CSE 标注了三个问题:
⚠️ [模块边界] db.query() 直接调用——项目中 95% 的数据库操作通过 *Repository 类(内部测试数据)
⚠️ [错误处理] throw new Error()——项目中 93% 的 throw 使用 AppError(内部测试数据)
⚠️ [签名规范] 导出函数缺少返回值类型注解——项目中 88% 的导出函数有明确返回类型(内部测试数据)
修正后的代码(after):
// user-service.ts — 修正后
async function deleteUser(id: string): Promise<DeleteResult> {
  if (!id) throw new AppError('INVALID_INPUT', 400, 'id is required')

  return this.userRepository.delete(id)
  // Repository.delete 内部已有审计日志
}
三行问题全部解决。而这三个问题里有两个——分层和错误处理——不只是风格,是功能(审计日志和中间件路由)。
CSE 和 ESLint 的详细能力对比

| 能力 | ESLint | CSE | 说明 |
|---|---|---|---|
| 语法风格(分号、引号、缩进) | ✅ | 不覆盖 | CSE 不替代 ESLint 的语法检查 |
| 未使用变量 / 未使用 import | ✅ | 不覆盖 | 同上 |
| import 顺序 | ✅(需配置插件) | 不覆盖 | ESLint 已经做得够好 |
| 跨文件模块边界 | 无法表达 | 支持(import 图统计) | *Repository 只在 *Service 里引用 |
| 错误处理惯例 | ⚠️ 需要自定义规则 | 支持(自动统计发现) | catch 块用 AppError 还是原生 Error |
| 导出函数签名稳定性 | 不支持 | 支持(signature_stable) | 参数个数或类型变了自动标注 |
| SQL 注入风险 | ⚠️ 需要安全插件 | 支持(sql_concat 内置) | 字符串拼接 SQL 变量 |
| 密码硬编码 | ⚠️ 需要安全插件 | 支持(plaintext_secret 内置) | 密码变量赋字面量 |
| 循环依赖 | ⚠️ 需要插件 | 支持(import_cycle 内置) | Tarjan 强连通分量检测 |
| 零配置 | 不支持(必须写 .eslintrc) | 支持(从代码统计推导) | CSE 不需要配置文件 |
最好的组合不是二选一,而是两个都用: ESLint 管语法层面的硬规则(分号、引号、缩进),CSE 管业务层面的统计惯例(模块边界、错误处理、签名稳定性)。
CSE 的能力边界
CSE 基于统计,有几件事它做不了:
1. 有业务原因但代码里看不出来的约束
"数据库走 Repository 因为审计日志挂在那"——CSE 能发现"数据库操作都走 Repository"这个模式,但它不知道原因是审计日志。如果某天有人有合理理由直接写 SQL(比如批量迁移脚本),CSE 会标注但不知道这是合理的例外。
2. 有意的例外
项目里 95% 的 catch 块用 AppError,你在一个工具函数里有意用了原生 Error——CSE 会标出来。你确认"这是有意的" → CSE 不再对这处提醒。Confidence 衰减机制:一条约束如果长时间没有被触发验证,其置信度会自然衰减,最终被淘汰。
3. 全新的模式
如果项目刚引入了一个新框架,还没有足够的代码形成统计模式——CSE 在样本不够时不会强行推断。它会等积累到足够的样本(通常 5+ 个同类实例)才开始标注。
CSE 不声称自己 100% 正确。 它声称的是:统计覆盖 80% 的编码惯例,你只需要处理 20% 的例外和边界情况。比起手写 100 条 .cursorrules 然后祈祷没漏掉——这个折中更现实。
两种对策的组合
对策一:手写规则文件(覆盖有业务原因的约束)
.cursorrules(Cursor)/ CLAUDE.md(Claude Code)/ .github/copilot-instructions.md(Copilot)。
把你能想到的规矩写进去。AI 每次新对话都会读这个文件。
有用,但有限。 你写不全、规矩在变文件不跟着变、简化版的规矩缺少上下文——"用 AppError"写了,"因为中间件 catch 它做分类"没写,AI 遇到新场景就可能自作主张绕过去。
对策二:从代码里自动推导(覆盖统计可发现的惯例)
wescode 的 CSE 走这条路。打开项目就开始扫描,不需要你写任何规则文件。AI 生成的代码如果违反了统计出来的模式,自动标注——"这里用了原生 Error,但项目里 95% 的地方用 AppError"。
不完美——它基于统计,有误报。它也只能检测代码层面可统计的模式,对"数据库走 Repository 因为审计日志挂在那"这种业务原因的约束,推导不出背后的原因(但能推导出模式本身)。
最好的组合:CSE 自动推导覆盖 80% 的编码惯例(你不用管),规则文件覆盖 20% 的业务约束(你只需要维护最关键的那几条)。维护量从"想全 100 条约定"降到"写清楚 20 条有业务原因的规矩"。
你能做什么
- 不管用什么工具,至少写一个最小规则文件——把最容易出错的 5-10 条约定写进去。不求全,但求覆盖"违反了会出 bug"的那几条
- PR Review 时关注风格差异——如果 AI 的代码风格和周围不一致,不要只改风格——想想"这是纯风格还是有功能原因"
- 新人入职时多说两句"为什么"——"错误用 AppError"不够,要说"错误用 AppError,因为 middleware 会 catch 它做分类"。有"为什么"的约定更不容易被忽略——不管是被人还是被 AI 忽略
如果你不想手动维护一份 100 条的规则文件——wescode 的 CSE 帮你自动推导大部分。你只需要维护那些有业务原因的少数几条。