同一个要求说三遍,问题真的在提示词吗
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
"我们项目用 Prisma 做 ORM,不要写原生 SQL。"
你上周说了。AI 乖乖用了 Prisma。
今天新开一个对话,让它写一个查询。它给你写了一段原生 SQL。
你又说了一遍。它改了。
明天你再开一个对话。它又写了原生 SQL。
代码说话:这就是每天在发生的事
你让 AI 写一个查询用户订单的接口。你说了"我们用 Prisma",但你是在上一次对话里说的。
// 你期望的写法——Prisma,团队规范
const orders = await prisma.order.findMany({
  where: { userId, status: 'pending' },
  include: { items: true },
  orderBy: { createdAt: 'desc' },
})
// AI 给你写的——原生 SQL,编译通过,测试通过,但不符合团队规范
const result = await db.query(`
  SELECT o.*, oi.*
  FROM orders o
  LEFT JOIN order_items oi ON o.id = oi.order_id
  WHERE o.user_id = $1 AND o.status = 'pending'
  ORDER BY o.created_at DESC
`, [userId])
两段代码都能跑。但第二段代码提 PR 时,reviewer 一句"我们不写原生 SQL",你又得改一遍。
更糟的情况:reviewer 没注意到(或者这段代码没走 review),原生 SQL 就混进了代码库。几个月后,你换数据库或者升级 Prisma,它炸了。
你以为的原因 vs 实际的原因
你以为:我的提示词写得不够好。应该加个前缀说"记住,我们用 Prisma"。
实际:它根本就不记得。每次你开一个新对话,之前所有的对话内容全部清零。不管你说得多明确,不管 AI 回答得多好——关掉对话窗口,一切从头来过。
这不是模型笨。模型在一次对话里是能记住的——你说了"用 Prisma",后面它会一直用 Prisma。但对话结束就结束了。下一次对话是一段全新的上下文,跟上一次的对话没有任何数据层面的关联。
你试过在提示词开头加"永远记住以下规则:……"——但那只在本次对话有效。你试过把规矩写进项目 README——但 AI 不一定会读 README,即使读了也不一定放在优先级最高的位置。
你正在花时间做一件工具该做的事
算一笔账。
假设你每天新开 5-8 次对话(实际重度用户可能更多)。每次对话开始,你至少要重复一两条项目基本信息——"我们用 TypeScript""后端是 Express""错误处理用 AppError 类"之类。
每次 30 秒到 1 分钟。
一天 5 分钟。一周 25 分钟。一年大约 20 小时——整整两个半工作日,花在一遍遍告诉 AI 同样的事情上。
而且这还不算"AI 因为不知道某条规矩而写错、你发现并纠正"所花的时间。那个成本更高——因为你得:
- 发现问题(review 时才看到,有时候上线后才发现)
- 定位是哪条规矩被违反了
- 纠正 AI 的输出
- 验证纠正后的代码
每一次纠正循环至少 3-5 分钟。你每天纠正几次?
主流工具的"记忆"到哪一步了
| 方案 | 做了什么 | 没做什么 |
|---|---|---|
Cursor .cursorrules | 每次新对话自动加载这个文件里的规矩 | 你得自己写、自己维护、自己想全 |
Claude Code CLAUDE.md | 同上 | 同上 |
Copilot copilot-instructions.md | 同上 | 同上 |
Cursor @Past Chats | 手动引用之前某次对话 | 你得记住在哪次对话里说过什么 |
| 通义灵码 | 有一定的代码风格学习 | 不可控,不透明 |
| Trae | 无独立记忆机制 | — |
共同的问题是:这些都是手动的。你得写规则文件、你得手动 @ 历史对话、你得记住项目的每一条约定。
如果你漏了一条——比如"分页接口统一返回 { data, total, page, pageSize }"——AI 就不知道,然后写出一个返回 { items, count } 的接口。编译通过,测试通过,上线后前端解析报错。
另一个问题是维护成本。你的项目是活的——上周决定用 moment.js,这周改成了 dayjs。你得去改规则文件。但你总会忘——因为"改了技术选型之后去更新规则文件"这件事,不在任何工作流里。
wescode 的认知结算:对话结束自动提炼,下次自动带入
问题不出在你的措辞上。问题出在——你说过的事,工具没帮你存下来。
wescode 的做法叫认知结算(Cognitive Settlement):每次对话结束时,主对话模型(不是另一个辅助模型)自动回顾整段对话,提炼出关键认知——项目约定、你的偏好、架构决策、你做过的纠正——存入长期记忆。下次新对话,这些记忆自动注入系统提示词。
具体流程
对话进行中:你告诉 AI "我们用 Prisma,不要写原生 SQL"
           ↓
对话结束时:主模型自动提炼
           → 事实:"ORM 用 Prisma,不写原生 SQL"
           → 偏好:"moment.js 不用,改用 dayjs"
           → 决策:"REST API 迁移到 tRPC"
           → 纠正:"分页返回 { data, total, page } 不是 { items, count }"
           ↓
存入长期记忆(本地 SQLite,按项目物理隔离)
           ↓
下次新对话:自动加载到系统提示词,不占上下文窗口
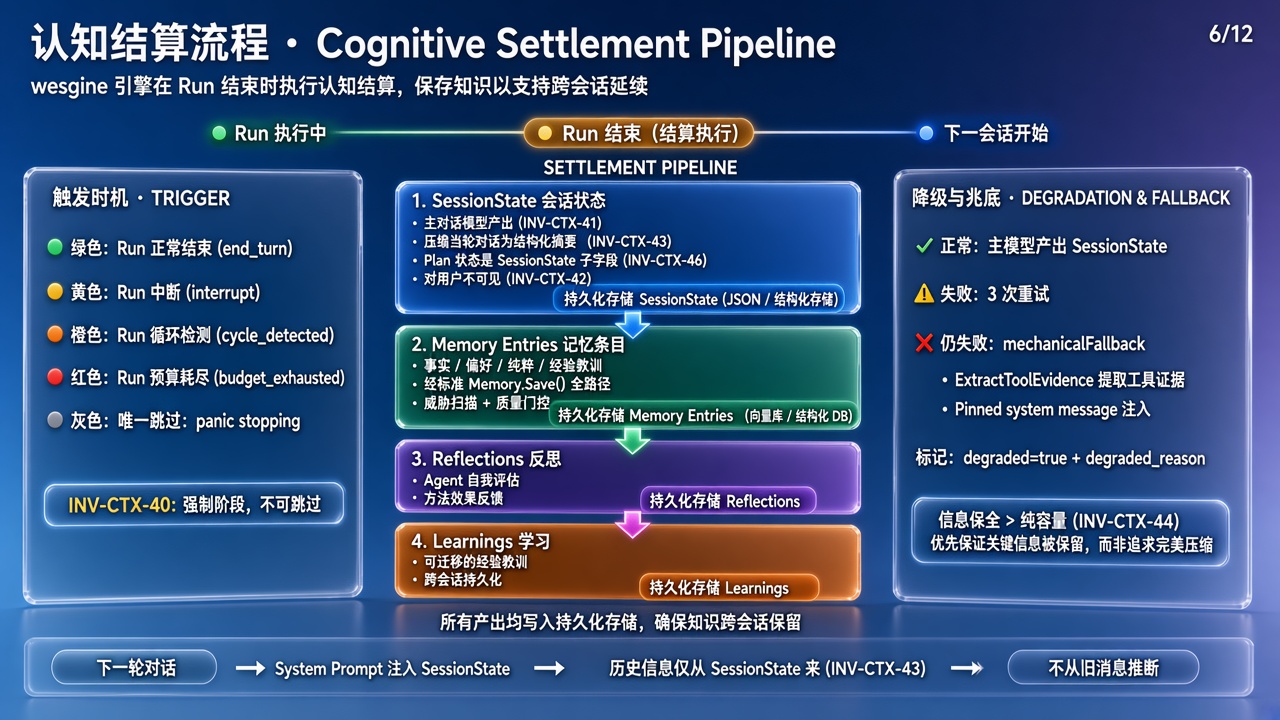
Settlement 的输入→处理→输出
这不是"把整段对话存下来"。那样做上下文窗口会爆。Settlement 做的是蒸馏——从几千 token 的对话里提炼出几百 token 的结构化认知。
具体来说,Settlement 产出四类认知产物:
// Settlement 的输出结构(简化示意)
interface SettlementOutput {
  // 1. SessionState —— 对话的压缩摘要,下次对话恢复上下文
  sessionState: {
    summary: "讨论了订单模块的分页接口设计,决定用 cursor 分页替代 offset 分页",
    keyDecisions: ["cursor 分页", "返回格式统一为 { data, cursor, hasMore }"],
    openQuestions: ["cursor 字段用 id 还是 createdAt"]
  },

  // 2. Memory Entries —— 持久化的事实、偏好、纠正
  memoryEntries: [
    { kind: "fact", content: "分页接口用 cursor 分页,不用 offset" },
    { kind: "correction", content: "分页返回 { data, cursor, hasMore },不是 { items, total, page }" },
    { kind: "preference", content: "SQL 查询用 Prisma,不写原生 SQL" }
  ],

  // 3. Reflections —— 对自身行为的反思
  reflections: [
    "用户纠正了分页返回格式,说明我对项目规范的了解不够,下次应该先问"
  ],

  // 4. Learnings —— 可迁移的教训
  learnings: [
    "这个项目的 API 风格偏向 cursor-based pagination,新接口都应该默认这种方式"
  ]
}
关键设计:Settlement 用的是主对话模型(比如你在用 Claude Sonnet,就用 Claude Sonnet 做 Settlement),不是另一个小模型。因为提炼质量 = 对话模型的认知质量。用一个小模型去"总结"大模型的对话,它理解不了那些隐含的架构决策。
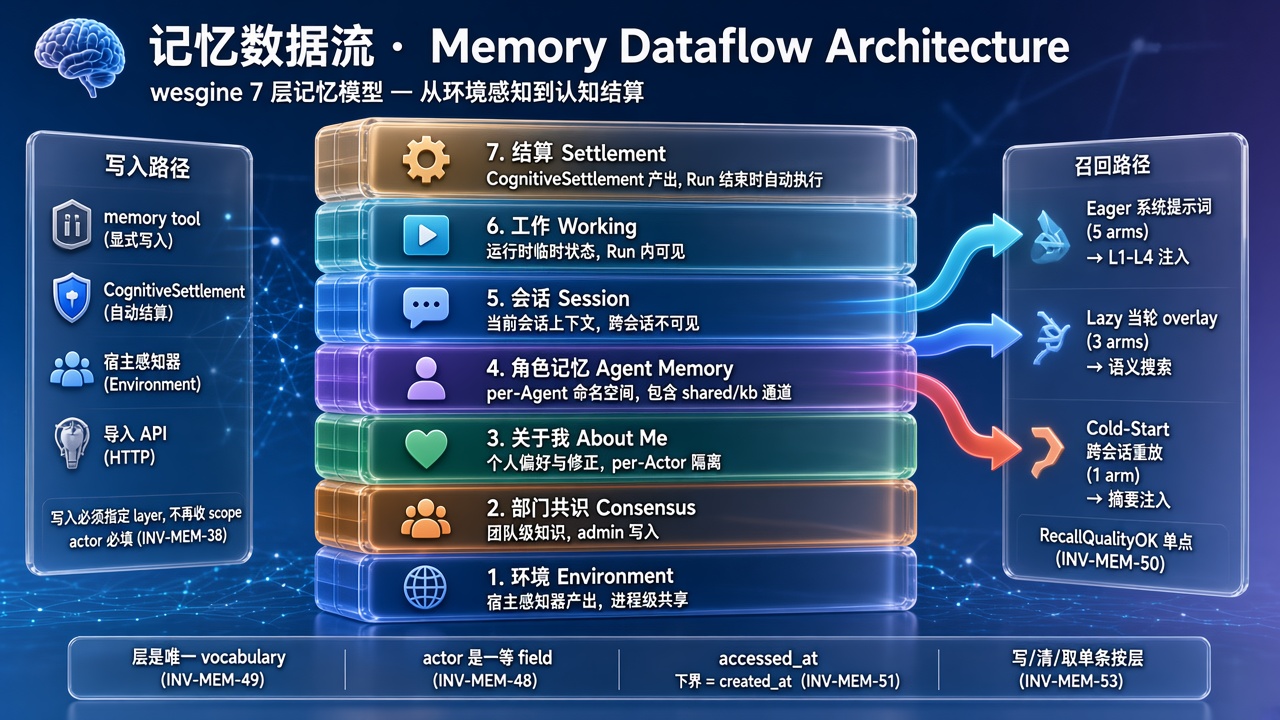
记忆不是一个扁平列表
你可能以为记忆就是一堆"key-value"。不是的。不同性质的信息需要不同的存储策略——"你的操作系统是 macOS"和"你喜欢用 dayjs"是两种完全不同的东西:前者会变(你可能换电脑),后者是稳定偏好。

wescode 的记忆按性质分成七层:
| 层 | 内容 | 来源 | 持久性 |
|---|---|---|---|
| 环境信息 | 操作系统、运行时版本、已安装工具 | 自动感知 | 自动更新 |
| 部门共识 | 团队约定(多人场景) | admin 写入 | 持久 |
| 关于我 | 你的偏好、你的纠正 | 认知结算自动提炼 | 持久,旧的被取代时自动标记 |
| 角色记忆 | Agent 级别的专业知识 | 认知结算 / 显式保存 | 按 Agent 隔离 |
| 会话记忆 | 当次对话的临时状态 | 自动 | 对话结束后清理 |
| 工作缓存 | 运行时临时数据 | 自动 | 运行后清理 |
"关于我"这一层就是"说一次就够了"的实现——你说过"用 Prisma",它进入你的"关于我"层;你下次在同一个项目里开新对话,这条自动加载。你在另一个项目里开对话,这条不会出现——因为记忆按项目(工作区)物理隔离,不会串。
记忆积累的时间线:越用越准
记忆不是一次性的。它随着你的使用不断积累。以下是一个真实场景的模拟:
第 1 次对话(项目第一天)
你:"帮我写一个用户注册接口,我们用 Express + Prisma。"
Settlement 存入:
- 事实:后端框架 Express
- 事实:ORM 用 Prisma
此时 AI 知道 2 条规矩。
第 3 次对话
你:"这个日期处理别用 moment,用 dayjs。"
Settlement 存入:
- 偏好:日期库用 dayjs,不用 moment.js
此时 AI 知道 3 条规矩。
第 5 次对话
AI 写了一个 throw new Error("Invalid input")。你纠正:"我们统一用 AppError 类。"
Settlement 存入:
- 纠正:错误处理统一用 AppError 类,不用原生 Error
此时 AI 知道 4 条规矩。
第 10 次对话
你决定把 REST API 迁移到 tRPC。AI 之前记住的"用 Express 写 REST"被这次对话更新——旧条目自动标记过期,新条目"使用 tRPC"写入。
此时 AI 不仅知道 8-10 条规矩,而且过期的规矩不会干扰新对话。
到第 20 次对话时,AI 对你的项目已经有了一份相当完整的"项目知识库"——全部是从你的自然对话中自动提炼的,你一条也没有手动写过。
记忆系统的能力边界
说实话,记忆系统不是万能的。以下是它做不好的事情:
1. 一次性的调试指令会被误记
你说"帮我加个 console.log 调试一下",Settlement 有时候会把这当成偏好记住——"用户喜欢 console.log 调试"。实际上这只是一次临时操作。
应对方式:wescode 的记忆有过期机制(30 天零召回的条目自动标记 stale,不再注入)。临时指令因为不会被后续对话召回,会自然淘汰。但在淘汰之前,它可能干扰一两次对话。
2. 冲突记忆的处理
你上周说"用 CSS Modules",这周说"改用 Tailwind"。两条记忆冲突了。
应对方式:Settlement 有取代检测(detectSupersession)——新条目如果显式否定了旧条目,旧条目会被标记为 Conflicted,不再注入。但这依赖于否定关系是显式的。如果你没说"不用 CSS Modules 了,改用 Tailwind",而是只说"这个组件用 Tailwind 写",系统可能不会把旧条目标记过期。
3. 高度上下文相关的决策
"这个接口不需要鉴权"——这只针对这一个接口,不是所有接口。但如果 Settlement 把它当成通用规矩记住了,后续其他接口可能也不加鉴权。
应对方式:Settlement 对 kind 有分类——一次性的决策归类为 episodic(会话级),不会持久化到跨会话的记忆层。但分类不是 100% 准确的。
底线:相比每次从零开始,一个会犯少量错误但能自动积累的记忆系统,仍然好过"你自己想全然后手动维护一份文件"。完美不是标准,比手动好是标准。
有记忆 vs 无记忆:步骤级对比
同一个任务:"写一个订单分页查询接口"。
无记忆(每次新对话都从零开始)
| 步骤 | 你做的事 | 花多久 |
|---|---|---|
| 1 | 开新对话,说"用 Prisma 做 ORM" | 15 秒 |
| 2 | 说"分页返回格式是 { data, total, page, pageSize }" | 15 秒 |
| 3 | 说"错误处理用 AppError" | 10 秒 |
| 4 | 说"TypeScript strict mode" | 10 秒 |
| 5 | 描述需求 | 30 秒 |
| 6 | AI 生成代码 | — |
| 7 | 发现它用了 new Error() 而不是 AppError,纠正 | 2 分钟 |
| 8 | 发现返回格式不对,纠正 | 1 分钟 |
总计:~4-5 分钟,其中 3 分钟在重复上下文和纠正。
有记忆(第 10 次对话之后)
| 步骤 | 你做的事 | 花多久 |
|---|---|---|
| 1 | 开新对话,描述需求 | 30 秒 |
| 2 | AI 生成代码——自动用 Prisma、AppError、正确的分页格式 | — |
总计:~30 秒。
差距不是"快了一点",是从 4 分钟变成 30 秒——而且随着记忆积累,AI 犯"不知道项目规矩"的错误会越来越少。
和规则文件的区别
| 规则文件 | wescode 认知结算 | |
|---|---|---|
| 谁写 | 你 | AI 自动提炼 |
| 谁维护 | 你手动更新 | 自动维护——"不用 moment.js"写入后,如果你后来又说"moment.js 可以用了",旧条目自动标记过期 |
| 覆盖面 | 你能想到的(通常 10-20 条) | 你说过的所有关键信息 |
| 按项目隔离 | 取决于你把文件放在哪 | 自动按工作区物理隔离 |
| 冲突处理 | 你手动发现、手动删旧规则 | 自动取代检测 |
| 过期管理 | 你记得更新就更新,不记得就留着过期的规则 | 30 天零召回自动标记 stale |
| 代价/局限 | 维护成本低,但覆盖面取决于你能写出多少 | 偶尔误记一次性指令;冲突取代依赖显式否定;记忆积累需要 1-2 周使用才趋于稳定 |
它不完美——有时候会记住不该记的,有时候会忘掉该记的。但相比每次从零开始,一个能自动积累、自动过期、按项目隔离的记忆系统,好过"你自己想全然后手动维护一份文件"。
还有一类"规矩",你说都说不出来
认知结算解决的是"你说过的事"。但有一类规矩,你自己都不知道它存在——直到 AI 违反了它:
- 项目里 95% 的错误处理用
AppError,你从来没跟 AI 说过——因为你自己也没意识到这是一条规矩 - import 顺序始终是"第三方包 → 内部包 → 相对路径"——你没说过,但团队一直这么写
- 所有 HTTP handler 的第一行都是参数校验——不是写在文档里的约定,是代码里长出来的惯例
// 团队代码里 95% 的 handler 都这样开头
export async function createOrder(req: Request, res: Response) {
  const { userId, items } = validateBody(req.body, CreateOrderSchema) // 第一行就校验
  // ...业务逻辑
}

// AI 不知道这个惯例,写出了这样的代码
export async function createOrder(req: Request, res: Response) {
  const { userId, items } = req.body  // 没有校验——编译通过,运行时才炸
  // ...
}
这类隐性规矩,不管你怎么说、说多少遍,AI 都不知道——因为你自己也说不出来。
wescode 用另一个能力解决这个问题——CSE(约束满足引擎),通过扫描项目代码自动推导编码惯例。它和认知结算分工明确:认知结算记住你说过的,CSE 发现你没说过但一直在遵守的。 两者合在一起,AI 对项目的理解从"每次从零"变成"越用越懂"。
你可以做什么
如果你现在用的工具没有长期记忆,至少做两件事:
- 维护一份
.cursorrules或CLAUDE.md——把你最常重复的那几条项目约定写进去。不完美,但比什么都没有强 - 每次纠正 AI 的时候,想一下这条规矩值不值得写进规则文件——如果你今天纠正了,明天大概率还要纠正同一件事
但如果你受够了"人肉维护规则文件"这件事——wescode 的认知结算帮你自动做这一步。你只管和 AI 对话,它自己会记住。记忆存在你本地的 SQLite 里,不上传任何服务器。