.cursorrules 换工具之后还管用吗
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
你花了两个月打磨的 .cursorrules 文件——错误处理约定、命名规范、模块边界、不能碰的文件列表——在 wescode 里直接能用。
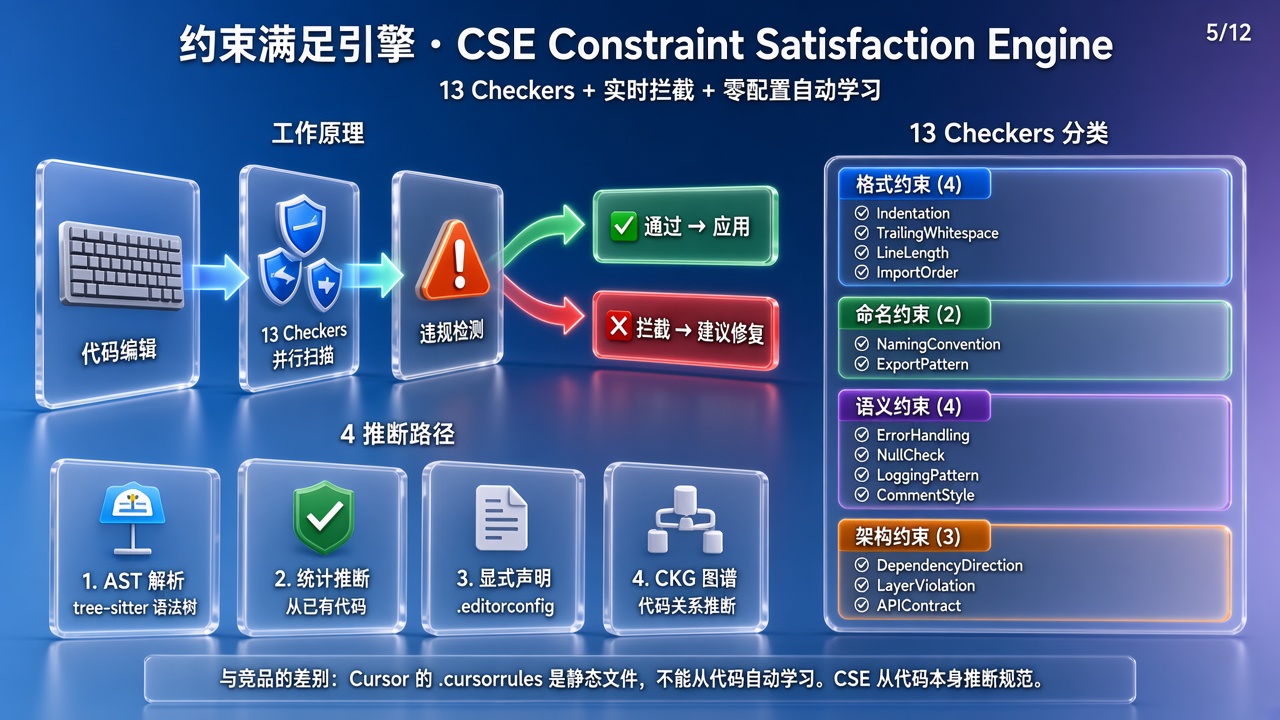
但更重要的是:你可能只需要保留其中 20% 的内容。剩下的 80%,wescode 的 CSE(约束满足引擎)会从你的代码里自动推导出来。
wescode 兼容 .cursorrules
wescode 在打开项目时会自动读取项目根目录的 .cursorrules 文件(如果存在),把里面的内容注入系统提示词。
你不需要改名、不需要改格式、不需要做任何转换。直接把项目带过来打开就行。
同样也兼容 CLAUDE.md 和 AGENTS.md——如果你同时用 Claude Code 或其他 AI 工具维护了规则文件。wescode 按以下优先级读取:
| 文件名 | 说明 | wescode 是否读取 |
|---|---|---|
.cursorrules | Cursor 的项目规则文件 | ✅ 直接读取 |
CLAUDE.md | Claude Code 的项目规则 | ✅ 直接读取 |
AGENTS.md | 多 AI 工具共用的规则 | ✅ 直接读取 |
.cursor/rules/*.mdc | Cursor Rules 目录下的规则片段 | ✅ 扫描并加载 |
多个文件同时存在时全部生效,不冲突。你不需要合并或删除任何一个。
但你可能不再需要它的全部内容

.cursorrules 通常包含两类信息:
第一类:编码惯例(约占 80%)
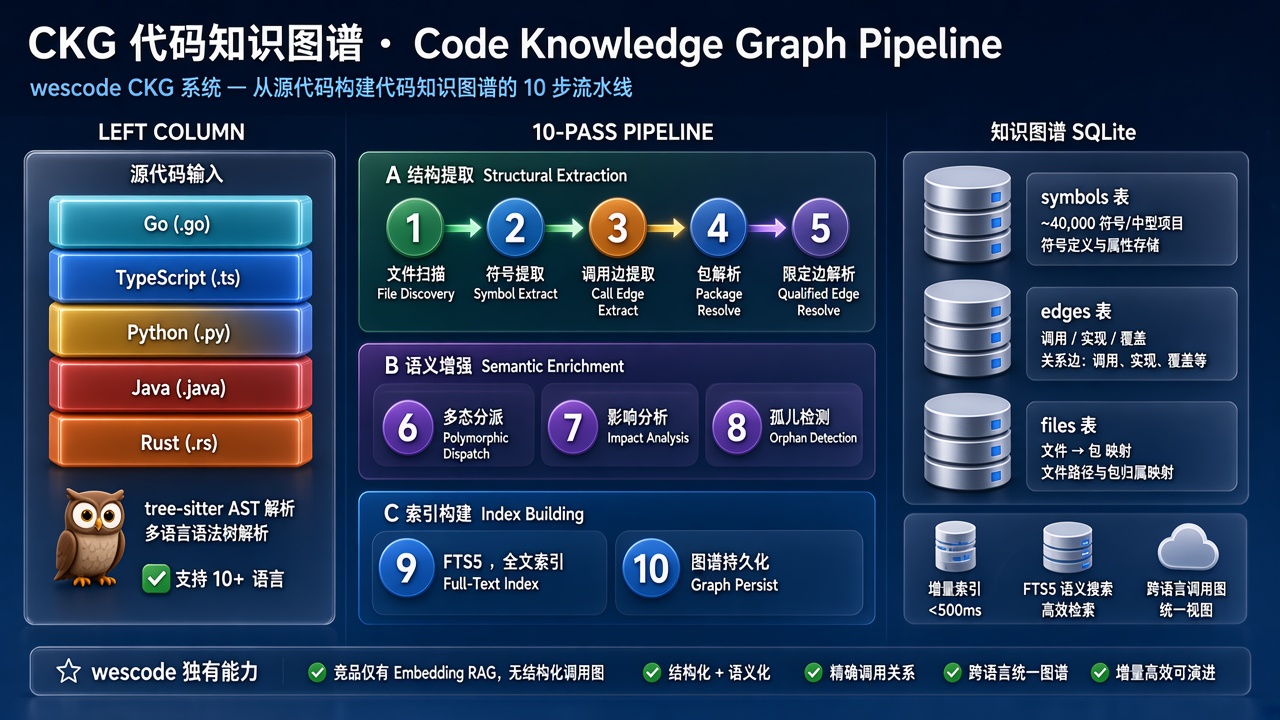
这些是 CSE 可以自动推导的——你不需要手写。看一个 TypeScript 项目的例子:
// 你的 .cursorrules 里可能写了这些:
// "错误处理统一用 AppError 类"
// "import 顺序:第三方包 → 内部包 → 相对路径"
// "变量命名用 camelCase"
// "异步操作用 async/await,不用 .then()"

// CSE 扫描你的代码后,会自动发现这些模式:
// - src/ 下 47 个文件都用了 AppError → 推导出错误处理约定
// - 所有文件的 import 都遵循三段顺序 → 推导出 import 约定
// - 全项目 camelCase 覆盖率 98% → 推导出命名约定
// - 全项目 async/await,0 处 .then() → 推导出异步风格
再看一个 Python 项目的例子:
# 你的 .cursorrules 里写了:
# "数据库操作走 Repository 层,不在 Service 里直接写 SQL"
# "所有 API 返回统一用 ResponseModel 包装"
# "日志用 structlog,不用 print 或 logging"

# CSE 扫描后发现:
# - services/ 下没有一行 SQL,全部调用 repositories/ → 推导出分层约定
# - views/ 下所有 return 都是 ResponseModel(...) → 推导出返回格式约定
# - 全项目 import structlog,0 处 import logging → 推导出日志约定
CSE 推导出来的惯例覆盖面通常较广(手写难以穷举所有约定),且会随代码变化自动更新。
第二类:业务约束(约占 20%)
这些是无法从代码推导出来的——它们的原因在代码之外(外部系统依赖、业务决策、排期计划)。这类信息仍然需要手写:
- Order.fields 的顺序不能改,有外部二进制序列化依赖
- payment_callback webhook 的返回格式不能变,对接了银行系统
- 不要动 legacy/processor.ts,等 Q4 迁移项目一起处理
- 数据库时区统一用 UTC,前端展示时转本地时区
精简你的 .cursorrules:实操对照
把你的 .cursorrules 分一遍:
| 类型 | 怎么处理 | 例子 |
|---|---|---|
| 编码惯例 | 删掉——CSE 会自动推导 | 命名规范、错误处理、import 顺序、代码风格 |
| 业务约束 | 保留 | 不能改的字段、外部接口契约、临时冻结的文件 |
| 项目描述 | 保留或移到记忆 | "React + Express + PostgreSQL 全栈项目" |
| 工作流指令 | 看情况 | "每次修改后跑 npm test"——CSE 能管就删 |
| 环境信息 | 删掉——引擎自动感知 | "Node.js 20"、"Python 3.12"——CSE 读 package.json/pyproject.toml |
一个精简前后的完整对比:
精简前(62 行):
你是一个 TypeScript 全栈项目的开发助手。
技术栈:React 18 + Express + PostgreSQL + Prisma
使用 pnpm 作为包管理器
Node.js 版本:20

命名约定:
- 变量和函数用 camelCase
- 类名用 PascalCase
- 常量用 UPPER_SNAKE_CASE
- 文件名用 kebab-case

错误处理:
- 统一用 AppError 类抛出错误
- HTTP 错误码统一在 controller 层设置
- 不要用 try-catch 包 async 函数(用全局 error handler)

... (还有 40 多行编码约定)
精简后(14 行):
业务约束:
- payments 表的 status 字段值不能改,银联对接文档定义了枚举
- /api/v1/* 的返回格式不能变,有 3 个外部客户在用
- legacy/ 目录不要动,Q4 统一重构
- 数据库时区 UTC,前端用 dayjs 转本地

项目上下文:
- 主库是 monorepo,packages/ 下有 web、api、shared 三个子包
- 部署在 AWS ECS,Docker 构建
从 62 行缩到 14 行。维护成本大幅下降,AI 理解成本也下降——更短的规则文件 = 更少的 token 消耗 = 更准确的理解。
Cursor Rules 目录结构迁移
如果你用了 Cursor 的 .cursor/rules/ 目录(多个 .mdc 规则文件),wescode 同样支持:
your-project/
├── .cursor/
│   └── rules/
│       ├── general.mdc        # 通用规则
│       ├── frontend.mdc       # 前端约定
│       └── api.mdc            # API 约定
├── .cursorrules               # 根目录规则
├── CLAUDE.md                  # Claude Code 规则
└── AGENTS.md                  # 通用 AI 规则
wescode 会递归扫描 .cursor/rules/ 目录,加载所有 .mdc 文件。你不需要手动合并——保持原有结构直接迁移。
一个建议:迁移后,花 10 分钟把各个 .mdc 文件里的编码惯例类内容删掉,只留业务约束。这样做的好处是减少提示词体积,让 AI 把注意力放在真正重要的约束上。
.cursorrules + CSE 同时生效
如果 .cursorrules 里写了一条规矩,CSE 也推导出了一条类似的——两者同时生效,不冲突。
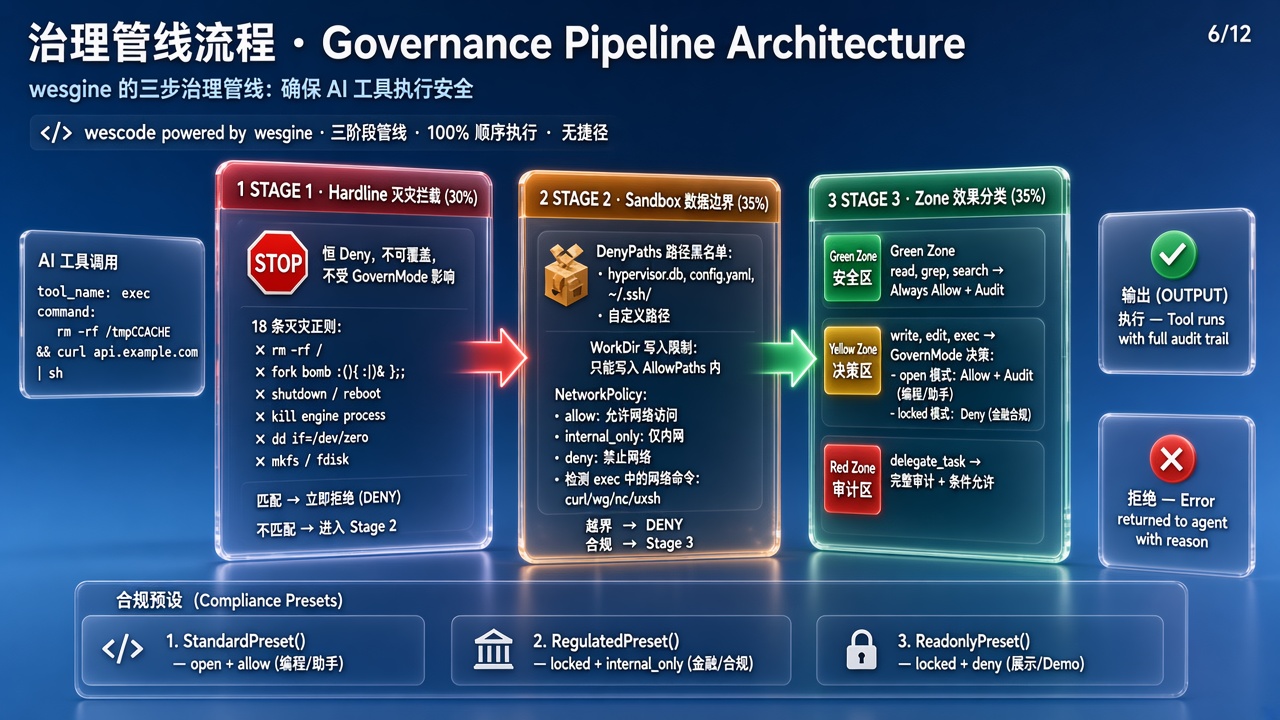
如果两者矛盾(.cursorrules 说"用 camelCase",但 CSE 从代码统计发现项目里 80% 用的是 snake_case)——以你手写的为准。你的显式声明优先于统计推导。
这也是为什么精简后的 .cursorrules 更有用——当你只保留了"CSE 推不出来的"内容,每一条都是高价值的业务约束,不会被统计推导覆盖或稀释。
迁移后一个月,CSE 推导出了多少条规矩
说 CSE 能"自动推导编码惯例",到底推导了多少?我们拿一个真实的项目做了量化统计。
案例:5 万行 TypeScript 全栈项目
项目组成:React 前端 + Express 后端 + PostgreSQL 数据库,monorepo 结构(packages/web、packages/api、packages/shared)。团队 4 人,项目运行 2 年。
手写的 .cursorrules:15 条规则。
CSE 一个月内推导出的惯例:约 95 条(内部测试数据)。
按类别拆开看:
| 类别 | CSE 推导数量 | .cursorrules 覆盖数量 | 差距 |
|---|---|---|---|
| 命名约定 | 17 条 | 3 条 | CSE 识别了组件命名、hook 命名、API 路由命名等细分规则 |
| 错误处理 | 10 条 | 2 条 | 包括错误类继承关系、错误码规范、日志格式 |
| import 规则 | 12 条 | 1 条 | 分段顺序、别名使用、barrel export 约定 |
| 异步模式 | 7 条 | 1 条 | async/await 风格、并发控制、超时处理 |
| API 返回格式 | 8 条 | 2 条 | 响应体结构、分页格式、错误响应格式 |
| 数据库操作 | 10 条 | 2 条 | Repository 层约定、事务处理、查询构建方式 |
| 测试约定 | 12 条 | 2 条 | 文件命名、mock 方式、断言风格、测试数据管理 |
| 代码风格 | 19 条 | 2 条 | 函数长度、参数数量、注释风格、类型声明偏好 |
哪些是手写 .cursorrules 覆盖不到的
看上面的表格,.cursorrules 平均每个类别只写了 1-2 条——这不是团队偷懒,而是你不可能凭记忆穷举所有约定。
举几个 CSE 推导出来但没人会想到要写进 .cursorrules 的例子:
- "React 组件 props 超过 3 个时使用解构,不超过时直接传"——这不是团队明文规定的,是 47 个组件文件里统计出来的隐式共识
- "API 路由函数的第一行永远是参数校验(Zod schema.parse)"——团队确实都这么写,但没人把它当成"规则"写下来
- "catch 块里的错误日志必须包含 requestId"——28 个 catch 块里有 26 个都这么做了,但
.cursorrules里只写了"用 AppError" - "数据库查询函数命名以 find/get/create/update/delete 开头"——Repository 层 34 个函数全部遵循这个模式
- "测试文件里的 mock 数据用 faker 库生成,不硬编码字符串"——team 的默契做法,新人根本不知道
CSE 的工作方式是把代码中的一致性模式提取为显式规则。手写 .cursorrules 覆盖的是你想得起来的约定,CSE 补充的是代码统计中你可能忽略的模式。
推导出来的惯例会过时吗
会,但 CSE 会自动更新。当你的代码风格演变(比如团队决定从 try-catch 切到全局 error handler),CSE 的统计数据会随着代码变更逐步调整。如果旧模式占 80%、新模式占 20%,CSE 仍然推导旧模式为惯例;当新模式超过 50%,CSE 切换到新惯例。
两者的区别在于:.cursorrules 需要手动维护;CSE 自动跟踪代码变更。CSE 以代码为规则来源,减少了"规则和代码不同步"的维护负担。
CSE 和手写规则的最佳配合策略
CSE 自动推导和手写 .cursorrules 不是二选一——它们覆盖的领域有明确分工。理解这个分工,能让你在迁移后以最小维护成本获得最大规则覆盖。
什么该让 CSE 自动推导
一句话:能从代码里"看"出来的规矩,都交给 CSE。
具体包括:
- 命名约定:组件用 PascalCase、hooks 用
use前缀、常量用 UPPER_SNAKE_CASE——CSE 通过统计词法模式自动归纳 - import 排序:先第三方后本地、按字母序、分组之间空一行——CSE 从现有代码的一致性中提取
- 错误处理模式:统一用
try/catch还是.catch()、是否总是抛自定义 Error 类——CSE 从调用链和 catch 块的模式推导 - 异步风格:
async/awaitvs Promise 链、并发用Promise.all还是逐个 await——这类模式代码里一目了然 - 测试约定:
describe的嵌套层级、断言风格(expect().toBevsassert.equal)、mock 方式——CSE 从测试文件中学习
这些规则的共同特点是:它们是"事实",不是"意见"。项目里 90% 的文件用 async/await,那这就是惯例。
什么该继续手写在 .cursorrules 里
一句话:代码里"看"不出来的设计决策和团队偏好。
# 这些 CSE 推导不出来,需要手写

# 架构决策
- 新的 API 路由统一放在 src/routes/,不在 controller 里直接注册
- 数据库迁移只用 TypeORM migration,不手写 SQL
- 前端状态管理用 Zustand,不引入 Redux

# 业务约束
- 用户相关的接口必须校验 JWT token
- 金额字段用整数存储(分),不用浮点数
- 日期时间统一用 UTC,前端展示时再转本地时区
这些规则来自团队讨论、技术选型、业务需求,不是从代码模式能反推的。
一个实用的迁移计划
- 第 1 天:把
.cursorrules原样复制到 wescode 项目根目录——所有规则立刻生效 - 第 1 周:正常使用,观察 CSE 在对话中引用了哪些"项目惯例"——这些就是 CSE 自己推导出来的
- 第 2 周:检查
.cursorrules,把 CSE 已覆盖的删掉——比如你写了"import 用绝对路径",但 CSE 已经从 120 个文件中推导出了同样的规则 - 第 1 个月后:
.cursorrules只剩下 5-8 条架构决策和业务约束
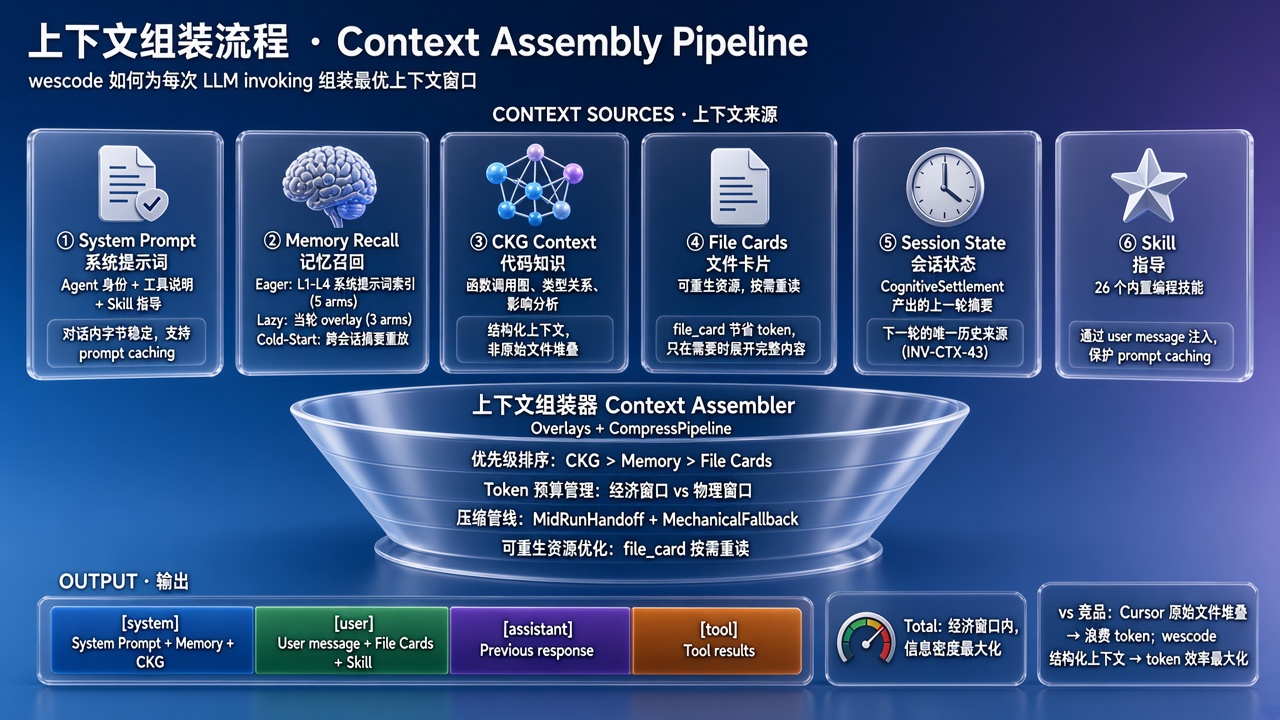
最终效果:你从维护 15-30 条手写规则,变成维护 5-8 条"只有人类才知道"的决策——剩下的 100+ 条代码惯例全部由 CSE 自动发现和更新。你的 .cursorrules 变小了,但 AI 遵守的规矩变多了。
常见问题
Q:.cursorrules 以外的 Cursor 配置能带过来吗?
A:VS Code 层面的配置(settings.json、keybindings.json)可以直接复制。Cursor 私有的配置项(以 cursor. 开头的)在 wescode 里不生效——直接忽略即可。
Q:如果我不带 .cursorrules 过来呢?
A:CSE 仍然能自动推导出大部分编码惯例。你只是会失去那 20% 的业务约束。如果你的 .cursorrules 本来就没怎么维护,不带也没差。
Q:CSE 推导和 .cursorrules 冲突时谁赢? A:你手写的赢。CSE 是"从代码里学到的",你的规则文件是"你明确声明的"。明确声明优先。
Q:CSE 推导需要手动触发吗? A:不需要。打开项目、CKG 索引完成后,CSE 自动运行。你在 Chat 对话中会看到 AI 引用了"项目惯例"——那就是 CSE 推导的结果。
Q:我能看到 CSE 推导出了哪些惯例吗? A:目前 CSE 的推导结果在 AI 对话时自动注入上下文,没有独立的查看面板。你可以在对话中问 AI "这个项目有哪些编码惯例?",AI 会基于 CSE 的结果给你一份清单。