BYOK 配置:三家模型怎么组合最省
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
wescode 不绑定任何模型供应商。你自己带 Key,直连模型。
但"自己选模型"也意味着"选错了浪费钱"。这篇给一个实用的组合方案,适合刚从订阅制迁过来的开发者。
推荐起步方案:两个 Key 就够了
| 用途 | 模型 | 为什么 | 大约花费 |
|---|---|---|---|
| 日常编码(80% 的时间) | DeepSeek V3 | 便宜、中文好、编码能力够用 | ¥2-5/天 |
| 复杂推理(20% 的时间) | Claude Sonnet | 长推理链稳定、多步重构准 | ¥5-15/天(仅使用时) |
两个 Key 的月花费大约 ¥60-200——取决于你用得多重。
对比 Cursor Pro 的 $20/月 ≈ ¥145/月——如果你日常用 DeepSeek V3 为主,月费可能更低。如果你重度使用 Claude Sonnet,月费可能持平或略高。
怎么配

打开 wescode → 设置 → AI 配置。
配 DeepSeek
name: deepseek
type: openai_compatible
base_url: https://api.deepseek.com/v1
api_key: sk-xxxx        # 从 platform.deepseek.com 获取
models:
  - name: deepseek-chat  # DeepSeek V3
配 Anthropic(Claude)
name: anthropic
type: anthropic
api_key: sk-ant-xxxx     # 从 console.anthropic.com 获取
models:
  - name: claude-sonnet-4-20250514
配好之后,Chat 面板右上角可以一键切换模型。日常用 DeepSeek,遇到复杂任务(跨文件重构、多步推理)切 Claude。
不同场景的模型推荐
不同编程语言和任务类型,模型的表现差异明显。以下是实际使用中的推荐:
| 场景 | 推荐模型 | 原因 |
|---|---|---|
| TypeScript / React 开发 | DeepSeek V3 或 Claude Sonnet | 两者都强,DeepSeek 更便宜 |
| Python 数据处理 | DeepSeek V3 | 中文文档和注释处理更好 |
| Rust / 系统编程 | Claude Sonnet | 复杂类型系统推理更准 |
| SQL 查询优化 | GPT-4o 或 DeepSeek V3 | 两者都够用,DeepSeek 便宜 |
| 跨 3+ 文件重构 | Claude Sonnet | 长上下文推理稳定性最好 |
| Bug 修复(已知位置) | DeepSeek V3 | 快、便宜,简单任务够用 |
| 架构设计讨论 | Claude Sonnet 或 GPT-4o | 需要更强的推理能力 |
| 代码审查 / Review | DeepSeek V3 | 性价比最优 |
经验法则:80% 的日常工作用最便宜的模型(DeepSeek V3),20% 的复杂任务再切强模型。不要全天候挂着 Claude Sonnet——大部分任务用不上那个级别的推理能力。
进阶方案:三个 Key
如果你要更细的成本控制:
| 用途 | 模型 | 价格级别 | 说明 |
|---|---|---|---|
| 快速补全 | GPT-4o-mini 或 DeepSeek V3 | 最便宜 | 行级补全,每次调用 token 少 |
| 日常对话 | DeepSeek V3 | 便宜 | 单文件修改、问答、解释代码 |
| 复杂推理 | Claude Sonnet | 中等 | 跨文件重构、架构讨论、难 Bug |
GPT-4o-mini 的价格大约是 GPT-4o 的十分之一,做代码补全完全够用。
配 OpenAI
name: openai
type: openai
api_key: sk-xxxx         # 从 platform.openai.com 获取
models:
  - name: gpt-4o-mini    # 补全和快速任务
  - name: gpt-4o         # 需要时手动切换
WES 平台账户 vs 纯 BYOK
wescode 还提供了 WES 平台账户——免去注册多个供应商的麻烦:
| 对比维度 | WES 平台账户 | 纯 BYOK |
|---|---|---|
| 注册 | 一个账户,充一次值 | 需注册 2-3 个供应商账号 |
| 计费 | 按 token 用量,统一账单 | 各供应商分别计费 |
| 模型切换 | 一个 Key 访问多家模型 | 每家一个 Key,手动配置 |
| 价格 | 含少量平台服务费 | 直连供应商原价 |
| 数据路径 | 经 WES 平台代理 | 直连供应商 API |
推荐:新手从 WES 平台开始(简单),用熟了之后切 BYOK(更便宜、更透明)。两种方式随时可以切换,不影响使用体验。
模型选择速查表
"这个任务该用哪个模型?"——下面这张表直接给答案。按任务类型列出推荐模型和单次预估费用,让你不用每次都纠结。
| 任务类型 | 第一选择 | 备选模型 | 单次费用(DeepSeek V3) | 单次费用(Claude Sonnet) | 选择理由 |
|---|---|---|---|---|---|
| 行级补全(写一行/补全函数) | DeepSeek V3 | GPT-4o-mini | ¥0.001-0.005 | ¥0.01-0.03 | token 少,用最便宜的就够 |
| 代码解释("这段代码做了什么") | DeepSeek V3 | GPT-4o | ¥0.005-0.02 | ¥0.03-0.10 | 理解类任务不需要强推理 |
| 写单元测试 | DeepSeek V3 | Claude Sonnet | ¥0.01-0.05 | ¥0.05-0.20 | 模板化工作,性价比优先 |
| 修 Bug(单文件,已知位置) | DeepSeek V3 | GPT-4o | ¥0.01-0.03 | ¥0.05-0.15 | 范围小,简单模型快且准 |
| 跨文件重构(3+ 文件联动) | Claude Sonnet | GPT-4o | ¥0.10-0.50 | — | 长上下文推理稳定性差异大 |
| Agent 多步任务(自动执行 5+ 步) | Claude Sonnet | DeepSeek V3 | ¥0.05-0.20 | ¥0.20-1.00 | 多步推理链的质量决定成败 |
| 代码审查(Review 一个 PR) | DeepSeek V3 | Claude Sonnet | ¥0.02-0.10 | ¥0.10-0.50 | 性价比高,覆盖大部分场景 |
| 架构设计讨论 | Claude Sonnet | GPT-4o | ¥0.20-0.80 | — | 需要深度推理和全局视角 |
| SQL 优化 | DeepSeek V3 | GPT-4o | ¥0.01-0.05 | ¥0.05-0.20 | 两者能力差距不大 |
| 正则表达式编写 | DeepSeek V3 | GPT-4o-mini | ¥0.005-0.02 | ¥0.02-0.08 | 小任务,用便宜的 |
费用说明:以上为单次对话/任务的预估范围,基于 2026 年 Q3 各供应商公开定价。实际费用取决于上下文长度和生成内容长度。"单次"指一轮完整的对话交互(发送问题 → 获得回答)。
三句话记住选模型
- 默认用 DeepSeek V3——80% 的日常编码任务(补全、解释、小修改、写测试、Review)它都够用,费用是 Claude 的 1/5 到 1/10。
- 跨文件或多步骤时切 Claude Sonnet——重构 3 个以上文件、让 Agent 自动执行复杂任务、讨论架构方案时,Claude 的长推理链更稳定、更少出错。
- 补全用最便宜的——行级补全每次只用几十个 token,GPT-4o-mini 或 DeepSeek V3 都够,没必要用贵模型。
预算控制
各家供应商后台都可以设月度用量上限:
- OpenAI:Settings → Billing → Usage limits → 设 Hard limit
- Anthropic:Settings → Billing → 设 Monthly spending limit
- DeepSeek:账户中心 → 设消费上限
设了上限到了就停——不会超。这是供应商层面的控制,不是 wescode 的功能。
一个保守的起步预算:设 $20/月上限(和 Cursor 月费一样)。先用一周看看实际消耗,再调整。
如果你完全不想花钱
接本地模型。Ollama + Qwen 2.5 或 Llama 3.3:
name: local
type: openai_compatible
base_url: http://localhost:11434/v1
api_key: ollama          # Ollama 不需要真正的 key,填什么都行
models:
  - name: qwen2.5:32b    # 中文编码推荐
| 模型 | 显存/内存需求 | 推理质量 | 适合场景 |
|---|---|---|---|
| qwen2.5:7b | 8GB+ | 接近 GPT-3.5 | 简单补全、代码解释 |
| qwen2.5:14b | 16GB+ | 接近 GPT-4o-mini | 日常编码 |
| qwen2.5:32b | 32GB+ | 接近 GPT-4 | 大部分编码任务 |
| llama3.3:70b | 48GB+ | 接近 GPT-4o | 复杂推理(需要高配机器) |
M2/M3/M4 Mac 跑本地模型很顺——Apple Silicon 的统一内存架构让 32B 模型在 32GB 内存的 Mac 上流畅运行。
需要注意:本地模型的推理速度取决于你的硬件。M3 Pro 跑 32B 模型大约 15-25 tokens/s,日常使用够用但不如云端模型快。
从 Cursor 迁过来的费用变化
| 场景 | Cursor | wescode BYOK |
|---|---|---|
| 轻度使用(5-10 次对话/天) | $20/月(固定) | $5-15/月 |
| 中度使用(20-30 次/天) | $20/月(固定) | $15-30/月 |
| 重度使用(50+ 次/天) | $20/月(固定) | $30-60/月 |
| 不用的月份 | $20/月(固定) | $0 |
轻度使用省得最多。重度使用可能略贵。但区别在于:你不用的时候不花钱。 Cursor 不管你在不在度假都是 $20。
不同预算下的配置方案
"我预算有限,怎么配最划算?"——下面按月预算分三档,直接给完整方案。
方案 A:月预算 ¥50 以内(极简模式)
# 只配一个 Key
providers:
  - name: deepseek
    type: openai_compatible
    base_url: https://api.deepseek.com/v1
    api_key: sk-xxxx
    models:
      - name: deepseek-chat
使用策略:所有任务都用 DeepSeek V3。编码能力够用,中文好,价格便宜(每百万 token ¥1-2)。简单补全每次不到 ¥0.01,复杂对话每次 ¥0.02-0.10。每天 20-30 次对话,月花费约 ¥30-50。
适合:个人开发者、学生、轻度使用者、主要写中文注释的项目。
方案 B:月预算 ¥100-200(推荐模式)
# 两个 Key,80/20 分流
providers:
  - name: deepseek
    type: openai_compatible
    base_url: https://api.deepseek.com/v1
    api_key: sk-xxxx
    models:
      - name: deepseek-chat     # 日常 80%
  - name: anthropic
    type: anthropic
    api_key: sk-ant-xxxx
    models:
      - name: claude-sonnet-4-20250514  # 复杂任务 20%
使用策略:日常编码、代码解释、写测试、Review 用 DeepSeek V3。跨文件重构、Agent 多步任务、架构讨论切 Claude Sonnet。关键是养成习惯——每次开对话前花 1 秒想一下"这个任务需要强推理吗?",不需要就别切。
适合:全职开发者、中度使用者、需要偶尔处理复杂任务的场景。
方案 C:月预算 ¥200+(全配模式)
# 三个 Key,精细分流
providers:
  - name: deepseek
    type: openai_compatible
    base_url: https://api.deepseek.com/v1
    api_key: sk-xxxx
    models:
      - name: deepseek-chat     # 日常 70%
  - name: anthropic
    type: anthropic
    api_key: sk-ant-xxxx
    models:
      - name: claude-sonnet-4-20250514  # 复杂推理 20%
  - name: openai
    type: openai
    api_key: sk-xxxx
    models:
      - name: gpt-4o-mini       # 快速补全 10%
      - name: gpt-4o            # 备选
使用策略:行级补全用 GPT-4o-mini(最便宜),日常对话用 DeepSeek V3,复杂推理用 Claude Sonnet。三者各有最优场景,费用分布更均匀。
适合:重度使用者、技术负责人、需要处理多种复杂场景的开发者。
一个实用技巧:先从方案 A 开始。用一周后看供应商后台的用量统计——如果你发现某类任务 DeepSeek V3 的回答质量不够(通常是跨文件重构和多步 Agent),再加 Claude Sonnet 的 Key 升级到方案 B。不要一上来就全配,那样你根本分不清钱花在哪了。
常见问题
Q:我能用 Cursor 的 API Key 吗? A:Cursor 不提供独立的 API Key(它自己管理模型调用)。你需要去各模型供应商那里单独注册。
Q:多个供应商之间会自动切换吗?
A:wescode 支持配置 Provider 策略——own_first(先用你的 Key,失败了切备选)、shared_first(如果你同时配了 WES 平台)。日常使用中,手动切换模型更常见——因为不同任务你想用不同模型。
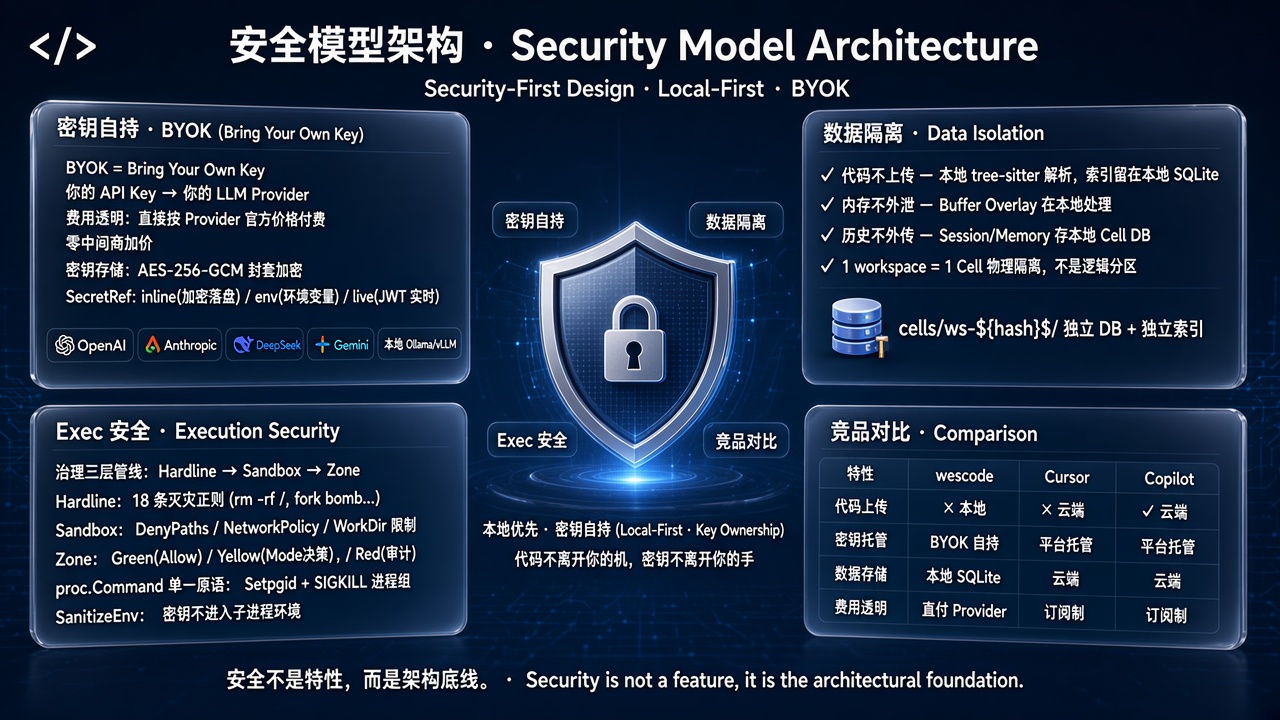
Q:API Key 安全吗? A:Key 存在你本地的配置文件里(加密存储),请求直连供应商、不经过 wescode 的任何服务器。
Q:DeepSeek 的速度怎么样?会不会很慢? A:日常响应在 1-3 秒之间,和 Cursor 体验接近。高峰期偶尔会有排队,切换到 OpenAI 或 Anthropic 即可。