大项目索引要多久,吃多少内存
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
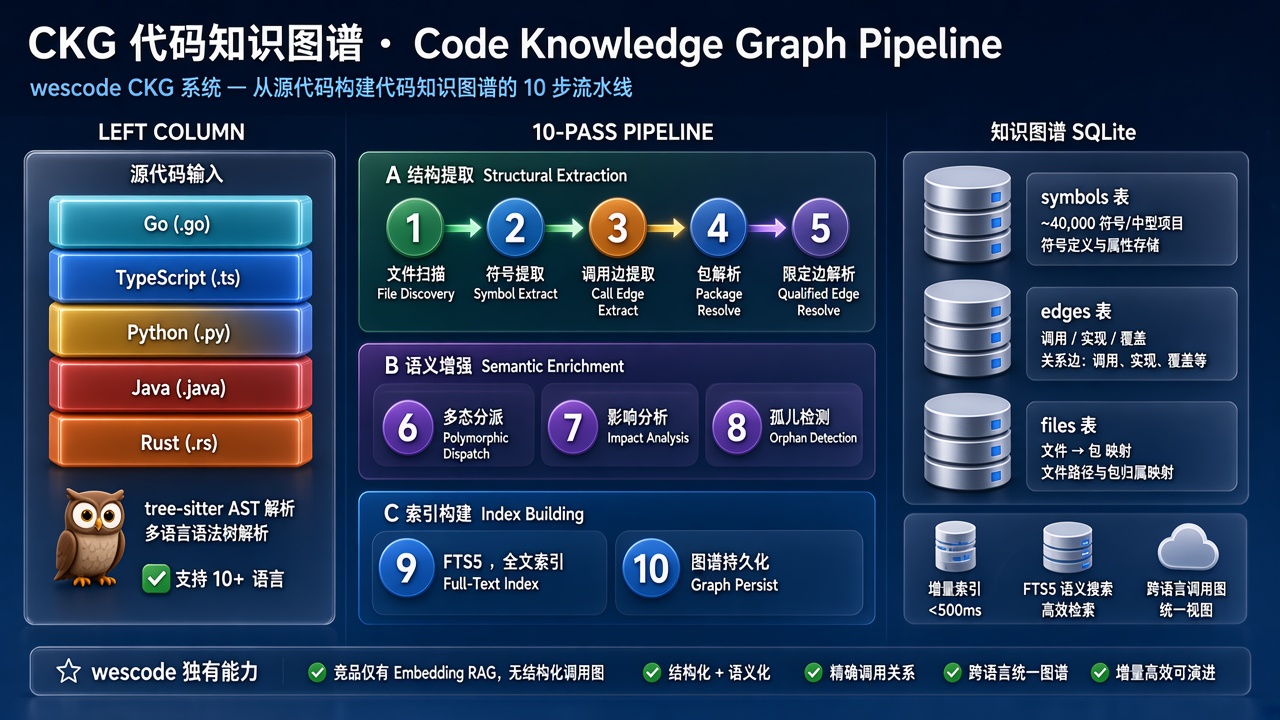
wescode 的代码知识图谱(CKG)是本地索引,不上传任何代码到云端。你第一次打开项目时会看到状态栏跑进度——这就是 CKG 在建索引。
Q: 第一次索引要多久?
取决于项目规模和你的硬件。这里是实测数据:
| 项目规模 | 文件数 | MacBook Pro M3 (16GB) | Intel i7-12700 (32GB) | 备注 |
|---|---|---|---|---|
| 小型项目 | ~500 文件 | 3-8 秒 | 5-12 秒 | React SPA、CLI 工具 |
| 中型项目 | ~5,000 文件 | 15-30 秒 | 25-50 秒 | 企业后端服务 |
| 大型项目 | ~50,000 文件 | 2-5 分钟 | 4-8 分钟 | monorepo |
| 超大仓库 | ~200,000 文件 | 8-15 分钟 | 15-25 分钟 | 含 vendor/生成代码 |
注意:这是首次全量索引的时间。 后续打开同一项目时,索引从 SQLite 加载,通常在 1-3 秒内完成。增量索引(你改了某些文件后)只重新索引变更文件,速度远快于全量。
四档项目的真实体验:
| 项目规模 | 首次索引体感 | 你能做什么 |
|---|---|---|
| 1 万行(React SPA) | 秒完——状态栏闪一下就好了 | 你可能都没注意到索引发生了 |
| 10 万行(企业后端) | 喝口水的功夫——15-30 秒 | 你站起来接个水回来刚好完成 |
| 50 万行(大型 monorepo) | 上个厕所——2-5 分钟 | 编辑器完全可用,索引在后台跑 |
| 100 万行+(超大仓) | 开一轮站会——8-15 分钟 | 去参加 standup,回来索引好了 |
Q: 索引期间能不能正常写代码?
能。索引不阻塞编辑。
CKG 的索引运行在独立的后台线程,不会抢占编辑器的 UI 线程。首次全量索引期间:
- ✅ 代码编辑、保存、格式化——完全不受影响
- ✅ 语法高亮、括号匹配、自动补全——正常工作
- ✅ Git 操作——正常使用
- ✅ 终端——正常使用
- ⚠️ CKG 调用图查询——索引完成前结果不完整(已索引到的文件可查询,未索引到的不能)
- ⚠️ AI 对话——可以用,但在索引完成前 CKG 上下文不完整,AI 回答的精度略低
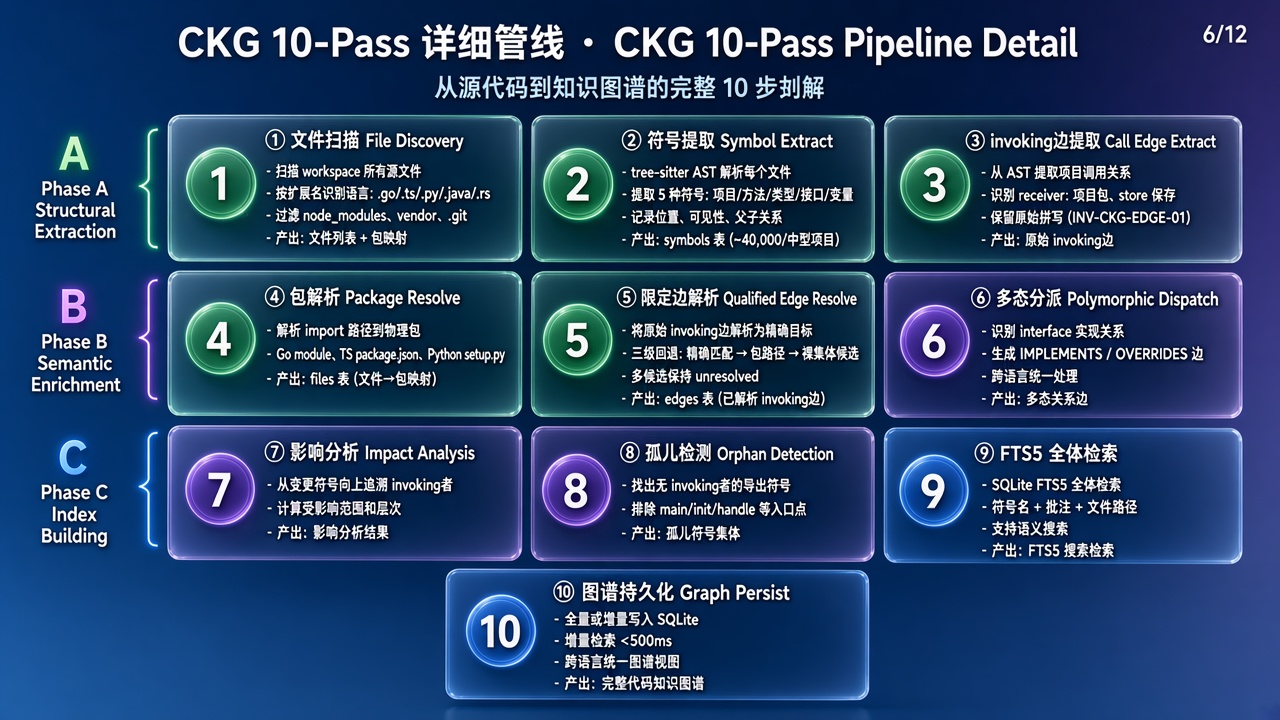
增量更新更无感。 你保存一个文件后,CKG 只重新解析这个文件和它的直接依赖(通常 3-5 个文件),耗时 100-500ms。这个过程完全在后台,你甚至感知不到它发生了。
Q: 重启 wescode 后要重新索引吗?
不需要。 索引数据持久化在本地 SQLite 数据库里。
关闭 wescode 再打开同一个项目时,索引从磁盘加载——不是重新构建。加载速度:
| 项目规模 | 索引文件大小 | 冷启动加载时间 |
|---|---|---|
| 1 万行 | ~2 MB | < 0.5 秒 |
| 10 万行 | ~15 MB | ~1 秒 |
| 50 万行 | ~80 MB | ~2 秒 |
| 100 万行+ | ~300 MB | ~3 秒 |
加载完成后,CKG 会做一次增量 diff——对比文件系统和索引的时间戳,只重新索引你关机后改动过的文件。如果你昨天关机后没动过代码,增量 diff = 0 个文件需要更新,整个过程在 1 秒内完成。
Q: 跟 Cursor 的索引比呢?
这是两种完全不同的索引方式:
| 维度 | wescode CKG | Cursor Embedding |
|---|---|---|
| 索引位置 | 本地 SQLite(你的机器) | 远程服务器(Cursor 后端) |
| 索引内容 | AST 解析 → 调用图 + 符号表 + 类型关系 | 代码文本 → 向量嵌入 |
| 能回答什么 | "谁调用了这个函数" "这个接口的所有实现" | "跟这段代码语义相似的代码" |
| 首次索引速度 | 中型项目 ~30 秒 | 中型项目 ~1-2 分钟(含上传) |
| 离线可用 | 完全离线 | 需要联网 |
| 代码上传 | 不上传 | 上传到 Cursor 服务器 |
CKG 的优势是精确。 当模型需要知道"UserService.createUser() 被哪些 controller 调用了"时,CKG 给出的是从调用图里提取的确定性答案,不是向量近似搜索的"相似"结果。
CKG 的劣势是覆盖面。 对于深度支持的语言(TS/Python/Java/Go),CKG 的调用图覆盖率 >95%(内部测试数据)。对于其他语言,退回到 tree-sitter 基础分析,能力不如 Cursor 的全量 embedding。
Q: 内存占多少?
CKG 索引数据存在 SQLite 文件里,运行时只加载需要查询的部分。实测内存占用:
| 项目规模 | 索引文件大小 | wescode 额外 RSS |
|---|---|---|
| ~500 文件 | 2-5 MB | ~30 MB |
| ~5,000 文件 | 15-40 MB | ~80 MB |
| ~50,000 文件 | 80-200 MB | ~200 MB |
| ~200,000 文件 | 300-500 MB | ~400 MB |
作为参考,VS Code 打开同一个大型项目的基线内存大约在 400-800 MB。CKG 的额外开销跟装 3-4 个普通扩展差不多。
对比 Cursor 的内存占用: Cursor 的 Embedding 索引数据存在远端,本地内存占用主要是 Embedding 客户端缓存(约 100-300MB,取决于项目大小和缓存策略)。CKG 因为在本地存了完整的调用图结构,中大型项目的内存会比 Cursor 略高——但换来的是离线可用 + 查询确定性。

Q: 大仓(monorepo)有什么优化技巧?
如果你的项目超过 10 万文件,以下配置能显著改善体验:
1. 排除不需要索引的目录
// .vscode/settings.json
{
  "files.exclude": {
    "**/node_modules": true,
    "**/vendor": true,
    "**/dist": true,
    "**/.git": true,
    "**/generated": true
  }
}
CKG 会自动跳过 .gitignore 列出的文件,但额外的 files.exclude 可以进一步减少扫描范围。实测一个 monorepo,排除 node_modules + vendor + generated 后,扫描文件数从 20 万降到 3 万,首次索引从 12 分钟降到 40 秒——因为生成代码和第三方依赖占了 85% 的文件量但 0% 的分析价值。
2. 多 workspace 拆分
如果你的 monorepo 是多个独立服务,考虑用 VS Code 的 Multi-root Workspace 打开关注的子目录,而不是整个仓库根目录。每个 workspace folder 会建自己的 CKG 索引——这不仅更快,还让上下文更精确。
例如,一个包含 api/(Go)、web/(TypeScript)、ml/(Python)三个服务的 monorepo,分别打开三个窗口而不是一个窗口打整个根目录。每个 CKG 只索引相关的代码,调用图更干净——AI 在 web/ 窗口里不会被 Go 代码干扰。
3. 关注索引进度指示器
状态栏的索引进度会显示当前阶段(扫描 → 解析 → 构建调用图 → 写入),如果某阶段卡了超过预期,通常是碰到了一个特别大的文件或复杂的 import 链。
Q: 索引跑不起来怎么排查?
几个常见情况和解法:
症状 1:状态栏一直显示"索引中",长时间不完成
可能原因:项目里有超大生成文件(比如 proto 编译的 .pb.go、Swagger 生成的 .ts、SQL dump 文件)。tree-sitter 解析这类文件会很慢。
解法:把这些目录加到 files.exclude。
症状 2:索引完成了,但 AI 回答"找不到调用关系"
可能原因:文件语言不在 CKG 深度支持列表里(参见"支持哪些语言"那篇 FAQ),或者 tree-sitter 语法包没安装。
解法:确认你的文件扩展名被正确识别了(状态栏右下角会显示语言类型),如果显示 Plain Text 而不是对应语言,安装对应的 language extension。
症状 3:项目一改就重新索引全量
这不应该发生。CKG 有增量索引——只重新解析变更的文件。如果你观察到每次保存都触发全量索引,可能是索引文件损坏了。
解法:打开命令面板 → 搜索 "wescode: Rebuild Index" → 执行一次全量重建。这会清除旧索引并从头构建。
症状 4:索引速度远慢于上表预期
可能原因:CPU 被其他进程占满了(Docker Desktop、Chrome 开了 50 个 tab、Zoom 会议中)。CKG 的索引是 CPU 密集型任务(tree-sitter 解析 + 调用关系推导),会受 CPU 负载影响。
解法:先关掉不需要的高 CPU 进程,或者就等它在后台慢慢跑完——反正不影响编辑。
症状 5:打开新项目后旧项目的索引被丢了
这不会发生。每个 workspace 有独立的索引目录(cells/ws-{hash}/index/),互不影响。如果你觉得"旧项目索引丢了",更可能是你用了不同的路径打开了同一个项目(比如一次用 ~/projects/myapp,一次用 /Users/me/projects/myapp),导致 Cell ID 不同。建议始终用同一个路径打开项目。
Q: 索引数据安全吗?如果 SQLite 坏了呢?
索引数据存在 $XDG_DATA_HOME/wescode/cells/ws-{hash}/ 目录下。SQLite 使用 WAL 模式运行,有以下保护:
- 进程排他锁: 同一时刻只有一个 wescode 进程可以写入索引
- 崩溃恢复: SQLite WAL 模式保证即使进程异常退出,数据不会损坏
- 重建不丢数据: 索引是从源码生成的派生数据,任何时候都可以安全重建——源码在,索引就能恢复
索引不是你的数据,是你的数据的缩影。 坏了就重建,没有任何损失。
跟 Cursor 对比: Cursor 的 Embedding 索引存在远端服务器上。如果 Cursor 的索引服务出故障——你在本地什么都做不了,只能等他们恢复。CKG 的索引在你的硬盘上,你是唯一的控制方。代价是占磁盘空间(中型项目 ~30MB,大型项目 ~200MB)。
Q: 索引数据包含我的源代码吗?
索引包含:
- 函数/类/变量的名字和签名
- 文件路径
- 调用关系(A 调用 B)
- 行号和位置信息
索引不包含:
- 函数体的完整代码(实现逻辑无法从索引还原)
- 注释的完整文本
- 字符串字面量的值(API Key、密钥不会进入索引)
- 测试数据和 fixture 内容
也就是说,从索引文件里能还原你的代码结构(API 形状),但还原不了代码实现。这对安全审计有意义——即使索引文件泄露,泄露的也只是结构元数据,不是可执行的代码。对比 Cursor:Embedding 索引包含代码文本的向量表示,理论上可以通过逆向工程部分还原原始代码内容。
Q: 多个项目同时打开,索引会互相影响吗?
不会。 wescode 的设计是「1 workspace = 1 Cell」——每个项目有独立的索引和数据库。同时打开 3 个项目窗口,意味着 3 个独立的 CKG 实例各自运行。
内存按项目独立计算:3 个中型项目 ≈ 3 × 80MB = 240MB 额外内存。如果你的机器内存紧张(8GB),建议不要同时打开超过 2 个大型项目。
索引队列策略: 如果你同时打开了 3 个从未索引过的项目,CKG 会逐个处理(先完成焦点窗口的项目,再处理后台窗口的),不会三个并行索引抢 CPU。
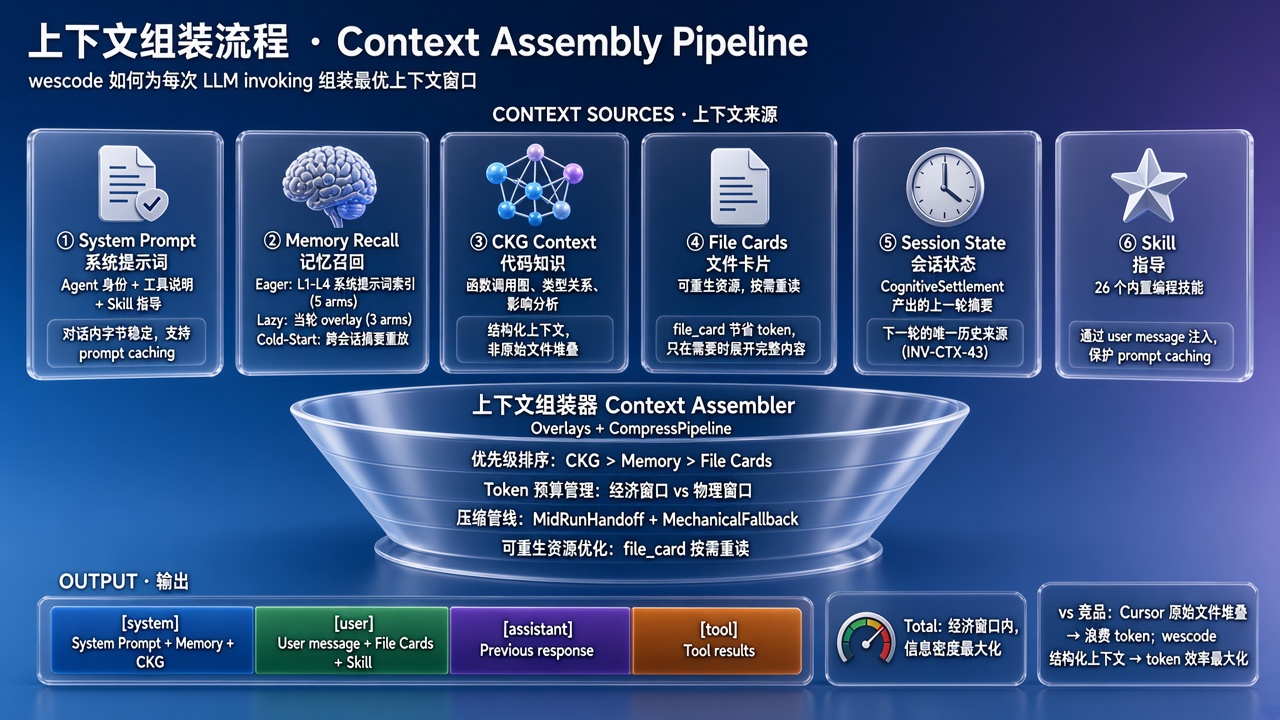
总结一下索引的核心设计选择:
| 设计选择 | 我们选了什么 | 为什么 | 代价 |
|---|---|---|---|
| 索引位置 | 本地 | 安全、离线可用、速度不受网络限制 | 占磁盘空间 |
| 索引算法 | tree-sitter AST 解析 | 精确的调用图,不是模糊的语义相似 | 不同语言支持深度不同 |
| 更新策略 | 增量(只重索引变更文件) | 编辑不卡 | 首次全量需要等一会 |
| 持久化 | SQLite | 重启秒加载,崩溃不丢数据 | 数据库文件需要管理 |