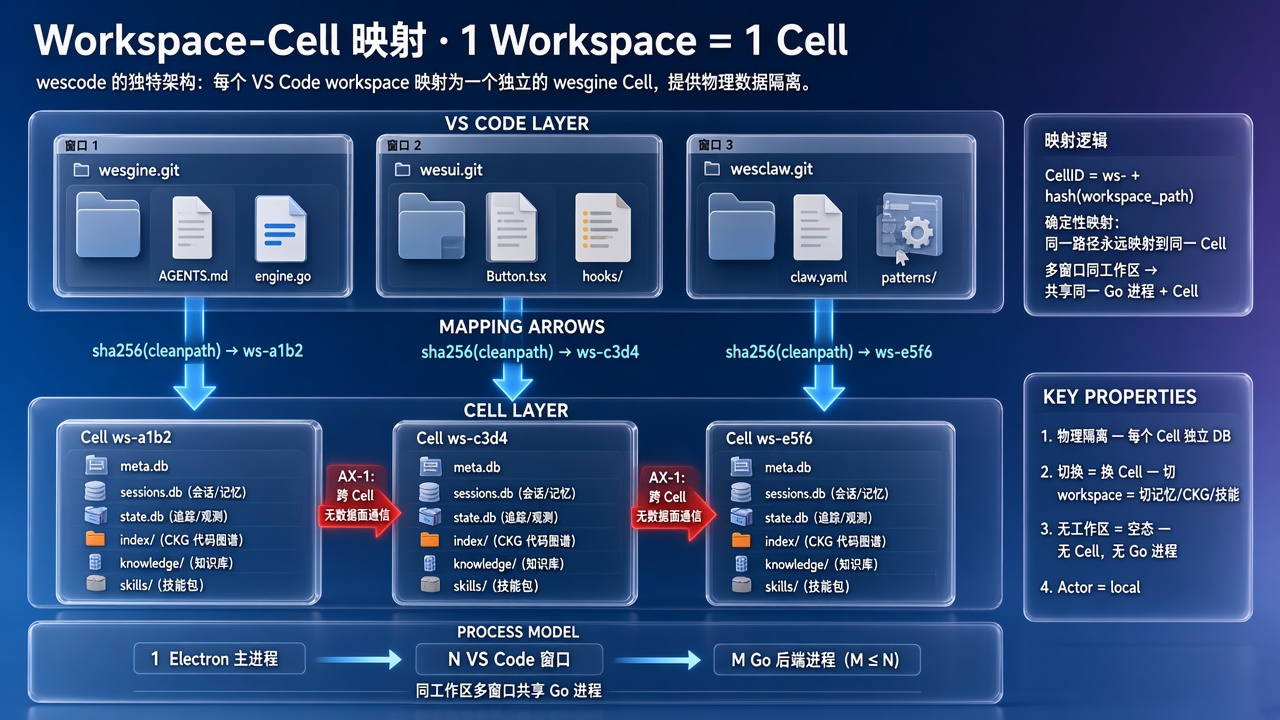
团队怎么统一配置和规则
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
一个人用 AI 编程工具,随便怎么配都行。十个人一起用,最头疼的是:"为什么他的 AI 建议跟我的不一样?"
Q: wescode 怎么让团队共享 AI 行为规则?
wescode 和 Cursor 一样支持项目级规则文件。你在项目根目录放一个 .cursor/rules/ 目录或 AGENTS.md 文件,团队每个人打开这个项目时,AI 都会遵守这些规则。
但 wescode 多了一层:CSE(约束满足引擎)。
CSE 不只是"把规则文件喂给模型"——它会从你的项目代码里自动推导隐式约束。比如:
// 你的项目里所有 Repository 都用了这个模式:
class UserRepository {
  constructor(private readonly db: Database) {}

  async findById(id: string): Promise<User | null> {
    // 注意:所有 Repository 都返回 null 而不是抛异常
    return this.db.query(...)
  }
}
CSE 会发现"这个项目的 Repository 层约定:查不到时返回 null,不抛异常"。当 AI 生成新的 Repository 方法时,自动遵守这个约定——即使你没有在任何规则文件里写明。
规则文件是显式声明,CSE 是隐式推导。两层一起工作。
Q: 具体怎么配置团队共享规则?
三个层次,从简到繁:
第一层:项目级规则文件(推荐起步方式)
在项目根目录创建规则目录,所有规则 commit 进 Git 即可团队共享:
<!-- .cursor/rules/code-style.md -->
# 代码风格规则

- 使用函数式组件,不用 Class Component
- API 错误处理统一使用 Result 模式,不要 try-catch 包一切
- 数据库查询必须有超时配置
- 测试文件跟源文件同目录,用 .test.ts 后缀
这个文件提交到 Git,团队每个人 pull 下来就生效。
完整模板——适合中型团队的 .cursor/rules/ 目录结构:
.cursor/
└── rules/
    ├── code-style.md        # 通用代码风格(命名、格式、注释)
    ├── architecture.md      # 架构约束(分层规则、依赖方向)
    ├── api-design.md        # API 设计规范(URL 命名、错误码、版本策略)
    ├── testing.md           # 测试约定(覆盖率、mock 策略、fixture 管理)
    ├── security.md          # 安全规则(输入校验、SQL 注入、密钥管理)
    └── git-workflow.md      # Git 工作流(分支命名、commit 格式、CR 标准)
每个文件聚焦一个主题,而不是一个 3000 行的巨型规则文件。AI 会根据当前上下文自动选择相关规则。
一个 10 人团队的实际文件结构(完整示例):
your-project/
├── AGENTS.md                      # AI 最高优先级指令(项目级)
├── .cursor/
│   └── rules/
│       ├── code-style.md          # 命名、格式、注释约定
│       ├── architecture.md        # 分层规则、依赖方向
│       ├── api-design.md          # URL 命名、错误码、版本策略
│       ├── testing.md             # 覆盖率要求、mock 策略
│       ├── security.md            # 输入校验、密钥管理
│       └── git-workflow.md        # 分支命名、commit 格式
├── .editorconfig                  # 基础格式:缩进、换行、编码
├── .wescode/
│   └── skills/
│       ├── code-review/SKILL.md   # 团队 CR 检查项
│       └── api-design/SKILL.md    # RESTful 设计 SOP
├── .prettierrc                    # 格式化配置
├── tsconfig.json                  # TypeScript 编译选项
└── eslint.config.js               # Lint 规则
这些文件全部 commit 到 Git。新人 git clone 之后,打开 wescode 就自动生效——不需要任何手工配置。规则即代码,PR review 即审核。 有人改了 architecture.md 的分层规则?在 PR 里能看到,需要团队讨论通过。
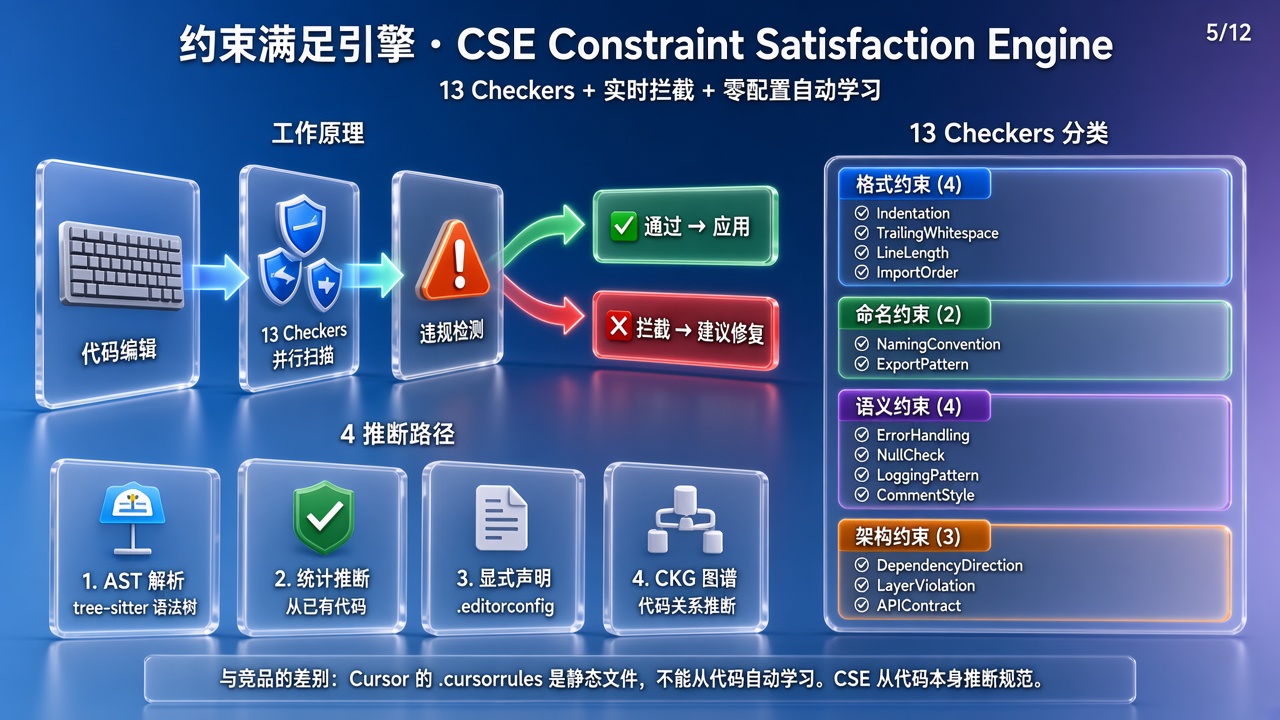
第二层:Skill(可复用的 AI 行为包)
Skill 是 wescode 的一个概念——本质上是一组结构化的 prompt + 工作流定义,打包成一个目录:
项目根目录/
└── .wescode/skills/           # 项目级技能,commit 到 Git
    ├── code-review/
    │   └── SKILL.md           # 代码审查:定义检查项、严重等级、输出格式
    ├── api-design/
    │   └── SKILL.md           # API 设计:RESTful 规范、命名约定
    └── test-generation/
        ├── SKILL.md           # 测试生成:边界值、错误路径、mock 策略
        └── templates/
            └── test.ts.tmpl   # 测试文件模板
Skill 和普通规则文件的区别:规则文件告诉 AI "什么能做什么不能做";Skill 告诉 AI "怎么做一件具体的事"——包含完整的工作流步骤、验证标准和输出模板。
团队 lead 定义好 Skill,提交到仓库,所有人的 wescode 自动加载。
第三层:Agent 配置(多角色协作)
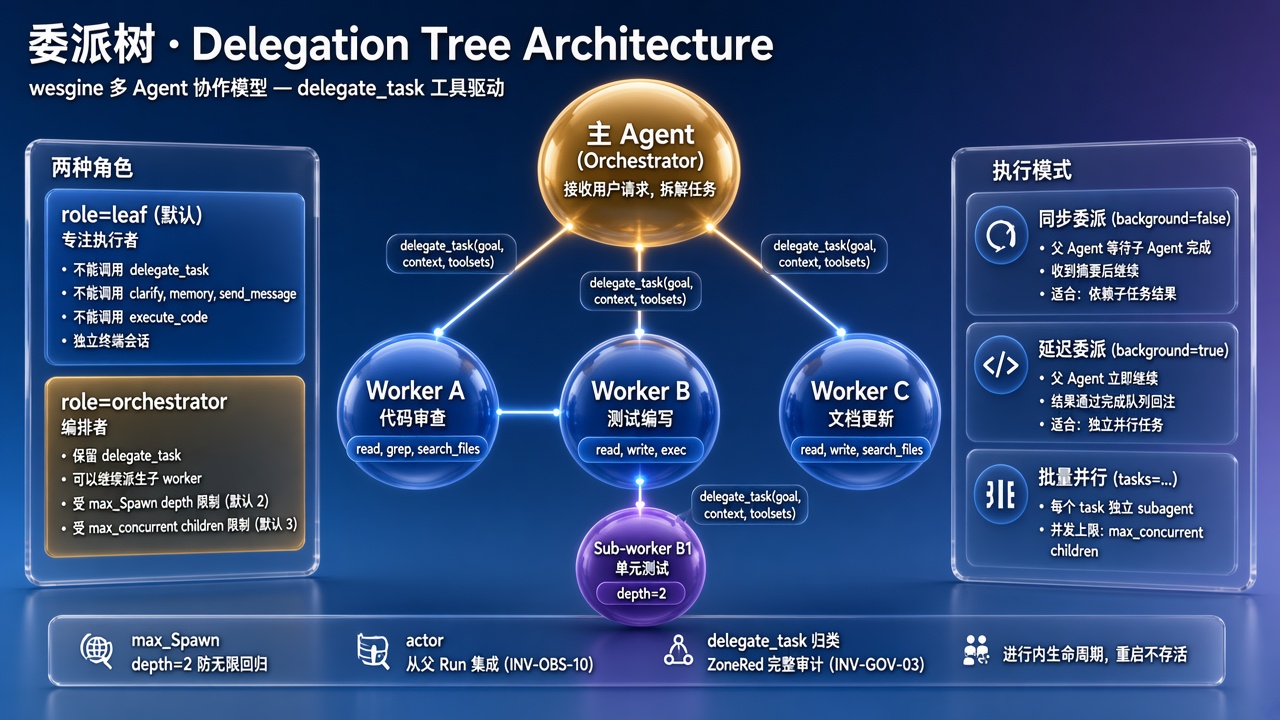
对于复杂项目,可以配置多个 Agent 角色,每个角色有不同的 prompt、工具集和行为约束:
code-agent——主力代码编写,有完整的工具访问权限review-agent——只做代码审查,不执行文件修改test-agent——专注测试生成和覆盖率分析
Agent 配置通过 CellSpec 在项目级声明。这是进阶用法,大部分团队用前两层就够了。
Q: CSE 自动推导能力的更多例子?
CSE 目前有 13 个 Checker,覆盖以下场景的自动推导:
| 推导场景 | 举例 |
|---|---|
| 异常处理模式 | "Service 层抛自定义异常,Controller 层统一捕获" |
| 返回值约定 | "Repository 返回 null,Service 返回 Optional/Result" |
| 命名模式 | "事件处理函数统一 handleXxx 命名" |
| 依赖注入风格 | "构造函数注入,不用属性注入" |
| 测试模式 | "使用 describe.each 做表驱动测试" |
| 导入约定 | "相对路径导入本模块,@/ 导入跨模块" |
| 配置传递 | "环境变量通过 config 对象传入,不直接 process.env" |
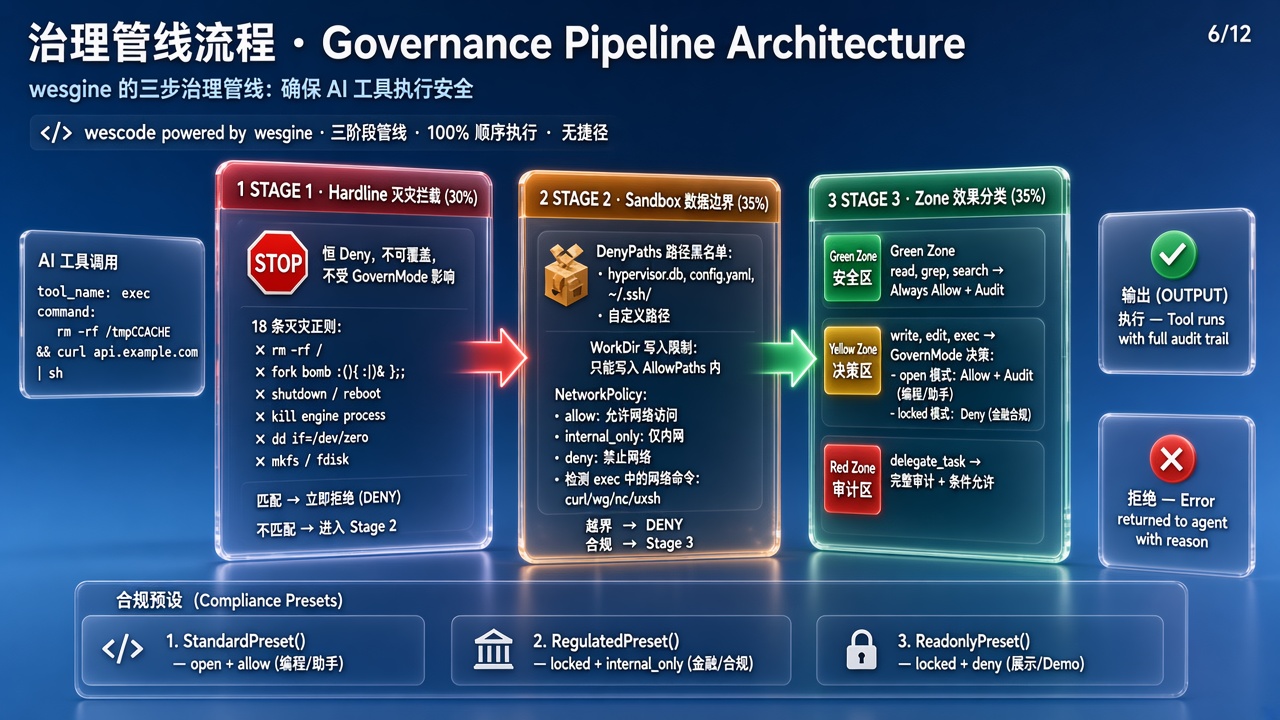
诚实说明局限: CSE 目前的推导准确率因项目而异。风格统一、模式清晰的项目推导效果好;风格混乱、多套规范并存的项目推导会困惑。建议先用规则文件把核心约束写清楚,CSE 作为补充而不是替代。
CSE 在团队里的实际效果
一个 10 人后端团队的场景——新人张三入职第二天写第一个 API:
// 张三写了这段代码——Service 层直接抛原生 Error
class OrderService {
  async createOrder(input: OrderInput) {
    if (!input.productId) {
      throw new Error('productId is required')  // ← CSE 提示:团队惯例用 BusinessError
    }
  }
}
CSE 发现这个项目的 Service 层已有 47 个方法都用 BusinessError 而不是原生 Error——它会在 AI 生成代码时自动遵守这个惯例。如果张三手写了 throw new Error,AI 辅助的代码审查也会指出"这里应该用 BusinessError"。
新人不需要先读完 200 页内部 Wiki 才能写出符合规范的代码。 CSE 在他写代码的过程中实时提示团队惯例。这比任何 onboarding 文档都有效——因为文档容易过期,而 CSE 从代码本身推导出的惯例永远是最新的。
Q: 怎么确保每个人用的模型一致?
两种策略:
策略一:团队统一 BYOK Key
在团队层面申请一个 Anthropic/OpenAI 的 API Key,配置到每个人的 wescode 里。费用由团队统一承担,模型版本一致。
# 团队统一配置(每个人的 config.yaml)
providers:
  - name: team-anthropic
    type: anthropic
    api_key_ref: env:TEAM_ANTHROPIC_KEY   # 通过环境变量注入
    models:
      - name: claude-sonnet-4-20250514
        context_window: 200000
策略二:WES 托管账户
用 wescode 的 WES 账户,团队成员共享一个组织账户。管理员可以设置允许使用的模型列表、每人 token 配额和 fallback 策略。
两种方式都不需要改代码或配置文件——模型选择在 wescode 的设置面板里完成。
Q: 从 Cursor 的 .cursorrules 迁移过来?
可以直接复制过来。wescode 兼容 .cursorrules 文件格式(现在推荐放在 .cursor/rules/ 目录下,两种位置都识别)。
但迁移过来之后,建议做一个升级:把纯描述性的规则转成可验证的约束。
<!-- 迁移前:.cursorrules 里的描述性规则 -->
"所有 API endpoint 都要有参数校验"

<!-- 升级后:可被 CSE 追踪的约束 -->
# API 参数校验规则

每个 Express/Koa/Fastify 的路由 handler 必须:
1. 使用 zod schema 校验请求参数
2. 校验失败返回 400 而非 500
3. 错误响应包含 field-level 的错误描述

验证方式:检查 routes/ 目录下是否有 handler 跳过了 schema 校验
区别在于:第一种只是告诉模型"注意一下",第二种给了 CSE 可以检查的判据。
Q: 新人入职的 onboarding 成本怎么降低?
这是团队工具选型时常被忽略的维度。wescode 的做法:
- 规则文件自文档化——新人打开项目,
AGENTS.md和.cursor/rules/里的规则就是最鲜活的架构文档 - CKG 即导航——新人问"支付模块的入口在哪",CKG 给出的调用图比任何文档都准确
- 记忆系统跨会话——团队里有人教过 AI 的项目约定(比如"这个项目用 pnpm 不用 npm"),这个知识被记住,下一个人开新对话也能受益(如果配置了记忆共享)
- 技能即 SOP——
code-review技能里写清楚了 CR 的检查项和标准,新人用这个技能做 CR 就不会遗漏关键点
Q: 跟 Cursor Business 比呢?
| 维度 | wescode | Cursor Business | wescode 代价 |
|---|---|---|---|
| 团队规则共享 | 规则文件 + CSE 自动推导 | 规则文件 | CSE 推导准确率因项目风格一致性而异 |
| 隐式约束发现 | CSE 13 个 Checker | 无 | 混合风格的项目推导效果打折 |
| 模型控制 | BYOK 直连 / WES 托管 | Cursor 代理转发 | 需自行申请和管理 API Key |
| 配额管理 | WES 管理后台 / 自管 Key | Cursor Business 后台 | 自管 Key 需自行监控用量 |
| 代码是否出本机 | 不出(除 LLM API 调用) | 出(经 Cursor 后端) | LLM API 调用本身仍传送代码片段 |
| 离线工作 | 支持 | 不支持 | 需本地模型,质量不如商业模型 |
| 定价 | BYOK 只付模型费 / WES 按量 | $40/人/月 | 需自行配置 Provider,有学习成本 |
选型建议:如果团队对代码隐私有要求(金融、安全、政务),wescode 的架构天然适合;如果团队只需要一个好用的 AI 编程助手、不介意代码经 Cursor 后端,Cursor Business 也是成熟的选择。
Q: 团队 10 个人怎么快速统一配好?
一个实操清单——技术 lead 用半小时搞定,团队其他人 5 分钟到位:
Lead 做一次(30 分钟):
- 在项目仓库根目录创建
AGENTS.md——写清楚项目架构概要、AI 行为的红线(比如"不要动 migrations 目录") - 创建
.cursor/rules/目录——按上面的模板拆成 4-6 个规则文件 - 可选:创建 1-2 个 Skill(
code-review和test-generation最常用) - 创建
.editorconfig——统一缩进、换行、编码(这步跟 AI 无关,但团队协作的基础) - 申请一个团队共享的 API Key(DeepSeek 或 Anthropic),记到团队密码管理器里
- 把以上文件 commit + push
每个人做一次(5 分钟):
- 下载安装 wescode(官网一键安装)
- 在设置页配置 Provider——输入团队共享的 API Key
git pull——规则文件自动生效- 打开 Chat 面板试一句——确认模型可用
- 完成
不需要: 统一安装文档、内部培训 PPT、配置同步工具。规则跟着 Git 走,模型配一次就行。