断网能用吗,飞机上呢
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
简短回答:部分可以。 编辑器功能完全离线可用;AI 对话取决于你的模型接入方式。
Q: 离线时哪些功能可用、哪些不可用?
| 功能 | 离线可用? | 说明 |
|---|---|---|
| 代码编辑 | ✅ 完全可用 | VS Code 所有编辑功能 |
| 语法高亮 | ✅ 完全可用 | tree-sitter 本地运行 |
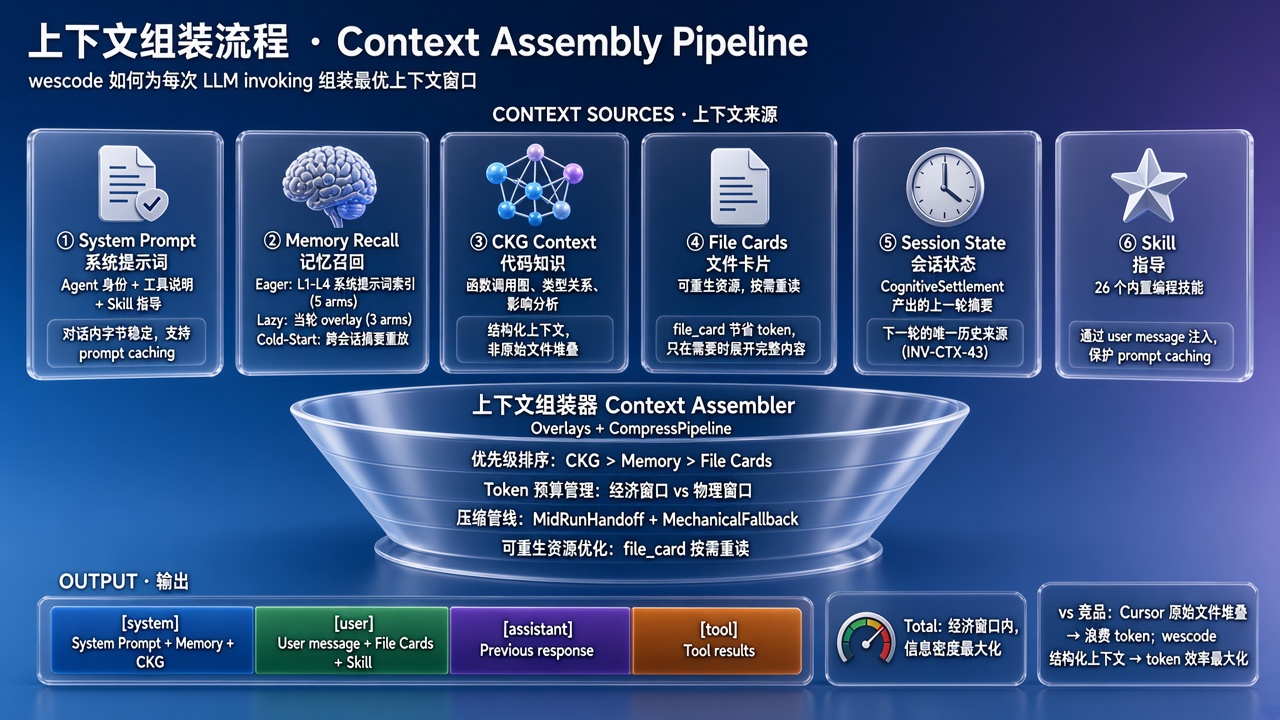
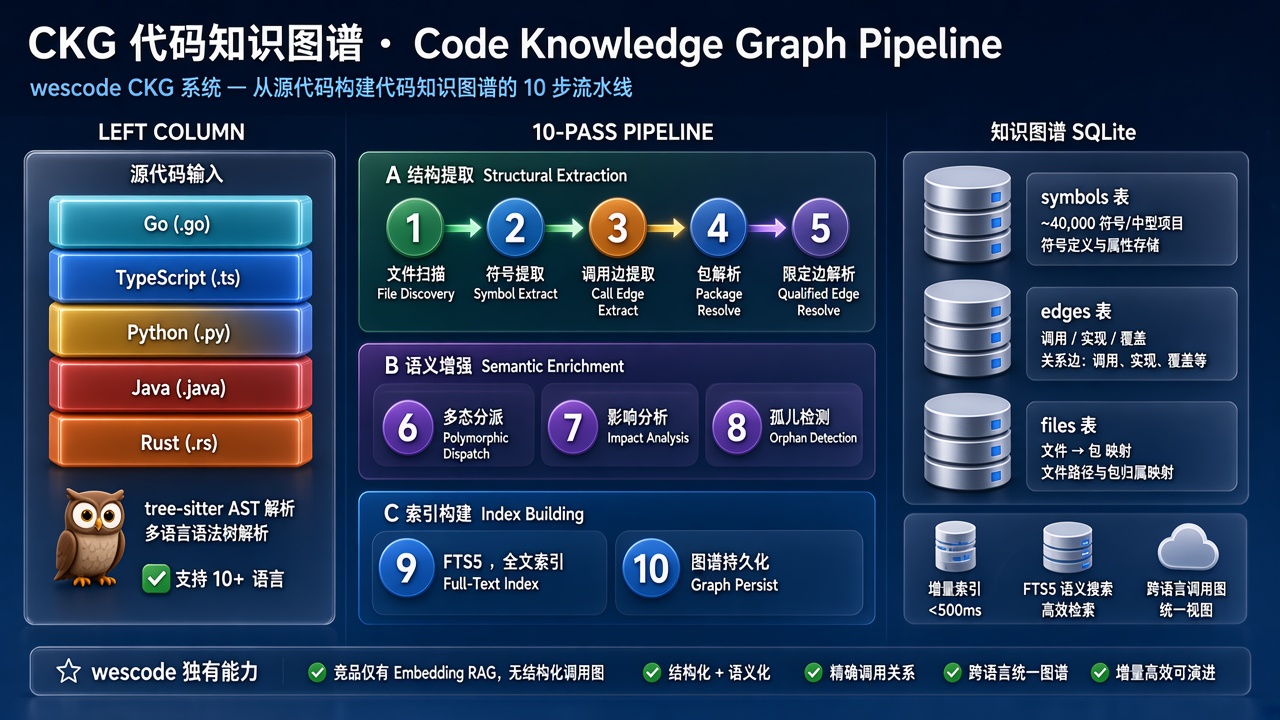
| CKG 代码知识图谱 | ✅ 完全可用 | 索引在本地 SQLite,查询不联网 |
| 调用图导航 | ✅ 完全可用 | 从索引读取 |
| Git 操作(本地) | ✅ 完全可用 | commit、branch、diff 等 |
| 扩展功能 | ✅ 已安装的扩展正常工作 | 安装新扩展需要联网 |
| AI 对话(WES 账户) | 不可用 | 需要连 WES Proxy |
| AI 对话(BYOK 云端 Key) | 不可用 | 需要连 API 端点 |
| AI 对话(本地模型) | ✅ 完全可用 | Ollama/vLLM 本机运行 |
| 记忆系统读取 | ✅ 可用 | 数据在本地 SQLite |
| 记忆系统写入 | ✅ 可用 | 同上 |
| 技能(Skill)使用 | ✅ 可用 | Prompt 文件在本地 |
| 自动补全(Ghost Text) | 取决于 LLM 是否可达 | 本地模型可用,云端模型不可用 |
| Git push/pull | 不可用 | 需要联网 |
| 扩展市场 | 不可用 | 需要联网 |
核心要点:wescode 本身不需要联网。需要联网的只有 LLM API 调用和 Git 远程操作。

Q: 飞机上 3 小时没网,我能用 wescode 做什么?
一个具体的场景清单——假设你在飞上海到成都的航班上,笔记本电脑开着 wescode,没有 WiFi,提前配好了 Ollama 本地模型:
完全可做(跟联网时一模一样):
- ✅ 用 CKG 调用图分析"这个函数被谁调用了"——1 workspace = 1 Cell,整张图在本地
- ✅ 翻阅上周的对话历史,回忆某个架构决策是怎么讨论的
- ✅ 用 AI 帮你 debug 一个本地可复现的 bug(本地模型)
- ✅ 写代码、格式化、lint、跑本地测试(
npm test、pytest) - ✅ Git commit、branch、diff、blame——所有本地 Git 操作
- ✅ 查阅项目记忆——上次 AI 记住的"这个项目用 pnpm 不用 npm"还在
- ✅ 使用已安装的 Skill——prompt 文件都在本地
- ✅ 重构代码时查看影响面分析——CKG 的 3 级传递追踪离线可用
可做但体验打折(本地模型限制):
- ⚠️ 让 AI 帮你做跨 5+ 文件的大重构——本地 32B 模型可能遗漏关联修改
- ⚠️ 问 AI 复杂的架构建议——回答会比 Claude Sonnet 4 泛泛
- ⚠️ 生成长段代码——质量和商业模型有差距
做不了:
- Git push/pull(需要网络)
- 安装新扩展(需要访问扩展市场)
- 用云端商业模型对话(API 不可达)
- 下载新的 Ollama 模型(需要网络,所以要提前下好)
3 小时的高产出方案: 把需要深度推理的任务(架构设计、复杂 bug 分析)留到有网时用商业模型做。飞机上专注写代码 + 跑测试 + CKG 导航 + 本地模型辅助简单任务。
Q: 怎么配本地模型实现完全离线?
最成熟的方案是 Ollama。以下是完整的离线配置流程:
第一步:安装 Ollama 并下载模型
# macOS / Linux
curl -fsSL https://ollama.ai/install.sh | sh

# 下载一个适合编程的模型
# 推荐 Qwen2.5-Coder 32B(需要 ~20GB 显存)
ollama pull qwen2.5-coder:32b

# 或者轻量版(8GB 显存即可)
ollama pull qwen2.5-coder:7b

# 启动服务
ollama serve
最简三步速配(适合赶飞机前 5 分钟操作)
- 装 Ollama + 下模型:
curl -fsSL https://ollama.ai/install.sh | sh && ollama pull qwen2.5-coder:7b - 在 wescode 设置页 Provider 里加一行:
base_url = http://localhost:11434/v1 - 点"测试连接"——绿色就行,切成默认模型,断网试一句
以下是详细配置:
第二步:在 wescode 中配置
# 设置页 → Provider 配置
# 或编辑 config.yaml:
providers:
  - name: ollama-local
    type: openai_compatible
    base_url: http://localhost:11434/v1
    models:
      - name: qwen2.5-coder:32b
        context_window: 32768
不需要 API Key(Ollama 本地不鉴权),配好 base_url 就行。
第三步:验证
在设置页点「测试连接」。测试通过后,把默认模型切换到 qwen2.5-coder:32b。断网,开一个 Chat,问一个关于当前项目的问题——如果能正常回答,说明离线链路通了。
性能预期(诚实告知)
本地模型跟 Claude Sonnet 4 或 GPT-4.1 相比有明显差距:
| 场景 | Claude Sonnet 4 | Qwen2.5-Coder 32B (本地) |
|---|---|---|
| 单文件 bug 修复 | 一次命中率 ~85%(内部测试数据) | 一次命中率 ~60%(内部测试数据) |
| 跨文件重构 | 可靠 | 经常遗漏关联修改 |
| 架构建议 | 深入且有洞察 | 泛泛而谈偏多 |
| 代码解释 | 准确 | 大体准确,细节偶有错误 |
| 响应速度 | 1-3 秒开始流式 | 取决于硬件,7B ~1秒,32B ~3-5秒 |
建议: 如果你大部分时间有网,日常用云端模型(质量高),把本地模型作为离线/高铁/飞机上的 fallback。wescode 支持同时配多个 Provider,按需切换。
本地模型选型指南
不同硬件配置适合不同的模型:
| 你的硬件 | 推荐模型 | 下载命令 | 效果预期 |
|---|---|---|---|
| MacBook Air M2 (8GB) | Qwen2.5-Coder 3B | ollama pull qwen2.5-coder:3b | 简单补全可用,复杂任务吃力 |
| MacBook Pro M3 (16GB) | Qwen2.5-Coder 7B | ollama pull qwen2.5-coder:7b | 日常开发基本够用 |
| MacBook Pro M3 Max (36GB+) | Qwen2.5-Coder 32B | ollama pull qwen2.5-coder:32b | 接近商业模型 8 成水平 |
| RTX 4090 (24GB VRAM) | Qwen2.5-Coder 32B Q4 | ollama pull qwen2.5-coder:32b-instruct-q4_K_M | 同上,GPU 推理更快 |
| CPU only (无 GPU) | Qwen2.5-Coder 3B | ollama pull qwen2.5-coder:3b | 能用但慢,应急用 |
关键提示: Apple Silicon Mac 的 Neural Engine 对量化模型支持很好,实测 M3 16GB 跑 7B 模型流式输出几乎无延迟。Intel Mac 或纯 CPU 机器建议只跑 3B 模型。
Q: 企业内网(无外网)怎么部署?
这是我们收到最多的企业需求之一。方案如下:
方案 1:内网自建 LLM 服务
在内网服务器部署 vLLM 或 Ollama,wescode 连接内网端点:
providers:
  - name: internal-llm
    type: openai_compatible
    base_url: http://10.0.1.100:8000/v1
    api_key: internal-token
    models:
      - name: company-model
        context_window: 32768
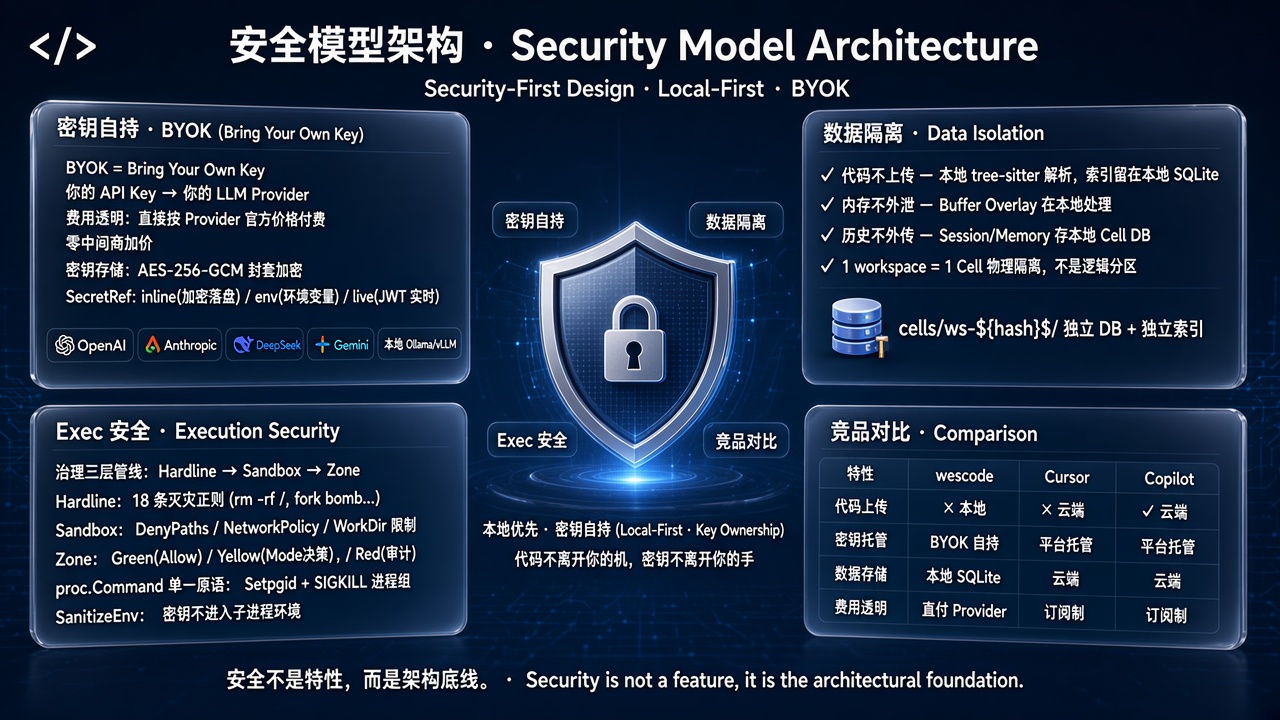
关键点: wescode 不依赖任何云端服务。只要你的 LLM 服务暴露 OpenAI 兼容的 HTTP 端点,wescode 就能连。CKG 索引、记忆系统、技能——全部在本地运行,不需要任何外网连接。
方案 2:反向代理转发
如果公司允许通过审批的外网代理访问特定 API,你可以在代理层配置允许访问 api.anthropic.com 或 api.deepseek.com,然后在 wescode 里配代理:
# 系统代理
export HTTPS_PROXY=http://proxy.company.com:8080

# 或在 wescode 设置中配置代理
方案 3:网闸 + 中间服务器
最严格的安全环境(金融、军工)可能有网闸隔离。这种情况下,你需要在网闸允许的通道里部署一个 LLM Proxy 服务,做请求审计和转发。这超出了 wescode 本身的范围,但 wescode 的 BYOK 架构天然支持——任何 HTTP 端点都行。
企业客户常见的三种部署形态总结:
| 形态 | 安全等级 | LLM 来源 | 网络要求 | 适用场景 |
|---|---|---|---|---|
| 互联网直连 | 低 | 商业 API(Anthropic/OpenAI/DeepSeek) | 正常外网 | 初创团队、个人开发者 |
| 内网自建模型 | 中 | 内网 vLLM/Ollama 集群 | 仅内网 | 金融科技、政企 |
| 网闸 + Proxy | 高 | 审计 Proxy → 外网 API | 网闸受控通道 | 军工、高安全金融 |
Q: 离线时记忆和技能怎么办?
完全不受影响。
- 记忆系统存储在本地 SQLite(
$XDG_DATA_HOME/wescode/cells/ws-{hash}/sessions.db),读写都不需要网络 - **技能(Skill)**是本地 Markdown 文件,存在
cells/ws-{hash}/skills/目录下 - CKG 索引也是本地 SQLite
- 会话历史同样在本地
唯一需要网络的是 LLM API 调用。你的整个工作上下文——代码索引、对话历史、项目记忆、自定义技能——全部离线可用。
为什么这个设计很重要? 很多开发者不知道,Cursor 的记忆、对话历史和项目索引有一部分存在 Cursor 的服务端。断网时你不仅失去了 AI 对话能力,连历史记忆的检索也受影响。wescode 的设计保证断网只影响 LLM API 调用这一条线——其他所有本地功能不受任何网络状态影响。
Q: wescode 本身的更新检查呢?会偷偷联网吗?
wescode 不做自动更新检查。它就是一个本地安装的编辑器,不会在后台偷偷联网。你需要手动到官网下载新版本。
跟 Cursor 不同的是,wescode 没有"每次启动检查 license 有效性"的过程——因为它本来就不需要 license。你下载了、安装了、就能用。
验证 wescode 没有偷偷联网的方法: 断网后打开 wescode,观察——所有编辑器功能、CKG 导航、记忆查看都正常。唯一会报错的地方是 AI Chat 面板(因为 LLM API 不可达),这正好证明了只有 LLM 调用需要网络。你也可以用 macOS 的「网络活动监视器」或 Linux 的 nethogs 看 wescode 进程的网络流量——配好本地模型后,出站流量应该为零。
Q: 如果我在高铁/飞机上,最佳实践是什么?
- 出发前:确保 Ollama 已安装且模型已下载(下载模型需要联网)
- 出发前:确保当前项目已经打开过至少一次(CKG 索引已建好)
- 在途中:把默认模型切到 Ollama 本地模型
- 在途中:正常使用——CKG 调用图、记忆、技能全部离线可用
- 到达后:切回云端模型继续工作
这个切换过程大约需要 3 秒——在设置页选一下模型就行。
一个小技巧: 在 wescode 里可以同时配多个 Provider(比如 DeepSeek 作为日常主力、Ollama 作为离线备用)。模型选择器里所有可用的模型都会列出,你不需要每次进设置页改配置——直接在 Chat 面板的下拉菜单切换就行。
另一个容易忽略的细节: 如果你用 Ollama,确保在出发前跑一下 ollama serve 验证模型可以正常响应。有些用户忘了这一步,到飞机上才发现 Ollama 服务没启动——而这时候 curl https://ollama.ai/install.sh 已经没网了。