让 AI 动三年前的老代码,我到现在都不敢
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
项目里有一个 1500 行的文件,三年没人动过。注释里写着"DO NOT MODIFY"。
谁写的、为什么写这行注释、到底改了会怎样——不知道。git blame 指向一个早就离职的人。
你知道这段代码有问题。性能差。逻辑绕。有好几处明显可以优化的地方。
但你不敢动。人都不敢动,更别说让 AI 动了。
"不敢动"的真实原因
不是因为懒。是因为你不知道三件事:
1. 这段代码被谁调用了
1500 行里有十几个导出的函数。它们各自被哪些地方调用?改了其中一个,波及面是 3 个文件还是 30 个文件?你不知道。
grep 可以搜到字面引用。但如果调用是通过接口、回调、事件总线间接发起的——grep 搜不到。你就少算了一部分影响面。
2. 这段代码有没有隐性的约束
"这个函数的返回值顺序不能变"——为什么?因为下游有一段代码按索引取值。这件事没写在任何文档里。
"这个 Map 的遍历顺序不能变"——为什么?因为序列化依赖了遍历顺序。写代码的人可能自己都忘了。
你改了一行,可能触发一个你完全想不到的副作用。
3. 改完之后行为一样吗
假设你理清了调用方、排除了隐性约束,改了代码。测试全绿。
但"测试全绿"只表示"你写的测试通过了"。排序顺序变了、缓存行为变了、错误类型变了——这些不在测试断言里。
你心里发虚——"测试过了,但真的没问题吗?"这种感觉阻止你合进主干。
给你看看那个 1500 行文件长什么样
// OrderProcessor.ts — 1487 行
// ⚠️ DO NOT MODIFY — 账单计算核心逻辑,涉及多方对账
// 最后修改:2023-04-15 by @zhangwei (已离职)

import { Decimal } from 'decimal.js'
import type { Order, LineItem, TaxRule, DiscountPolicy } from './types'

// ... 47 个内部工具函数 ...

export function calculateDiscount(order: Order, policy: DiscountPolicy): Decimal {
  // 这个函数的返回值被 6 个地方使用
  // 其中 2 个地方直接取 .toNumber(),精度依赖 Decimal 实现
  // 不要改返回类型
  // ... 89 行实现 ...
}

export function applyTaxRules(items: LineItem[], rules: TaxRule[]): LineItem[] {
  // 注意:返回的数组顺序和输入一致
  // invoice.ts 第 234 行依赖这个顺序做 zip
  // ... 120 行实现 ...
}

export function generateInvoiceData(order: Order): InvoicePayload {
  // 这个函数在三年里被改过 4 次
  // 每次改都导致了对账问题,所以加了 DO NOT MODIFY
  // ... 200+ 行实现 ...
}

// ... 还有 12 个导出函数 ...
这就是你面对的东西。注释里全是活人的恐惧——那些注释不是文档,是当年踩坑之后留下的求救信号。

AI 让这件事更难了
你可能想:AI 不是应该让修改老代码更容易吗?
恰恰相反——AI 让你更不敢动。
因为 AI 改得太快了。你让它优化那个 1500 行的文件,它 30 秒改了 8 个地方。你打开 diff 一看:每个改动单独看都合理。但你不知道这 8 个改动叠在一起会不会产生连锁反应。
而且 AI 不会犹豫。你在 rm -rf 前会手指停一下,AI 不会。它把"DO NOT MODIFY"下面的代码改了,因为它不知道那行注释的含义——它只看到一个它认为可以优化的函数。
AI 的速度放大了变更的风险面。 人类一下午改 3 处,你能一处一处核实。AI 30 秒改 8 处,你核实不过来。
"git blame 指向离职的人"——然后呢
这个场景值得展开说,因为几乎每个有三年以上历史的项目都会遇到:
$ git blame OrderProcessor.ts | head -20
a3f7d291 (zhangwei 2023-04-15) // ⚠️ DO NOT MODIFY — 账单计算核心逻辑
a3f7d291 (zhangwei 2023-04-15) // 最后修改:2023-04-15 by @zhangwei
e892bc05 (zhangwei 2023-04-10) export function calculateDiscount(...) {
zhangwei 离职了。你能做什么?
你能做的:
git log --follow OrderProcessor.ts—— 看这个文件的修改历史,但只有 commit messagegit log --all --grep="calculateDiscount"—— 看所有提到这个函数的 commit- 搜 Slack / 飞书的聊天记录 —— 也许当年有人讨论过为什么加这个注释
- 问团队里资历最老的人 —— 他可能知道一些口头传下来的故事
你不能做的:
- 你不能确认注释的原因是否还成立("三年前的对账问题修复了吗?")
- 你不能确认这段代码的所有隐性依赖(文档里没写的那些)
- 你不能靠 git history 知道"改了这个函数还需要改哪里"——commit message 不会告诉你调用关系
所以你做了一个理性的决定:不动。这不是懒,这是信息不足下的最优策略。你宁可带着性能问题上线,也不愿意冒"改了之后对账出错"的风险。
具体走一遍:改 1500 行文件里的一个函数
同一个任务:"优化 OrderProcessor.ts 里的 calculateDiscount 函数",看有工具和没工具的完整流程。
没有 wescode 的做法(约 2-3 小时)
| 步骤 | 做什么 | 花多久 | 确定性 |
|---|---|---|---|
| 1 | grep -rn "calculateDiscount" 搜函数名 → 42 个结果(含注释、字符串、测试) | 2 分钟 | 有噪声,需人工排除 |
| 2 | 逐个打开,排除注释和测试 → 筛出 18 个真实调用方 | 20-30 分钟 | 仍不确定是否漏了间接调用 |
| 3 | 手动追接口实现:DiscountStrategy 接口有 3 个实现类,需要逐个确认哪些调用了 calculateDiscount | 15-20 分钟 | 容易漏掉——接口调用在 grep 里是 strategy.calculate(),函数名不同 |
| 4 | 检查"有没有隐性约束"——翻 git log、读上下文代码、猜 | 20-30 分钟 | 靠经验和运气 |
| 5 | 改代码,跑测试 → 全绿 | 10 分钟 | 测试覆盖不了的行为变化你不知道 |
| 6 | 提 PR → reviewer 打开 1500 行文件的 diff → 他也不确定影响面 | 拖了 1-2 天 | reviewer 心里也没底 |
总计:2-3 小时主动工作 + 1-2 天等 review。而且改完你心里还是发虚。
有 wescode 的做法(约 15-30 分钟)
| 步骤 | 做什么 | 花多久 | 确定性 |
|---|---|---|---|
| 1 | CKG 影响分析:impact_analysis("calculateDiscount") → 列出 18 个直接调用方 + 3 个通过 DiscountStrategy 接口的间接调用方 + 2 个通过事件回调的调用方 | < 2 秒 | 精确——基于预计算的调用图,含接口实现边 |
| 2 | CSE 检查:改动前后自动对比 → "没有违反统计惯例,函数签名未变化" | < 1 秒 | 机械判定,PASS/FAIL |
| 3 | L2.5 行为对比:改动前后自动对比可观测行为 → "返回值结构一致,无类型变化" | < 10 秒 | 基于 AST + 签名比对 |
| 4 | 改代码,提 PR → reviewer 看到工具已经查过的结果(影响面、约束检查、行为对比),确认"是我想要的改动" | 当天 approve | 信心来自工具的验证结果 |
总计:15-30 分钟。而且 reviewer 有工具结果可以参考,不用自己重新排查影响面。
差距在哪:不是 AI 写代码的速度(都一样快),而是确认"改完没问题"的速度——从 2 小时手动排查变成 2 秒图查询。
三层安全网各自做什么
| 安全网 | 回答什么问题 | 怎么做到的 | 做不到什么 |
|---|---|---|---|
| CKG 调用图 | "改了这里还会影响哪里" | 预计算的多维关系图,O(1) 查询代替 O(n) 搜索 | 不覆盖运行时动态绑定(反射、eval) |
| CSE 约束检查 | "有没有破坏没写下来的规矩" | 13 个 Checker 统计推导编码惯例,零配置 | 基于统计,有意的例外会被标为异常 |
| L2.5 行为基线 | "改完之后行为和之前一样吗" | 改动前后 AST + 签名 + 测试结果自动对比 | 不能发现所有语义级的行为变化 |
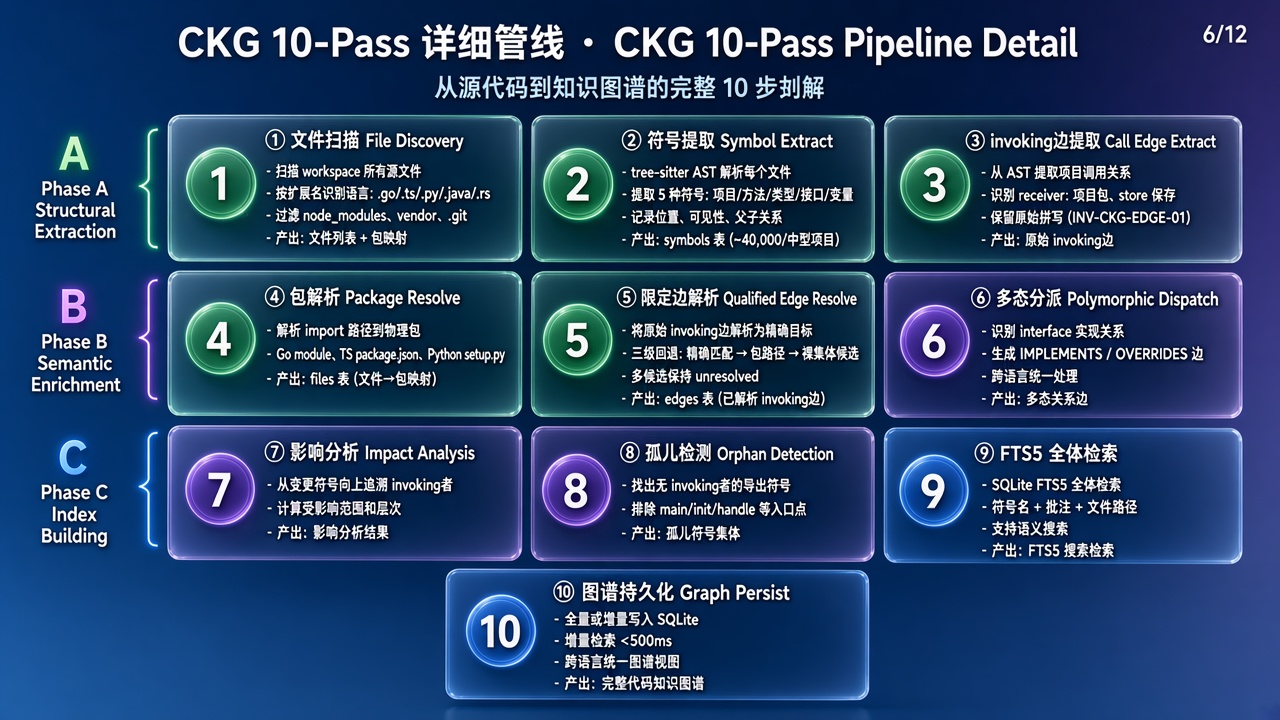
CKG 的六种关系怎么追踪老代码影响面
以 calculateDiscount 为例,完整的追踪过程:
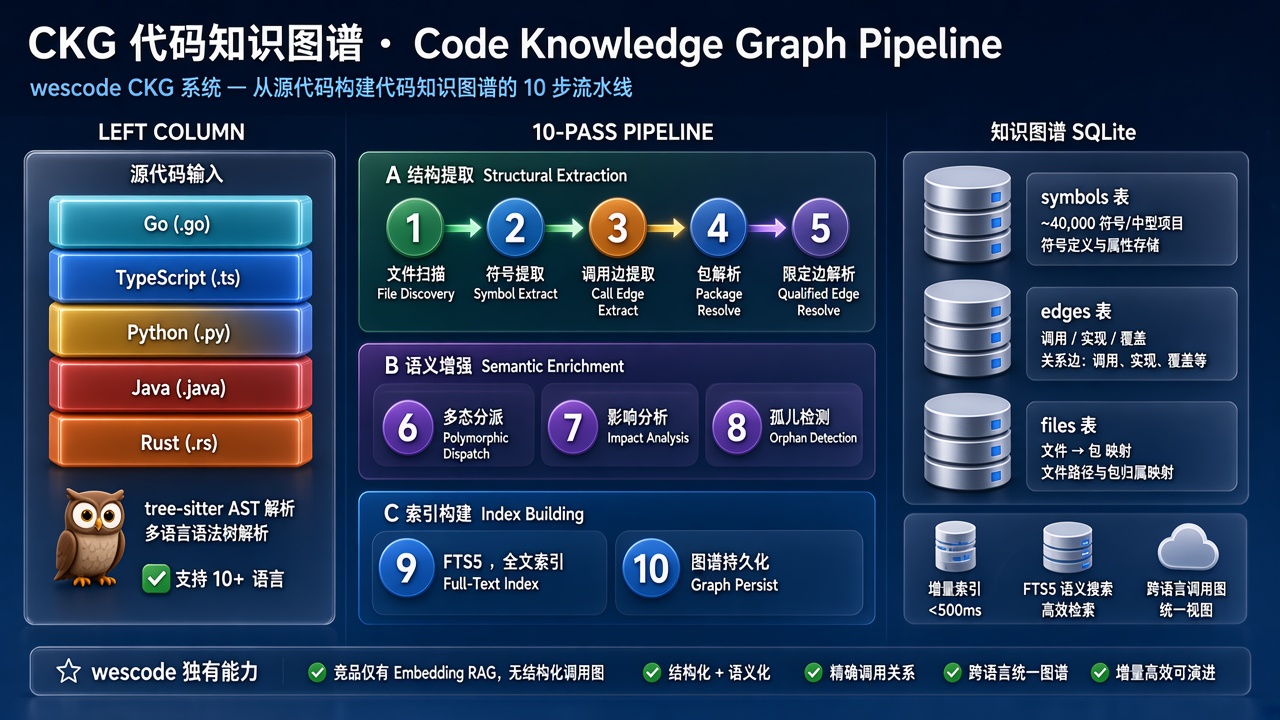
CKG 不是一种关系("谁调用了谁"),而是六种。当你问"改 calculateDiscount 会影响什么",CKG 同时在六个维度给你答案:
第一步:CALLS 关系——谁直接调用了它
OrderService.processOrder → calculateDiscount     ✅ 直接调用
BillingService.recalculate → calculateDiscount     ✅ 直接调用
RefundService.calculateRefund → calculateDiscount  ✅ 直接调用
... 共 5 个直接调用方
这一步 grep 也能做到。
第二步:IMPLEMENTS 关系——谁通过接口间接调用了它
DiscountStrategy (interface)
  ├── PremiumDiscount implements DiscountStrategy
  │   └── PremiumDiscount.calculate() 内部调用 calculateDiscount
  ├── SeasonalDiscount implements DiscountStrategy
  │   └── SeasonalDiscount.calculate() 内部调用 calculateDiscount
  └── BulkDiscount implements DiscountStrategy
      └── BulkDiscount.calculate() 内部调用 calculateDiscount
这些调用点在 grep 里搜 calculateDiscount 是搜不到的——因为调用方写的是 strategy.calculate(),不是 calculateDiscount。但 CKG 知道 DiscountStrategy 的每个实现类都会间接用到 calculateDiscount。
第三步:CO_CHANGES_WITH 关系——Git 历史里的隐藏耦合
改 calculateDiscount 时,历史上有 4 次同时改了:
  → invoice.ts (4/4 次)     ← 强耦合信号
  → tax-rules.ts (2/4 次)   ← 中等耦合
  → billing.test.ts (4/4 次) ← 测试需要同步更新
invoice.ts 和 calculateDiscount 每次都同时改——这说明它们之间有隐性依赖。回去看代码,发现 invoice.ts 的第 234 行确实依赖了 calculateDiscount 返回值的精度位数。这个依赖没有通过 import 关系体现——它隐藏在运行时行为里。
第四步:IMPORTS + TESTS + HANDLES 关系——补齐剩余维度
- IMPORTS:确认
billing/包 import 了order/包,改动可能波及 - TESTS:
calculateDiscount.test.ts直接测试 +orderFlow.e2e.ts间接覆盖 - HANDLES:
POST /api/orders→OrderController.create→calculateDiscount,改动后需要验证这个 API
最终结果:5 个直接调用 + 3 个接口间接调用 + 2 个事件回调 + 1 个强耦合文件 + 2 个测试文件 + 1 个 HTTP 端点。全部在 2 秒内返回。
你不用一个个 grep,不用翻 git log 去猜耦合关系,不用在脑子里拼接"接口 A 被类 B 实现,类 B 里调用了函数 C"——CKG 把这些关系预计算好了,你问一句就得到完整影响面。
L2.5 行为基线:改代码前拍快照,改完后自动对比
CKG 告诉你"改了这里会影响哪里",但没告诉你"改完之后行为有没有变"。L2.5 做的是这件事。
一个真实案例:你优化了 applyTaxRules 的实现,把一个 O(n²) 的循环改成了 O(n)。测试全绿。
但 L2.5 行为对比发现了一个问题:
改动前:applyTaxRules 返回的数组按 lineItem.id 升序排列
改动后:applyTaxRules 返回的数组按处理顺序排列(不保证有序)

⚠️ 行为变化:返回数组的排序方式改变了
为什么测试没报错?因为测试断言的是"总金额正确",没有断言"数组顺序一致"。但 invoice.ts 第 234 行用 zip 把这个数组和另一个数组配对——排序变了,zip 就错位了。
这就是"测试全绿但行为变了"的典型场景。 L2.5 把改动前后的可观测行为(函数签名、返回类型、排序特征)做对比,机械地列出差异。它不判断差异是好是坏——判断是你的事。但它让你看到差异,而不是"测试过了应该没问题"。
完整的"评估老代码风险"决策流程
把三层工具串起来,面对老代码你应该走的流程:
第一步:CKG 影响面分析
  问:改这个函数会影响多少文件、多少调用方?
  → 如果影响面 < 5 个文件:风险可控,继续
  → 如果影响面 > 20 个文件:考虑分步改,每次只改影响面的子集

第二步:CSE 约束检查
  问:这个函数有没有隐性约束(参数格式、返回类型、异常类型)?
  → 如果 CSE 报出约束:改动必须保持这些约束不变
  → 如果 CSE 无约束:不代表没有约束——可能是统计样本不足

第三步:改代码

第四步:L2.5 行为对比
  问:改完之后可观测行为有变化吗?
  → 如果无变化:高信心,提 PR
  → 如果有变化:评估变化是否预期
    → 预期的(你就是要改这个行为):记录在 PR 说明里
    → 非预期的(副作用):回退或修复

第五步:提 PR
  附上三层工具的检查结果
  → reviewer 看到:影响面精确、约束未违反、行为变化已列出
  → 审查效率从"翻 1500 行文件猜影响面"变成"确认工具结果是否符合预期"
你现在能做什么
不管用什么工具,面对老代码的几条实用原则:
1. 不要一次改太多。 即使 AI 可以一次改 8 处,让它一次只改一处。确认没问题再改下一处。慢是慢了,但比"8 处改完全炸了不知道是哪一处的锅"好。
2. 改之前先跑一遍完整测试,记住哪些过了。 改完再跑一遍,对比。测试结果变化的地方就是影响面。
3. "DO NOT MODIFY"要当真。 除非你能找到写那行注释的人(或他的继任者)问清楚原因。在代码库里,人的注释比 AI 的建议可信度高——因为注释的作者当时知道一些你不知道的事。
4. 如果你决定动了——改完立即提 PR,让知道这段代码历史的同事 review。 不要默默合进去。老代码最怕"改完没人知道"。
5. 建一个"改动日志"——不是 commit message,是一份给后来人看的文档:"我在 2026-10-14 改了 calculateDiscount,原因是 XXX,影响面是 YYY,验证了 ZZZ"。这就是你留给下一个面对这段代码的人的求救信号——就像 zhangwei 三年前留下的那行 DO NOT MODIFY。
这件事本质上不是技术问题,是信心问题。技术解决的是"怎么改",信心解决的是"敢不敢改"。
当你拥有完整的影响面(2 秒出结果,不是 30 分钟 grep)、自动的约束检查(机械判定,不是凭感觉)和改动前后的行为对比(工具验证,不是"测试过了应该没问题")——那个"DO NOT MODIFY"不再是一个禁令,而变成了一个可以评估的风险。风险可以评估,就可以决策。不可评估的风险才让人不敢动。