找个函数找了一下午
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
下午一点,你接到一个看起来很小的任务:给 processPayment 加一个参数。
你敲下那行再熟悉不过的命令:
grep -rn processPayment .
回车。47 matches。
你开始一条条看。
前面几条是注释。有人在 // TODO: 重构 processPayment 的错误处理 里提到了它——这条 TODO 的日期是 2023 年。
再往下是一段被注释掉的旧实现。整整六十行,没人删,也没人敢删。
然后是测试文件里的 mock:mockOrderSvc.processPayment(...) 出现了十几次,分散在四个测试文件里。它们都不是真正的调用,但你得确认它们不是。
再往下,一个叫 processPaymentLegacy 的函数——grep 不区分这个,它只是包含了那串字符。
下午两点半,你还在翻。

47 条 grep 结果到底是什么
让我帮你分类一下——这个分类表,你翻了一下午才整理出来的:
| 类别 | 数量 | 例子 | 是真正的调用方吗 |
|---|---|---|---|
| 函数定义 | 2 | function processPayment(...) + processPaymentLegacy(...) | 否 |
| 接口声明 | 1 | interface PaymentService { processPayment(...) } | 否 |
| 类型引用 | 2 | type PaymentFn = typeof processPayment | 否 |
| 直接调用 | 5 | orderSvc.processPayment(ctx, order) | 是 |
| 接口实现内部调用 | 2 | 在 StripeGateway.process() 内部调用 | 是,但 grep 搜不到外层 |
| 测试 mock | 14 | mockOrderSvc.processPayment.mockResolvedValue(...) | 否 |
| 注释里的提及 | 6 | // TODO: 重构 processPayment | 否 |
| 被注释掉的旧代码 | 4 | // const result = await processPayment(...) | 否 |
| 字符串常量 | 3 | log.info("processPayment started") | 否 |
| 导入语句 | 5 | import { processPayment } from './payment' | 否(导入不等于调用) |
| 命名相似项 | 3 | processPaymentLegacy、processPaymentV2、preProcessPayment | 否 |
| 总计 | 47 | 7 个真正的调用方 |
47 条结果,7 个真正的调用方。你花在排除 40 条噪声上的时间,比真正理解那 7 个调用方的时间长得多。
到三点,你确认了 5 个直接调用方。
然后你想起来——通过接口调用的那些呢?
interface OrderHandler {
  process(ctx: Context, order: Order): Promise<Result>
}
某个地方把 processPayment 赋给了这个接口。grep 搜 processPayment 搜不到那个调用点,因为那里写的是 handler.process(ctx, order)。
你开始搜 OrderHandler。又是一轮。
接口追踪地狱:实际看看那段代码
让你看看这个链条为什么这么难追:
// payment-gateway.ts —— 定义接口
interface PaymentGateway {
  charge(amount: number, currency: string): Promise<ChargeResult>
}

// stripe-gateway.ts —— 实现接口,内部调用 processPayment
class StripeGateway implements PaymentGateway {
  async charge(amount: number, currency: string): Promise<ChargeResult> {
    // 这里面调用了 processPayment,但外部看到的方法名是 charge
    const result = await this.processPayment({ amount, currency })
    return { success: result.ok, transactionId: result.txId }
  }

  private async processPayment(params: PaymentParams) {
    // ... 实现
  }
}

// checkout.ts —— 调用方,用的是接口名字
class CheckoutService {
  constructor(private gateway: PaymentGateway) {} // 注入的是接口

  async complete(order: Order) {
    // grep "processPayment" 永远搜不到这一行
    // 因为这里写的是 gateway.charge()
    const result = await this.gateway.charge(order.total, order.currency)
  }
}

// di-container.ts —— 接口和实现的绑定,距离调用方和实现各十万八千里
container.bind<PaymentGateway>('PaymentGateway').to(StripeGateway)
看到问题了吗?processPayment 在 StripeGateway 内部。外部调用走的是 PaymentGateway.charge()。从 processPayment 到 checkout.ts 的调用方,中间隔了接口声明、实现绑定、依赖注入三层——grep 搜这其中任何一个关键词,都不会告诉你它们之间的关系。
这就是为什么你花了 30 分钟搜 OrderHandler。而如果项目里有两层接口嵌套(接口 A 调接口 B,接口 B 的实现才调 processPayment),这个时间会翻倍。
下午四点。你终于确认了完整的影响范围:5 个直接调用方,2 个接口实现,1 个下游服务,还有一个藏在 YAML 配置里的定时任务引用——那个是你在快下班时偶然翻到的。
真正改代码用了多久?十二分钟。
"找路税":你的下午是这样度过的
不是写代码。不是设计。不是调试。
你在做一件每次改动前都必须做、每次都从头做一遍、做完不留下任何东西的事——理解代码之间的连接关系。
量化一下这笔税:
| 阶段 | 做什么 | 花了多久 | 有调用图要多久 |
|---|---|---|---|
| grep 搜索 | 搜 processPayment → 47 条结果 | 5 分钟 | 0(不需要) |
| 人工排除 | 去掉注释、mock、旧代码、命名相似项 | 45 分钟 | 0 |
| 接口追踪 | 搜 OrderHandler 接口的实现者和调用方 | 30 分钟 | 包含在 2 秒结果内 |
| 配置检查 | 翻 cron.yaml、路由配置 | 15 分钟 | grep 兜底 5 分钟 |
| 改代码 | 实际修改 | 12 分钟 | 12 分钟 |
| 总计 | 107 分钟 | 19 分钟 |
更难受的是,你上周才刚为另一个函数做过一模一样的事。上上周也做过。这些付出没有积累,下次还得再来一遍。
还有一个隐藏成本:上下文切换。你在排除第 23 条 grep 结果时接了个电话,回来已经不记得看到哪了。你不得不从第 15 条重新开始确认——因为中间那几条你不确定到底排除了没有。这种"排除式搜索"特别脆弱,任何打断都意味着重来一段。
算一笔年账
假设你平均每天花 30 分钟在"理解代码连接关系"上(有些天不需要,有些天要花一整个下午):
| 时间维度 | 花在"找路"上的时间 | 占工作时间比例 |
|---|---|---|
| 每天 | 30 分钟 | 6.25% |
| 每周 | 2.5 小时 | 6.25% |
| 每月 | 10 小时 | 6.25% |
| 每年 | ~120 小时 ≈ 15 个工作日 | 三周 |
你每年花三周时间在"搞清楚谁在调用谁"上。 不是写代码,不是设计系统,不是修 bug——纯粹在做代码考古。
如果你是一个 10 人团队,这笔税是 150 个工作日/年——接近一个人一年的全部工作量。而且这还没算"查完之后发现漏了一个调用方,线上出了 bug"的修复成本。
grep 到底差在哪
grep 做的事是"在文本里找字符串"。它很快,很可靠,而且永远不会骗你。
但它回答的和你想问的是两件事:
- 你想问:"谁在调用这个函数"
- grep 听到:"哪些行包含这串字符"
这个差距在简单项目里可以靠经验弥补。但在有接口抽象、依赖注入、跨文件调用的项目里,它是系统性的:
| grep 找不到的 | grep 多给你的 |
|---|---|
| 通过接口间接调用的地方 | 注释里的提及 |
| 通过高阶函数传递的引用 | 字符串常量里的文本 |
| 跨包的类型实现关系 | 已废弃的旧代码 |
| 子类覆写的方法 | 测试文件里的 mock |
| 动态派发的调用点 | 名字相似但无关的符号 |
少的那些让你漏改,多的那些让你加班。
Embedding 向量检索呢?比 grep 好吗
很多 AI 编程工具用 Embedding(向量化)做代码检索:把代码块转成向量,然后用"语义相似度"搜索。听起来比 grep 的"字符串匹配"高级多了。
实际表现怎么样?用 processPayment 做个测试:
查询: "processPayment 的调用方"

Embedding 返回的 Top 5:
1. processPayment 的定义(相似度 0.95)—— 不是调用方,是定义本身
2. processRefund 函数(相似度 0.87)—— 名字像,但完全不相关
3. PaymentProcessor 类(相似度 0.85)—— 包含 "Payment" 所以像,但不是调用方
4. processPaymentLegacy(相似度 0.82)—— 名字像,旧版实现
5. handlePaymentWebhook(相似度 0.78)—— 碰巧是一个真正的调用方
5 条结果里命中了 1 个真正的调用方(20%),还有 4 个是"语义相似但不是你要找的"。
Embedding 的问题在于:它理解语义相似性,但不理解结构关系。"processRefund"和"processPayment"在语义上确实相关(都是处理支付相关的操作),但"processRefund 是不是 processPayment 的调用方"——这个问题 Embedding 回答不了。
这也不能怪 Embedding。它设计出来就不是回答"谁调用谁"的。用它来搜"这段代码大概在讲什么"很好(比如搜"处理支付失败的逻辑"),但用它来找精确的调用关系,就像用锤子拧螺丝——能拧,但不是最合适的工具。
Embedding 真正擅长的场景是模糊回忆:"我记得项目里有个处理支付超时的重试逻辑,但忘了叫什么名字。" 这时候语义检索能帮你从"支付超时重试"找到 retryPaymentWithBackoff——grep 搜不到,因为你压根不知道该搜什么关键词。
三种搜索方式对比
| 能力 | grep(文本匹配) | Embedding(语义检索) | CKG 调用图(结构查询) |
|---|---|---|---|
| 直接调用 | ✅ 能找到 | ⚠️ 可能找到 | ✅ 精确 |
| 接口实现 | 不支持 | 不支持 | 支持(IMPLEMENTS 边) |
| 子类覆写 | 不支持 | 不支持 | 支持(OVERRIDES 边) |
| 跨包依赖 | ✅ import 语句 | ⚠️ 语义相似 | ✅ IMPORTS 边 |
| 历史耦合 | 不支持 | 不支持 | 支持(CO_CHANGES_WITH 边) |
| 排除噪声 | 不支持,注释/mock/字符串全包含 | ⚠️ 语义相似的无关项 | 支持,只返回真实结构关系 |
| 速度 | 快(< 1 秒) | 中(1-3 秒) | 快(< 2 秒,预计算) |
| 增量更新 | 不需要 | 需要重新向量化 | 保存文件即更新(< 500ms) |
| 不需要编译 | ✅ | ✅ | ✅(tree-sitter 解析) |
| 配置文件引用 | ✅ 文本在就能搜到 | ⚠️ 取决于是否向量化了 | 不支持,代码语法之外的不在图里 |
| 模糊回忆 | 不支持,不知道搜什么词 | ✅ 语义匹配 | 不支持,需要知道符号名 |
关键观察:三种方式各有擅长的场景,不是谁替代谁。 CKG 解决"谁在调用谁"的精确查询,grep 兜底"配置文件里的字符串引用",Embedding 解决"我知道有这么个东西但忘了叫什么"。
调用图的工作原理:不是搜字符串,是解析语法树
你真正需要的不是文本搜索,而是调用图——工具先通过语法解析"理解"代码的结构,建好"谁调用谁、谁实现谁"的关系网络,然后你问"processPayment 被谁调用",它直接给你精确的列表。
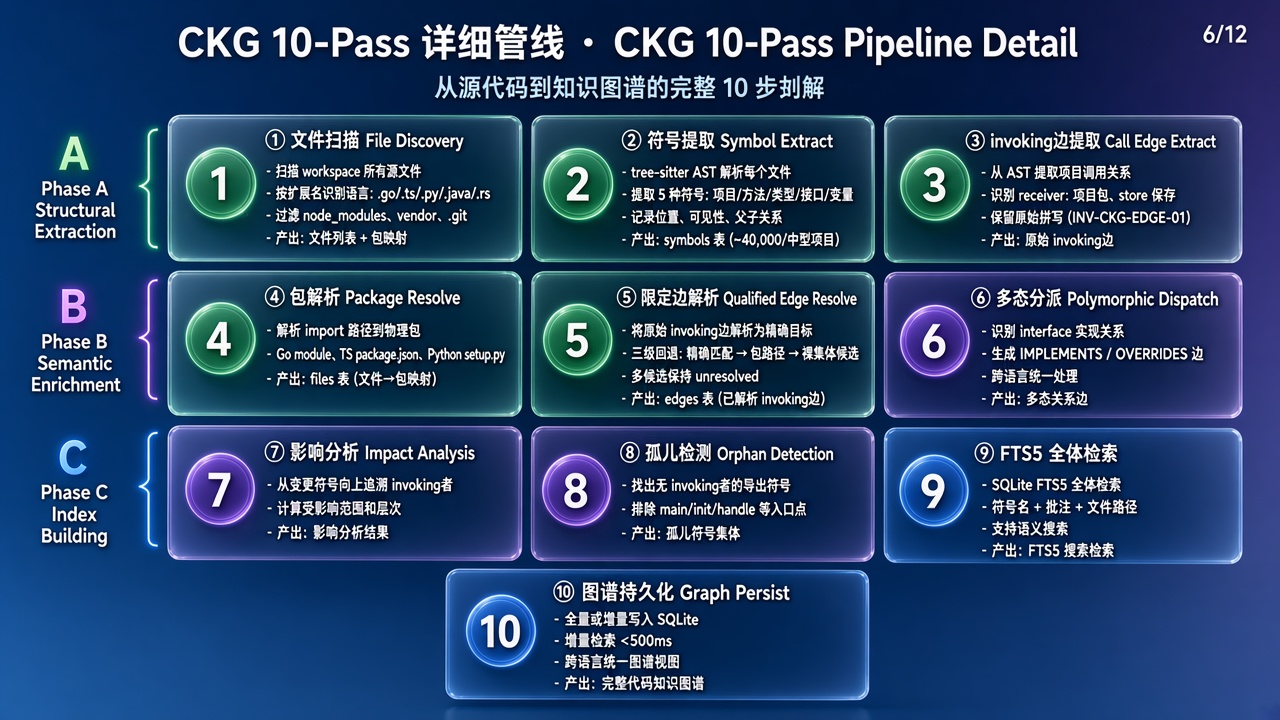
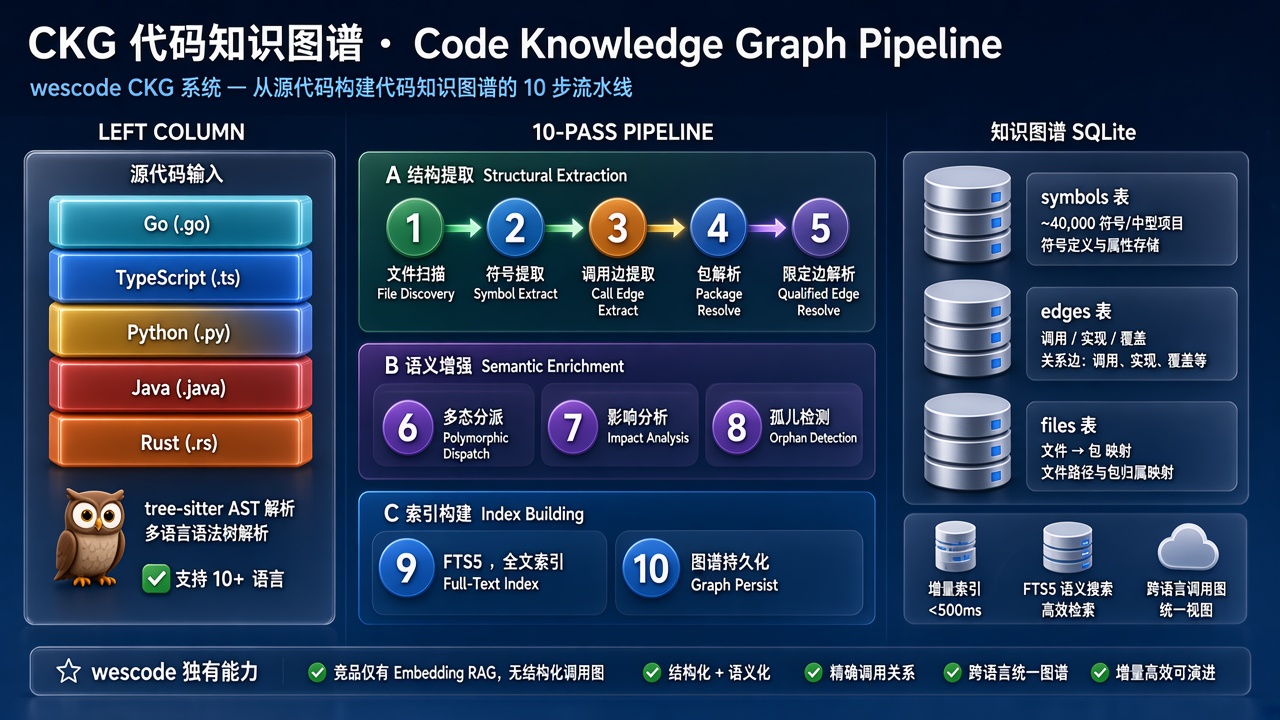
wescode 的 CKG(Code Knowledge Graph,代码知识图谱)就是干这件事的。它的索引过程不是一次简单的扫描,而是一个多 Pass 深度管线,分阶段提取越来越高层的关系:
CKG 10-Pass 索引管线
| 阶段 | 做什么 | 产出 | 为什么 grep 做不到 |
|---|---|---|---|
| Pass 1-2:文件扫描 + 符号提取 | 用 tree-sitter 逐文件解析 AST,提取函数、类、接口、类型的定义 | 全局符号表:哪个文件定义了哪些符号 | grep 不知道 processPayment 是函数定义还是注释里的字符串 |
| Pass 3-4:调用关系解析 | 分析每个函数体内的调用表达式,解析 a.b() 中 a 的类型、b 的定义源 | CALLS 边:A 调用 B | grep 能找到直接调用,但搞不清 handler.process() 里的 handler 是哪个实例 |
| Pass 5-6:接口实现关系 | 分析类型声明,解析哪个 struct/class 实现了哪个 interface | IMPLEMENTS 边:A 实现接口 B | 这是 grep 根本做不到的——接口实现没有调用点,只有类型声明 |
| Pass 7-8:导入依赖 + 跨文件引用 | 解析 import/require 语句,建立包级别的依赖关系 | IMPORTS 边:模块 A 依赖模块 B | grep 能搜到 import 语句,但不知道谁用了被 import 的符号 |
| Pass 9-10:覆写关系 + 关系优化 | 识别子类方法覆写、消除重复边、消歧同名符号 | OVERRIDES 边 + 精简后的完整关系图 | grep 无法区分同名方法属于父类还是子类 |
索引速度:10 万行项目 5-15 秒建完,文件保存后增量更新几百毫秒(内部测试数据)。一次建索引,以后每次找调用方都是 2 秒钟的事。
回到 processPayment:CKG 怎么追踪那条接口链
还记得你花 30 分钟追踪的那条链吗?CKG 是这样处理的:
- Pass 1-2 扫到
StripeGateway类里有processPayment方法,记录定义位置 - Pass 5-6 发现
StripeGateway实现了PaymentGateway接口,建立 IMPLEMENTS 边 - Pass 3-4 发现
CheckoutService.complete()调用了this.gateway.charge(),追踪到gateway的类型是PaymentGateway - 合并:
CheckoutService → PaymentGateway.charge() → StripeGateway.charge() → processPayment()
整条链在索引阶段就已经建好了。 你查"谁调用 processPayment"时,引擎做的只是从图里查一跳——连数据库查询都算不上。
CKG 维护的六种关系
| 关系 | 含义 | 例子 | grep 能找到吗 |
|---|---|---|---|
| CALLS | A 调用 B | checkout() 调用 processPayment() | ✅ 直接调用可以 |
| IMPLEMENTS | A 实现接口 B | StripeGateway 实现 PaymentGateway | 找不到 |
| EMBEDS/EXTENDS | A 继承/嵌入 B | PremiumOrder 继承 Order | ✅ 声明层面 |
| IMPORTS | 包 A 依赖包 B | order/ 导入 payment/ | ✅ |
| DEFINES | 文件 A 定义符号 B | gateway.ts 定义 processPayment | ✅ |
| OVERRIDES | A 覆写父类方法 B | StripeGateway.process() 覆写基类方法 | 找不到 |
关键观察:grep 在 IMPLEMENTS 和 OVERRIDES 两个关系上完全失效——而这恰好是接口抽象和继承层次深的项目里最频繁的关系类型。你的"找了一下午"里,花在追踪 OrderHandler 接口的那 30 分钟,就是 IMPLEMENTS 关系的缺失造成的。
回到那个下午
你在编辑器里右键点 processPayment,选"查看调用方"——2 秒钟看到完整的调用方清单:
- 直接调用的 5 个地方(精确匹配)
- 通过
OrderHandler接口间接调用的 2 个地方(精确匹配,grep 找不到) - 注释里提到的(不在列表里——它不是调用方)
- 测试 mock(不在列表里——它不是生产调用)
processPaymentLegacy(不在列表里——它是另一个函数)
47 条 grep 结果 → 7 条精确的调用方。没有噪音。
那个 YAML 配置里的引用呢?调用图覆盖不了配置文件的字符串引用——CKG 的能力边界在代码语法能解析的范围内。配置文件、注释里的约定、运行时动态生成的调用,这些不在图里。但 7 个调用方精确命中已经比"47 条自己筛"好了不止 10 倍。剩下的配置文件引用,grep 兜底——这也是为什么 wescode 同时保留了完整的 grep 能力(search_files 工具),两者不是替代关系,是互补。
你可能在想
"我们项目才几万行,还好。"
项目大小不是关键。层级深度才是。 一个三万行但接口套接口、依赖注入满天飞的项目,找路成本可能比十万行的扁平脚本高得多。
判断标准很简单:你能不能在脑子里装下一个函数的全部调用方?
装不下,你就在交这个税。
"我用 IDE 的 Find References 就够了。"
LSP 的 Find All References 比 grep 准——在同一编译单元内。但它有两个限制:一是跨语言、跨项目的引用它不追踪(TypeScript 调 Python、前端调后端 API),二是它需要编译上下文——项目有编译错误时 LSP 可能罢工。CKG 基于 tree-sitter 做 AST 解析,不需要编译,允许语法不完整。
"我靠的是对项目的熟悉度。"
熟悉度确实有用,直到你换一个项目、接手别人的代码、或者休完假回来发现同事重构了三个模块。人脑里的调用图没有版本控制,不会自动更新,也没办法分享给新来的同事。 最痛苦的场景就是新人入职后问"这个函数谁在用",你说"我记得是那几个地方",结果漏了一个——因为上个月有人加了一个新的调用方而你不知道。
你能做什么
- Find References 先跑一遍——LSP 的 Find All References 比 grep 准(在同一编译单元内)。但跨文件、跨语言、配置文件里的引用它也找不到
- grep + Find References 结合——grep 找字面引用,Find References 找类型引用,两者取并集。这是目前大多数人的最佳实践
- 如果你经常做这件事——试试有调用图的工具。wescode 的 CKG 在你打开项目时自动建索引,不需要配置、不需要编译,后台 5-15 秒完成;之后文件保存自动增量更新。每次找调用方都是右键 2 秒钟的事——不用再从头 grep
那个下午不是你效率低。是工具只能回答"哪里有这串字符",而你需要知道的是"谁在调用它"。