每开一个新对话,都要重新解释一遍项目
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
"我们是一个 React + Express + Prisma + PostgreSQL 的全栈项目,后端分 controllers → services → repositories 三层,接口统一返回 { data, total, page } 分页格式,错误统一用 { code, message } 结构,测试用 Vitest 不用 Jest,测试文件放在同级目录的 *.test.ts,React 组件 PascalCase、hooks 以 use 开头……"
你是不是每天都在打这段话?
你在"重新解释项目"时,到底在重复什么
我记过一天的"项目介绍"流水账。一个中型全栈项目,每次新对话至少要说清楚这些内容:
| 类别 | 你要说的内容 | 典型复杂度 |
|---|---|---|
| 技术栈 | React 18 + Express 4 + Prisma 5 + PostgreSQL 15 + Redis 7 | 框架版本决定 API 写法,说错版本 AI 就给你写废弃 API |
| 文件组织 | src/controllers/ → src/services/ → src/repositories/,中间件在 src/middlewares/,工具函数在 src/utils/,类型定义在 src/types/ | 说漏一层 AI 就把逻辑放错位置 |
| 接口规范 | 分页返回 { data, total, page, pageSize };错误返回 { code, message };列表接口支持 ?sort=createdAt&order=desc | AI 默认各种格式,你的格式只有说了才知道 |
| 测试约定 | *.test.ts 放在被测文件同级目录;用 Vitest 不用 Jest;mock 用 vi.mock() 不用 jest.mock() | 不说就给你生成 Jest 语法的测试 |
| 命名约定 | React 组件 PascalCase、hooks 以 use 开头、服务层方法 camelCase、数据库表名 snake_case、枚举全大写 | 不说就混用风格 |
| 架构决策 | 鉴权用 JWT + refresh token、文件上传走 S3 presigned URL、任务队列用 BullMQ | 每条都影响代码生成方向 |
一次完整介绍的 token 开销:800-1500 token,打字时间 1-2 分钟。
一天新开 5 次对话:4000-7500 token 花在重复自我介绍上,5-10 分钟纯粹浪费。
一年累积:假设工作日 250 天,21-42 小时——整整 3-5 个工作日花在告诉 AI "你已经知道但又忘了"的事情上。
真正的代价不是打字时间——是你"记不全"
上面的表格列了 6 个类别约 30 条信息。但一个 5 万行 TypeScript 项目实际有多少可识别的编码惯例?
我做过一次认真的统计:
| 类别 | 惯例数量 | 举例 |
|---|---|---|
| 命名约定 | 15-25 条 | 组件文件名与导出名一致、API 路由用 kebab-case、环境变量全大写加 APP_ 前缀 |
| 文件组织 | 10-15 条 | 每个 feature 一个目录、index.ts 只做 re-export、常量放 constants.ts 不放 config.ts |
| 错误处理 | 8-12 条 | 用 AppError 不用原生 Error、HTTP 4xx 由 controller 处理、service 层抛业务异常不抛 HTTP 异常 |
| 数据访问 | 10-15 条 | repository 只返回 domain 类型不返回 Prisma 类型、事务用 prisma.$transaction、软删除用 deletedAt |
| 接口设计 | 10-15 条 | 所有接口统一 response envelope、分页参数名固定、ID 参数用 path 不用 query |
| 测试风格 | 8-12 条 | describe 按方法名分组、每个 test 独立 setup、不共享可变状态 |
| 前端模式 | 15-20 条 | 状态管理用 zustand 不用 redux、表单用 react-hook-form、路由参数用 zod 校验 |
合计:一个中型项目的编码惯例在 80-120 条左右(内部测试数据)。
而 .cursorrules 或 CLAUDE.md 里通常写了多少?
10-20 条。
剩下的 80% 存在于"团队每个人都知道但没人写下来"的状态。你写不全——不是因为你懒,是因为这些惯例太隐含了,你自己都意识不到它们的存在,直到 AI 违反了其中一条时你才反应过来:"等等,这里应该用 AppError 不是 throw new Error"。
那些"你说不出来的隐性规矩"
来看几个真实例子——这些都是从实际项目中观察到的惯例,但几乎没有人会主动写进规则文件:
1. 导入顺序:先 node 内置模块,再第三方库,再内部模块,组间空一行。你从来没写下来过这条规则,但如果 AI 把 import fs from 'fs' 放到 import { UserService } from '../services' 下面,你一眼就觉得"不对"。
2. 错误消息格式:你的 service 层所有错误消息都是 英文大写常量_下划线分隔(如 ORDER_NOT_FOUND),但 controller 层面向用户的消息是中文。AI 生成 service 层代码时写了 throw new AppError('订单未找到')——功能上没问题,但破坏了你整个项目的错误处理模式。
3. 测试数据工厂:你的测试从来不手写 { id: '1', name: 'test', email: 'test@test.com' },而是统一用 createTestUser() 工厂函数。AI 不知道你有这个函数,直接内联写了一堆测试数据——跑得通,但和项目其他 200 个测试文件风格完全不同。
4. 数据库查询封装层级:你的 repository 层只做单表查询,跨表关联逻辑放在 service 层用多次查询 + 内存 join。AI 在 repository 里写了一个 3 表 join 的复杂 SQL——性能可能更好,但违反了你团队的分层约定。
5. 异步错误边界:每个 async controller 方法都包在 asyncHandler() 里(一个高阶函数),从来不在 controller 里手写 try/catch。AI 每次都给你加 try/catch——不是错,但不是你项目的做法。
这些"规矩"全在你脑子里。你遵守它们是因为习惯,不是因为读过哪份文档。你写不进规则文件,因为你甚至不知道它们是"规则"——它们只是"这个项目一直这么做的"。
规则文件:有用,但不够
.cursorrules(Cursor)、CLAUDE.md(Claude Code)、.github/copilot-instructions.md(Copilot)——这些文件每次新对话自动加载。
它解决了"每次手打"的问题。但它有三个结构性局限:
1. 你写不全。 上面说了,80% 的惯例你意识不到。你能写进规则文件的只有你"主动想得到"的那部分。
2. 没人更新。 项目在变——上个月用 REST,这个月迁到了 tRPC。规则文件还写着"接口统一返回 { data, total, page }"——这条规则现在是错的。谁负责更新?没有人。规则文件的半衰期大约是 2-3 个月——写好的那天是最准确的,之后每天都在过期。
3. 对话里的新信息留不住。 你在对话中告诉 AI:"这个接口的分页用 cursor-based 不用 offset-based"——这条信息在这次对话里有效,对话结束后消失。除非你手动复制到规则文件,否则下次还得重说。
规则文件是你的人工记忆外挂——你写了什么它就知道什么,你没写的它永远不知道,你写错了它就按错的来。维护它的人始终是你。
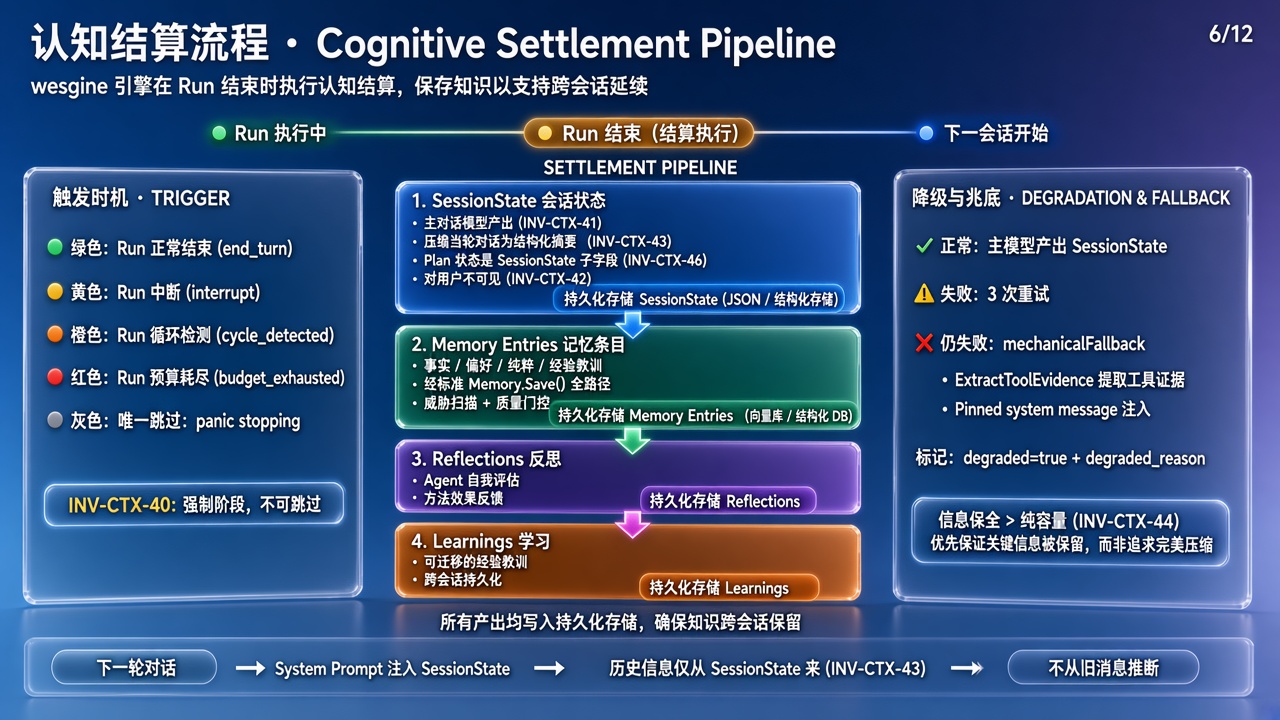
wescode 的做法:三层覆盖,不再依赖你记全
wescode 用三层递进机制解决"项目上下文"问题,每层覆盖前一层的盲区:
第一层:规则文件(你主动写的)
和其他工具一样,wescode 支持规则文件。这一层覆盖的是你明确知道且愿意写下来的约定。
第二层:认知结算(你说过但没写进文件的)
每次对话结束时,wescode 的主模型自动回顾这次对话里的关键信息,提炼成结构化记忆存入长期存储。

这个过程的技术细节:
| 步骤 | 做什么 | 结果 |
|---|---|---|
| 对话结束触发 | 主对话模型(不是辅助模型)回顾整段对话 | 保证提炼质量等于对话质量 |
| 信息分类提取 | 识别技术栈、文件组织、接口规范、架构决策、编码偏好等类型 | 结构化存储,不是一段摘要文本 |
| 去重与冲突处理 | 新信息与已有记忆对比——相同的跳过、矛盾的标记旧条目被取代 | "上个月用 REST"被"这个月迁到 tRPC"自动取代 |
| 按项目隔离存储 | 记忆物理归属于当前工作区(项目) | A 项目用 Express、B 项目用 Fastify,互不干扰 |
| 下次对话自动注入 | 新对话开始时,相关记忆加载到系统提示词 | 你不需要重新解释,AI 已经知道了 |
具体例子——随着使用累积,记忆层逐渐丰富:
第 1 次对话:你介绍了技术栈
  → 认知结算提炼:"项目使用 React 18 + Express 4 + Prisma 5 + PostgreSQL 15"

第 3 次对话:你纠正了一个文件放错了位置
  → 提炼:"迁移脚本放 prisma/migrations/ 不放 db/migrations/"

第 5 次对话:你做了一个架构决策
  → 提炼:"已从 REST 迁移到 tRPC,所有新接口用 tRPC router 定义"

第 8 次对话:你否决了一个库
  → 提炼:"日期处理用 dayjs 不用 moment.js,moment.js 已在 package.json 中移除"
到第 10 次对话开始时,AI 已经积累了 15-30 条关于你项目的记忆——全部是你在正常工作中顺口说过的,不需要你停下来专门写文档。
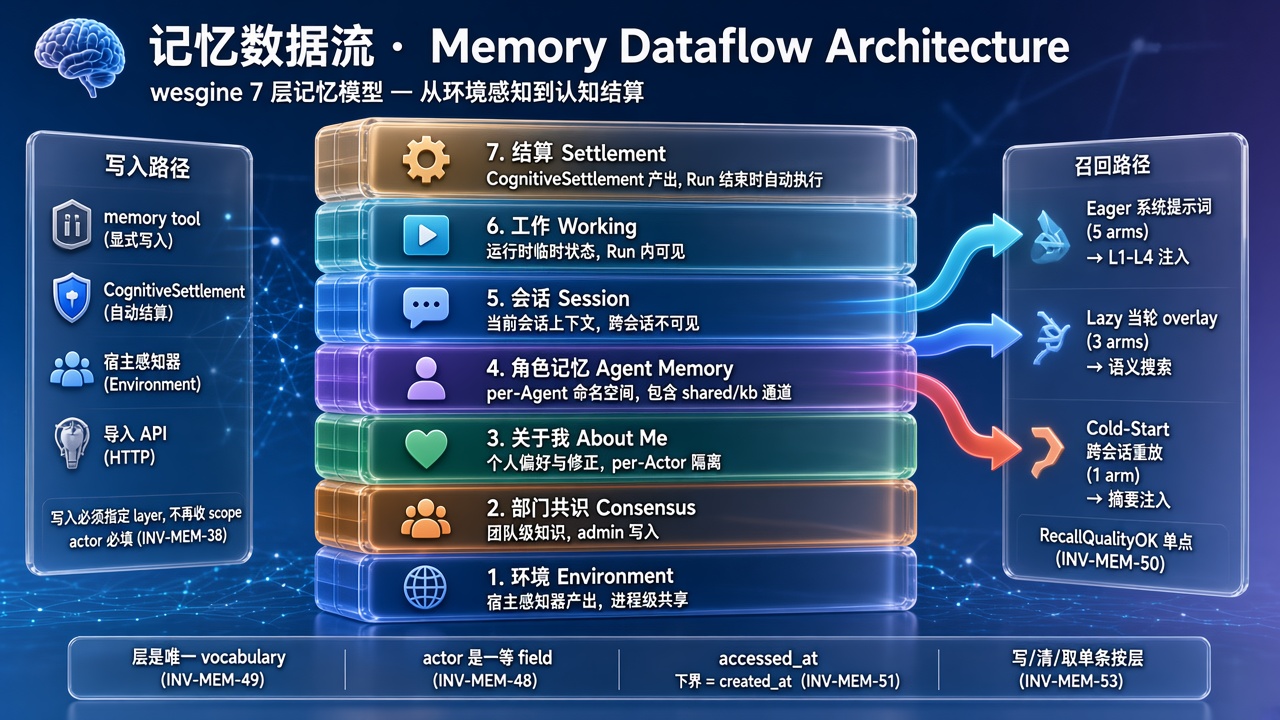
记忆积累时间线:从陌生到熟悉
这个过程不是一步到位的。以一个典型的全栈项目为例:
第 1 天(2-3 次对话):AI 知道技术栈、文件结构、你提到的 1-2 个偏好。大致相当于一个"看了 README 的实习生"——知道用什么框架,但不知道项目怎么组织代码。
第 1 周(10-15 次对话):AI 积累了 15-30 条记忆——技术栈、文件组织、接口规范、3-5 个你纠正过的编码偏好、1-2 个架构决策。相当于"入职一周的新同事"——基本对话不需要你重复背景,但遇到没见过的模块还是会问。
第 1 个月(40-60 次对话):AI 积累了 50-80 条记忆,覆盖了大部分常见场景的惯例。加上 CSE 扫描的统计惯例,总覆盖率达到 80%+。相当于"干了一个月的同事"——绝大多数编码风格对了,偶尔遇到边角场景还是需要你指点。
之后:记忆继续缓慢积累,但增量递减——因为常见的惯例已经覆盖了,新增的主要是新模块、新架构决策、偶尔的偏好更新。
第三层:CSE 自动扫描(你没说过但一直在遵守的)
这是 wescode 独有的一层——**约束满足引擎(CSE)**自动扫描项目代码,推导出你的编码惯例。
CSE 不需要你说"组件文件名用 PascalCase"——它扫描 src/components/ 下的 200 个文件,发现 198 个是 PascalCase、2 个是 camelCase,于是推导出"这个项目的惯例是 PascalCase"。
CSE 的具体推导过程:以"组件命名惯例"为例——
1. 扫描 src/components/ 下所有 .tsx 文件
   → 找到 200 个文件

2. 提取每个文件的导出名
   → UserProfile, OrderList, PaymentForm, ...

3. 统计命名模式分布
   → PascalCase: 198 个 (99%)
   → camelCase: 2 个 (1%)

4. 置信度评估
   → 样本量 200 > 阈值 5 ✓
   → 多数派占比 99% > 阈值 80% ✓
   → 推导结论:"组件文件名使用 PascalCase"(高置信度)

5. 那 2 个 camelCase 文件?
   → 标记为"偏离项目惯例"
   → 不修改、不报错,只在 AI 生成新代码时遵守多数派
CSE 不止看文件名。它会从多个维度扫描代码模式:
- 缩进风格:统计所有文件的缩进字符(Tab vs 空格)和宽度
- 引号风格:单引号还是双引号,项目的多数派是什么
- 分号使用:加分号还是不加分号
- 导入排序:是否有固定的导入分组顺序
- 错误处理模式:service 层用什么类型的错误、controller 层怎么处理
- 函数长度:项目的函数平均多少行,超长函数的阈值大概在哪
每个推导都需要足够的样本量。如果一个目录只有 3 个文件,CSE 不会做强断言——它会标注"样本不足,置信度低"。
这意味着那 80% 你自己都意识不到的惯例,CSE 能通过统计分析发现。你不需要写进规则文件,也不需要在对话里提到——它直接从代码中学习。
三层的覆盖关系:
| 层 | 覆盖什么 | 信息来源 | 更新方式 |
|---|---|---|---|
| 规则文件 | 你主动写的约定 | 你的文档 | 你手动更新 |
| 认知结算 | 你说过的项目信息 | 对话提炼 | 每次对话自动积累 |
| CSE 扫描 | 你没说过但代码里体现的惯例 | 项目代码统计 | 随代码变化自动更新 |
三层叠加的覆盖率推算(内部测试数据):规则文件覆盖你能写出的 10-20 条显式约定(约 15-20%);认知结算在 1-2 周内覆盖你在对话中提到过的 30-50 条信息(累积到 30-50%);CSE 扫描覆盖代码中统计可见的 60-80 条惯例(叠加到 80%+)。这三层之间有重叠——你写进规则文件的内容 CSE 也能扫到——但重叠不是浪费,而是交叉验证。
和规则文件的完整对比
| 维度 | 规则文件(各工具通用) | wescode 三层机制 |
|---|---|---|
| 信息来源 | 你提前手写 | 你写的 + 你说过的 + 代码里的 |
| 覆盖面 | 你能想到并愿意写的(~20%,内部测试数据) | 三层叠加(~80%+,内部测试数据) |
| 维护方式 | 你手动更新 | 认知结算自动积累、CSE 自动扫描 |
| 处理矛盾 | 你自己发现并修改 | 新记忆自动标记旧记忆被取代 |
| 按项目隔离 | 取决于你把文件放哪 | 自动按工作区物理隔离 |
| 处理新信息 | 你得手动补充到文件 | 对话中自动捕获 |
| 处理隐含惯例 | 写不出来 | CSE 从代码统计推导 |
| 代价/局限 | 维护成本低但覆盖面有限 | 认知结算偶尔误记一次性指令;CSE 在小样本目录下置信度低;记忆积累需要 1-2 周使用才趋于稳定 |
各工具对比
| 工具 | 新对话是否从零开始 | 怎么缓解 | 能力边界 |
|---|---|---|---|
| Cursor | 是 | .cursorrules + @Past Chats 手动引用 | 规则文件覆盖你写的;引用过去对话需要手动选择 |
| Claude Code | 是 | CLAUDE.md + 自动总结到 CLAUDE.md | 总结内容追加到文件,但需要你确认和清理 |
| Copilot | 是 | .github/copilot-instructions.md | 纯规则文件,无自动学习 |
| wescode | 否 | 规则文件 + 认知结算 + CSE 扫描 | 三层覆盖;记忆可能不完美但持续积累 |
| 通义灵码 | 是 | 有限的代码风格学习 | 不跨对话保持 |
| Trae | 是 | 无 | 每次从零开始 |
它不完美——但比每次从零开始好太多
认知结算有时候会记住不该记的(一次性的调试上下文),有时候会漏掉该记的(你提了一嘴但没展开的偏好)。CSE 的统计推导在样本量小时可能不准(只有 3 个文件的目录,惯例推导置信度低)。
记忆的能力边界
什么时候记忆不准:
- 一次性上下文被记住了——你在调试时说"这里先写个
console.log看看",认知结算把"用 console.log 调试"当成了项目偏好。下次生成的代码里就带着调试日志 - 你改了主意但没说——第一周你说"用 REST",第三周默默开始用 tRPC 但没在对话里提过。记忆还停留在"用 REST"
- CSE 遇到风格分裂的项目——前端用单引号、后端用双引号,CSE 按全局统计可能给出一个"折中"结论
怎么修正错误记忆:在对话里直接告诉 AI "我们不再用 REST 了,现在用 tRPC"——认知结算会自动用新信息取代旧信息。不需要找配置文件、不需要删记忆条目,直接说就行,就像纠正一个同事。
但相比每次从零开始重新解释项目——一个有 80% 准确率的自动记忆系统,仍然好过 0% 记忆的白板。
就像一个同事:他知道你项目的基本架构和惯例,偶尔记错细节。你是希望他每天都像第一天入职一样什么都不知道——还是接受他偶尔记错但大方向对?
你现在能做什么
不管用什么工具:
-
至少维护一份规则文件——把最关键的 10-15 条约定写进去(技术栈、文件组织、接口规范、命名约定、测试约定)。比没有好 10 倍
-
每次对话开头粘贴项目介绍——如果你反复在说同样的内容,存一份在笔记里。不优雅,但管用
-
当你第三次告诉 AI 同一件事时,把它写进规则文件——这就是你的信号:这条信息值得固化
-
试试不从零开始的工具——如果"每次重新解释项目"是你最大的痛点,自动学习和长期记忆可能是最直接的解决方案