AI 写得越快,我 review 得越慢
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
AI 用 30 秒改了 8 个文件。你用 40 分钟 review 这 8 个文件。
这笔账怎么看怎么不对。

AI 加速了生产,没加速审查
代码从"写"到"上线"中间有一道关卡——code review。
AI 编程工具把"写"的速度提高了 5-10 倍。但 review 的速度呢?一点都没变。
你的同事看 AI 改的 8 个文件,他需要做的事和看人改的 8 个文件完全一样:理解每个改动的意图、检查类型兼容、确认影响面、验证不会破坏现有逻辑。
事实上 AI 的 diff 比人的 diff 更难 review:
- 人类改代码有明确的意图——你知道他想干什么,只需要检查他做对了没有
- AI 的改动有时会夹带"顺手优化"——重排 import、统一命名风格、删掉它认为多余的注释。这些混在真正的功能改动里,reviewer 得一条条分辨
"顺手优化"有多难分辨
来看一个真实的 diff。AI 被要求"给 OrderService.create 加入库存检查"。PR 的 diff 里,你看到了这些变化:
// 文件:services/order.ts
// AI 的 diff(简化版)

- import { OrderRepository } from '../repositories/order'
- import { validateInput } from '../utils/validation'
- import { AppError } from '../errors'
- import { logger } from '../utils/logger'
+ import { AppError } from '../errors'
+ import { logger } from '../utils/logger'
+ import { OrderRepository } from '../repositories/order'
+ import { InventoryService } from '../services/inventory'   // ← 新功能
+ import { validateInput } from '../utils/validation'

  export class OrderService {
-   async create(data: CreateOrderDTO) {
+   async create(orderData: CreateOrderDTO) {                 // ← 重命名参数
+     // 库存检查
+     const available = await this.inventoryService.check(     // ← 新功能
+       orderData.productId,
+       orderData.quantity
+     )
+     if (!available) {
+       throw new AppError('INSUFFICIENT_INVENTORY')           // ← 新功能
+     }
      // ...
这段 diff 里混了三件事:
- import 重排——按字母顺序排列了(无功能影响,但在 diff 里每行都有变化)
- 参数重命名——
data→orderData(无功能影响,但 AI 觉得"更有语义") - 库存检查——这才是你要求的功能
reviewer 看到 15 行 diff,其中只有 5 行是真正的功能改动。但他必须逐行确认哪些是格式调整、哪些是功能变化——因为如果"重排 import"的过程中漏了一行引入、或者"重命名参数"在某个调用方没改全,那就是 bug。
reviewer 在做的三件事——以及每件事消耗多少时间
reviewer 看一个 PR 时,本质上在回答三个问题。我拿一个真实场景拆解:AI 重构订单模块,改了 12 个文件、diff 400 行。
问题一:"这次改动影响了谁?"
同事 A 看 diff,发现 OrderService.create() 的错误处理从返回 null 变成了抛异常。这是一个契约变更——所有调用方都受影响。
他要做什么:
1. 在 IDE 里搜 "OrderService.create"        → 找到 3 个直接调用
2. 搜 "orderService.create"(小写实例名)    → 又找到 1 个
3. 搜接口名 "IOrderService"                  → 找到 1 个接口定义
4. 猜测会不会有依赖注入容器间接调用           → 搜 DI 配置,不确定
5. 猜测会不会有通过泛型/反射调用              → 搜不到,不确定
消耗:15-20 分钟。结果:找到了 4 个调用方,但对"有没有更多"没有信心。
核心痛点:grep 只能做字面匹配——this.service.create() 如果 service 的类型声明在另一个文件、通过接口注入,grep 搜函数名根本搜不到。reviewer 只能靠经验猜"大概"这些。
问题二:"有没有违反项目惯例?"
这个改动把错误处理从 return null 改成 throw new Error('order creation failed')。
reviewer 要判断:项目里其他 service 的错误处理是怎么做的?是用 Error 还是 AppError?
1. 打开几个其他 service 文件参照            → 10 分钟
2. 发现有的用 AppError 有的用 Error         → 不确定哪个是"标准"
3. 看 README 和规则文件里有没有说            → 没写
4. 决定"先这样吧,以后统一"                  → 打 Approve
消耗:10 分钟。结果:没发现问题——但也没自信确认"没有问题"。如果项目的 80% service 用 AppError 而这个改动用了原生 Error,reviewer 大概率看不出来(因为他不会打开 40 个文件做统计)。
问题三:"改动前后的行为一样吗?"
create() 原来返回 null 表示失败,现在抛异常。调用方的处理逻辑必须从 if (result === null) 变成 try/catch。
reviewer 要确认:每个调用方的错误处理是否都相应更新了。
1. 逐个打开 4 个调用方文件                  → 5 分钟
2. 检查每个的错误处理是否从 null check 改成 try/catch
3. 发现 3 个改了,1 个没改                  → 那个没改的是不是故意的?
4. 问作者:"UserController 里没改,是有意的吗?"
5. 等回复……
消耗:10-15 分钟(不含等回复)。结果:发现了 1 个遗漏,但不确定有没有更多——因为问题一的搜索只找到 4 个调用方,如果实际有 6 个呢?
还有一类更隐蔽的情况——调用方的行为在代码层面看不出变化:
// 改动前:OrderController.ts
const result = await orderService.create(data)
if (!result) {
  return res.status(400).json({ code: 'CREATE_FAILED', message: '创建失败' })
}
return res.json({ data: result })

// 改动后:AI 没碰这个文件——但 create() 现在抛异常而不是返回 null
// 这段代码不会走 if 分支了(异常在 asyncHandler 里被捕获)
// 行为变了,但代码一个字没改,diff 里看不到
这种"代码没改但行为变了"的情况,是 reviewer 最容易漏的。
这个 PR 的 review 总结
| 步骤 | 时间 | 置信度 |
|---|---|---|
| 读 diff 理解改动意图 | 15 min | 高 |
| 搜索影响面(调用方) | 15-20 min | 低——grep 不保证完整 |
| 检查项目惯例 | 10 min | 低——没有可靠参照 |
| 确认行为一致性 | 10-15 min | 中——找到了 1 个遗漏,不确定有没有更多 |
| 合计 | 50-60 min | reviewer 打 Approve 时心里没底 |
有影响面工具时,同一个 PR 的 review 过程
如果 reviewer 面前不只有 diff,还有三类自动分析结果——同样的 PR,review 体验完全不同:
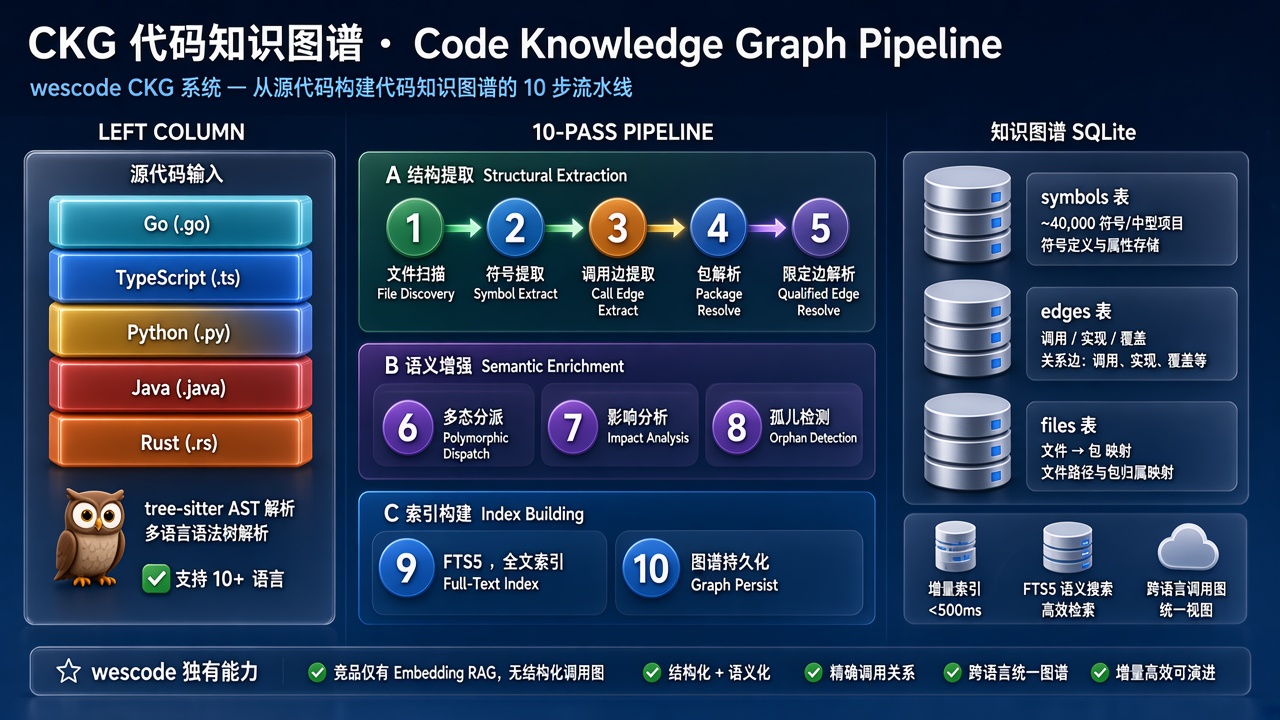
CKG(代码知识图谱)回答"影响了谁"
CKG 不是 grep——它是基于 tree-sitter 解析的调用图。它追踪的不是字符串匹配,而是语法树级别的调用关系,包含接口实现、依赖注入、跨文件类型推导。
reviewer 看到的结果:
OrderService.create() 的调用方(共 5 个):
  ├── OrderController.createOrder()        → controllers/order.ts:45
  ├── BatchImportService.importOrders()     → services/batch-import.ts:112
  ├── UserController.quickOrder()           → controllers/user.ts:78
  ├── useCreateOrder() [hook]              → hooks/useCreateOrder.ts:23
  │     (通过 IOrderService 接口间接调用)
  └── OrderEventHandler.onRetry()          → events/order-handler.ts:56
        (通过 DI 容器注入调用)
对比 reviewer 手动搜索:
- 手动 grep 找到 4 个,漏了 2 个(
useCreateOrder通过接口调用、OrderEventHandler通过 DI 调用——两者都不含字符串OrderService.create) - CKG 找到 5 个,零遗漏(含接口间接调用和 DI 注入调用)
- reviewer 花 0 分钟搜索——直接确认清单里的每个调用方是否都处理了契约变更
CSE(约束满足引擎)回答"有没有违反惯例"
CSE 不需要 reviewer 打开 40 个文件做人工统计。它扫描整个项目的代码模式,识别统计惯例:
CSE 检查结果(2 条发现):

⚠️ services/order.ts:89 — 错误类型不一致
  项目中 92% 的 service 层错误使用 AppError(38/41 个文件)
  此处使用了原生 Error
  建议:改为 throw new AppError('ORDER_CREATE_FAILED', '订单创建失败')

✅ 命名约定、文件组织、导出方式 — 未发现异常
对比 reviewer 手动检查:
- 手动检查:打开几个参照文件、不确定哪个是"标准"、决定"先这样"
- CSE:扫描全部 41 个 service 文件,用统计事实(92% 用
AppError)回答——不是意见,是数据
L2.5(行为基线)回答"行为变了吗"
L2.5 不需要 reviewer 逐个打开文件对比。它自动对比改动前后的可观测行为:
L2.5 行为变更报告:

🔴 OrderService.create() — 错误路径契约变更
  改前:失败返回 null(调用方用 if 判断)
  改后:失败抛 AppError 异常(调用方需 try/catch)
  已更新的调用方:3/5
  ⚠️ 未更新的调用方:
    - useCreateOrder.ts:23(仍在做 null check)
    - order-handler.ts:56(无错误处理)

✅ OrderService.update() — 无行为变更
✅ OrderService.delete() — 无行为变更
对比 reviewer 手动确认:
- 手动:逐个打开 4 个调用方(实际有 5 个但他只找到 4 个),检查错误处理——发现 1 个遗漏
- L2.5:自动对比全部 5 个调用方——发现 2 个遗漏(含 reviewer 没找到的那个)
有工具辅助时的 review 总结
| 步骤 | 时间 | 置信度 |
|---|---|---|
| 读 diff 理解改动意图 | 5 min | 高 |
| 确认影响面(CKG 已列出 5 个调用方) | 3 min | 高——调用图完整 |
| 确认惯例(CSE 标出 1 处错误类型不一致) | 2 min | 高——统计数据支撑 |
| 确认行为一致性(L2.5 标出 2 处未更新) | 3 min | 高——自动对比覆盖 |
| 合计 | 13-15 min | reviewer 打 Approve 时有据可查 |
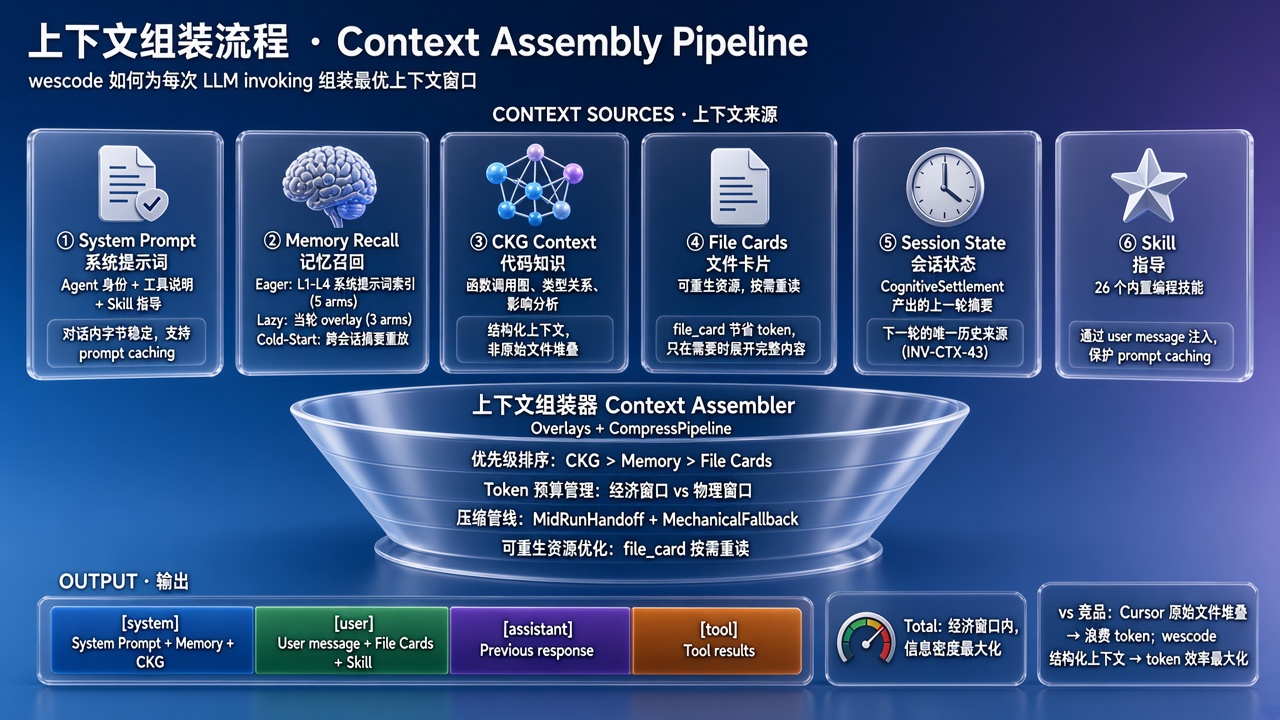
两种 review 过程的完整对比
回到文章开头的场景——同事 A review 那个 400 行 diff 的订单重构 PR:
没有影响面工具
11:00  同事 A 开始 review
11:15  读完 diff,理解了改动意图
11:20  发现 OrderService.create() 错误处理变了
11:25  搜 "OrderService.create" → 找到 3 个调用方
11:30  搜 "orderService.create" → 又找到 1 个
11:35  不确定有没有更多。搜接口名,不确定 DI 调用
11:40  打开几个 service 文件参照错误处理惯例——看不出明确标准
11:45  逐个检查 4 个调用方的错误处理
11:50  发现 1 个没改,Slack 问作者
11:55  等回复中……自己也不确定搜全了没有
12:00  Approve(心虚)

14:00  合入主干
17:00  QA 反馈页面白屏。追了 1 小时——
       useCreateOrder hook 通过接口间接调用 OrderService.create()
       grep 搜不到这个关系
       这个 hook 没有处理新的异常 → 整个页面 crash

总耗时:60 分钟 review + 1 小时追 bug = 2 小时
漏审:1 个接口间接调用
有 CKG + CSE + L2.5
11:00  同事 A 开始 review
11:05  读完 diff,理解了改动意图
11:08  看 CKG 调用方清单 → 5 个调用方(含 2 个接口间接调用)
       确认每个调用方的错误处理是否更新
11:10  看 CSE 检查结果 → 发现错误类型不一致(应该用 AppError)
       在 PR 里 comment:"请把 Error 改成 AppError"
11:12  看 L2.5 行为对比 → 标出 2 个调用方未更新错误处理
       在 PR 里 comment:"这两个地方也需要加 try/catch"
11:15  Request Changes

作者修复后重新提交
11:30  同事 A 复查 → CKG 清单不变、CSE 通过、L2.5 全绿
11:35  Approve

总耗时:35 分钟(含第二轮复查)
漏审:0
团队效率的量化对比
一个 5 人开发团队,AI 辅助编程后每天产出的 PR 从 10 个增加到 20 个。review 能力成为瓶颈(以下数据基于内部测试场景):
| 指标 | 无影响面工具 | 有 CKG + CSE + L2.5 |
|---|---|---|
| 单个 PR review 时间 | 40-60 分钟 | 10-20 分钟 |
| reviewer 每天能审多少 PR | 3-5 个 | 8-12 个 |
| PR 队列平均等待时间 | 4-8 小时 | 1-2 小时 |
| 漏审导致的生产 bug | 每月 2-4 个 | 大幅减少 |
| reviewer 的心理负担 | "我大概搜全了吧"——焦虑 | "工具查过了、结果对"——确信 |
关键洞察:AI 把代码生产速度提高了 5-10 倍,但如果 review 速度不变,团队效率的上限就被 review 瓶颈卡住。CKG + CSE + L2.5 把 review 速度提高 3-4 倍(内部测试数据),让团队能消化 AI 带来的更高产出。
三个工具各解决什么问题
| 工具 | 解决的问题 | 工作原理 | 能力边界 |
|---|---|---|---|
| CKG(代码知识图谱) | 改动影响了谁? | 基于 tree-sitter 解析构建调用图,追踪直接调用、接口间接调用、DI 注入调用 | 覆盖静态可分析的调用关系;动态反射调用(eval、字符串拼接方法名)不在范围内 |
| CSE(约束满足引擎) | 有没有违反项目惯例? | 扫描项目代码统计编码模式,识别多数派约定,标注偏离多数派的代码 | 统计推导——需要足够样本量(同类文件 >5 个);新建的小模块样本不足时置信度低 |
| L2.5(行为基线) | 改动前后行为一样吗? | 对比函数的返回值结构、错误类型、排序顺序等可观测行为 | 对比的是静态可推断的行为;运行时副作用(写数据库、发消息)不在对比范围 |
能力边界的进一步说明
这三个工具不是银弹。以下情况仍然需要 reviewer 自己判断:
CKG 不覆盖的调用关系:
eval('orderService.' + methodName + '()')— 动态字符串拼接的调用,静态分析看不到- 通过消息队列触发的异步调用(发一条消息到 BullMQ,另一个 worker 消费)
- 跨服务 HTTP 调用(微服务架构里,service A 通过 HTTP 调 service B)
CSE 不覆盖的惯例:
- 业务逻辑层面的惯例("退款金额不能超过原订单金额"——这是业务规则,不是代码模式)
- 团队刚达成的、还没有在代码中体现的新约定
- 只有 2-3 个文件的新模块——样本太少,统计推导不可靠
L2.5 不覆盖的行为:
- 运行时副作用——写数据库、发邮件、调外部 API 的行为变化
- 性能变化——算法时间复杂度从 O(n) 变成 O(n²),L2.5 不检测
reviewer 需要知道这些边界在哪——工具覆盖的部分交给工具,工具覆盖不了的部分自己重点看。边界清晰比"好像覆盖了但不确定"好得多。
各工具 review 能力对比
| 工具 | 帮 reviewer 做了什么 | reviewer 仍需要自己做的 |
|---|---|---|
| Cursor | diff 展示、内联注释 | 影响面搜索、惯例判断、行为确认——全部手动 |
| Claude Code | 可以问"这个改动影响了什么",每次靠 grep/read 重新搜 | grep 不保证完整;没有惯例检查和行为对比 |
| Copilot | PR 自动总结(描述改了什么) | 描述 ≠ 验证——reviewer 仍需自己确认影响面 |
| wescode | CKG 列出调用方 + CSE 标出惯例违反 + L2.5 对比行为变更 | 确认工具结果正确、判断业务意图是否合理 |
| 通义灵码 / Trae | 无独立 review 辅助 | 全部手动 |
你现在能做什么
-
PR 不要太大。 让 AI 每次只做一件事。12 个文件 400 行 diff 的 PR,人 review 不过来。拆成 3 个小 PR,每个 4 文件 ~130 行,reviewer 的认知负担低 3 倍
-
AI 改完之后,你自己先做一遍影响面检查再提 PR。 不要把"确认影响面"留给 reviewer——你比 reviewer 更了解这次改动的上下文。在 PR 描述里列出"影响到的文件和调用方"
-
AI 的"顺手优化"单独提一个 PR。 格式调整、import 重排、命名统一——和功能改动混在一起会让 reviewer 的工作量翻倍。分开提:一个纯格式 PR(直接 approve)、一个功能 PR(仔细 review)
-
考虑让工具辅助 review 而不是只辅助写。 "改代码"是 AI 编程的一半。另一半是"确认改对了"。如果你的工具只帮你写不帮你查,你的效率提升就被 review 瓶颈卡掉了一半——wescode 的 CKG + CSE + L2.5 组合就是为 review 这个环节做的