别只看演示:AI 编程工具现在做不到的那些事
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
每个产品页面都在讲自己多好。这篇讲 wescode 做不到什么、做得不够好的地方、以及你应该有的预期。
Q: wescode 的社区和生态跟 Cursor 比差多少?
差很多。这是目前最大的差距,没有之一。
Cursor 有几十万活跃用户,Stack Overflow、Reddit、Twitter 上随便搜都能找到使用经验和问题解答。wescode 的用户基数目前还很小,这意味着:
- 遇到问题不容易搜到现成答案。 Cursor 的问题 Google 一下大概率有人踩过,wescode 的问题你可能是第一个遇到的
- 社区贡献的 Skill 和模板还很少。 Cursor 有大量社区分享的
.cursorrules模板,wescode 的 Skill 生态刚刚起步 - 第三方教程和视频内容几乎没有。 学习资源主要靠官方文档
我们不会用"小而精"来美化这个差距。社区生态需要时间积累,没有捷径。
缓解方式: 我们的 GitHub Issues 和微信社区目前响应速度快(用户少的好处),遇到问题直接提 Issue 通常当天或次日有回复。随着用户增长,我们计划建立社区答疑库和 Skill 市场。
Q: 插件兼容性怎么样?
wescode 是 VS Code Fork,理论上兼容所有 VS Code 插件。实际上大部分插件可以直接用,但有例外:
- GitHub Copilot 插件不能用。 Copilot 的 VS Code 扩展做了宿主检测,只允许在官方 VS Code 和 GitHub Codespaces 里运行。这是 GitHub 的商业策略,不是技术限制
- 少数依赖 VS Code Insiders API 的插件可能有兼容问题。 wescode 的基座版本跟 VS Code stable 对齐,Insiders-only 的 API 可能缺失
- Remote Development 扩展(Remote SSH、Dev Containers)需要测试。 官方 Remote 扩展对 VS Code Fork 的支持参差不齐——有些能用,有些会报错
- Copilot Chat 的衍生插件不可用。 基于 GitHub Copilot Chat API 构建的插件同样受宿主检测限制
我们的测试覆盖: 对主流插件(ESLint、Prettier、GitLens、Python、Java Extension Pack、Docker、Go、Rust Analyzer 等)做了兼容性验证。长尾插件主要靠用户反馈——遇到不兼容的请报 Issue。
workaround: 对于不兼容的插件,通常有替代品。比如 Copilot 不能用不要紧——wescode 自带的 AI 能力(Agent Chat + CKG + CSE)在代码理解深度上远超 Copilot 的行级补全。Remote SSH 不兼容的话可以用 Open Remote SSH(社区版)作为替代。

Q: CKG 调用图有什么局限?
CKG 是 wescode 的核心差异化能力,但它不是万能的。诚实地说:
动态派发覆盖不全。 比如 Java 的反射调用、Python 的 getattr 动态属性访问、JavaScript 的 obj[methodName]() 动态方法调用——这些在运行时才能确定调用目标的模式,CKG 的静态分析无法完全覆盖。
# CKG 追踪不到这个调用
handler = getattr(service, action_name)  # action_name 是运行时变量
handler(request)

# CKG 可以追踪这个调用
handler = service.process_payment  # 静态可确定的调用
handler(request)
什么时候这个局限会变成问题? 当你的项目大量使用「策略模式 + 动态分派」时。一个典型场景:Python 的 Web 框架里,URL 路由映射到处理函数:
# Django 的 URL 路由——CKG 追踪不到 "views.order_detail" 这个字符串调用
urlpatterns = [
    path('orders/<int:pk>/', views.order_detail),  # 字符串引用
]

# Flask 的装饰器路由——CKG 能追踪到(装饰器语法是静态可分析的)
@app.route('/orders/<int:pk>')
def order_detail(pk: int):
    ...
同样是 URL 路由,Django 的方式 CKG 追踪不到(字符串引用),Flask 的方式 CKG 能追踪到(装饰器)。这类差异在使用时需要知道。
元编程和代码生成。 如果你的项目大量使用 AST 变换、宏展开、运行时代码生成(比如某些 ORM 的 Model 定义),CKG 看到的是变换前的代码,不是运行时实际执行的代码。
什么时候会变成问题? 典型场景:SQLAlchemy 的 declarative_base() 生成的 Model 类——CKG 能看到 Model 定义,但看不到 ORM 在运行时生成的 .query、.filter、.join 等方法链。如果你重构了某个 Model 的字段名,CKG 能找到代码里直接引用这个字段的地方,但找不到 ORM 动态生成的查询方法里的引用。
超大文件性能。 单个文件超过几万行(是的,有些遗留项目真的有这种文件)时,tree-sitter 解析会明显变慢。实测一个 5 万行的 legacy .java 文件,首次解析约 8 秒(内部测试数据)。
什么时候会变成问题? 遗留项目里那些"上帝类"——某个 Utils.java 塞了 3 万行、某个 constants.ts 塞了 2 万行。建议先拆文件再索引。更重要的是:这种文件本身就是需要重构的技术债,CKG 的慢恰恰在提醒你。
跨语言调用。 如果你的项目里 Python 调 C 扩展、Java 调 JNI、TypeScript 调 WebAssembly,CKG 在语言边界处会断开——它无法追踪跨语言 FFI 的调用关系。
什么时候会变成问题? 典型场景:一个 Python 机器学习项目,核心算法用 C++ 写、通过 pybind11 暴露给 Python。你改了 C++ 函数的参数签名,CKG 不知道 Python 端有哪些调用方需要同步修改——因为绑定层是 C++ 宏,不是 Python 的 import。
CKG 各语言的支持深度如下:
| 能力 | Go / TS / Python / Java | Rust / C / C++ | 其他语言 |
|---|---|---|---|
| 符号提取 | ✅ 完整 | ✅ 完整 | ✅ tree-sitter |
| 调用图 | ✅ 跨包/跨模块 | ⚠️ 基本 | |
| 多态分派 | ✅ 接口/继承 | ⚠️ trait 基本 | |
| 影响面分析 | ✅ 三级传递 | ⚠️ 一级 |
改进路线: 动态派发的部分覆盖(通过类型推断猜测可能的调用目标)和跨语言桥接是下一阶段的重点工作项。
Q: 本地模型的体验跟商业模型差距有多大?
有明显差距,而且差距取决于任务复杂度。
| 任务类型 | 本地模型(32B 级别) | 商业模型(Claude Sonnet 4) | 差距原因 |
|---|---|---|---|
| 简单补全(一行代码) | 够用 | 够用 | 模式匹配足够 |
| 单函数生成 | 大部分可用 | 好用 | 上下文需求低 |
| 多文件重构 | 经常出错或遗漏 | 通常可靠 | 需要大窗口 + 推理 |
| 复杂架构推理 | 基本不可用 | 多数可靠 | 需要深层推理链 |
| 长上下文理解 | 明显退化 | 表现稳定 | 本地模型窗口小 |
| Debug 多步排查 | 经常跑偏 | 可靠导航 | 需要上下文保持 |
不要因为 wescode 支持本地模型,就觉得可以完全不花模型费用。 本地模型适合轻量级场景(离线、简单补全、隐私极端敏感),复杂开发任务还是需要商业模型。
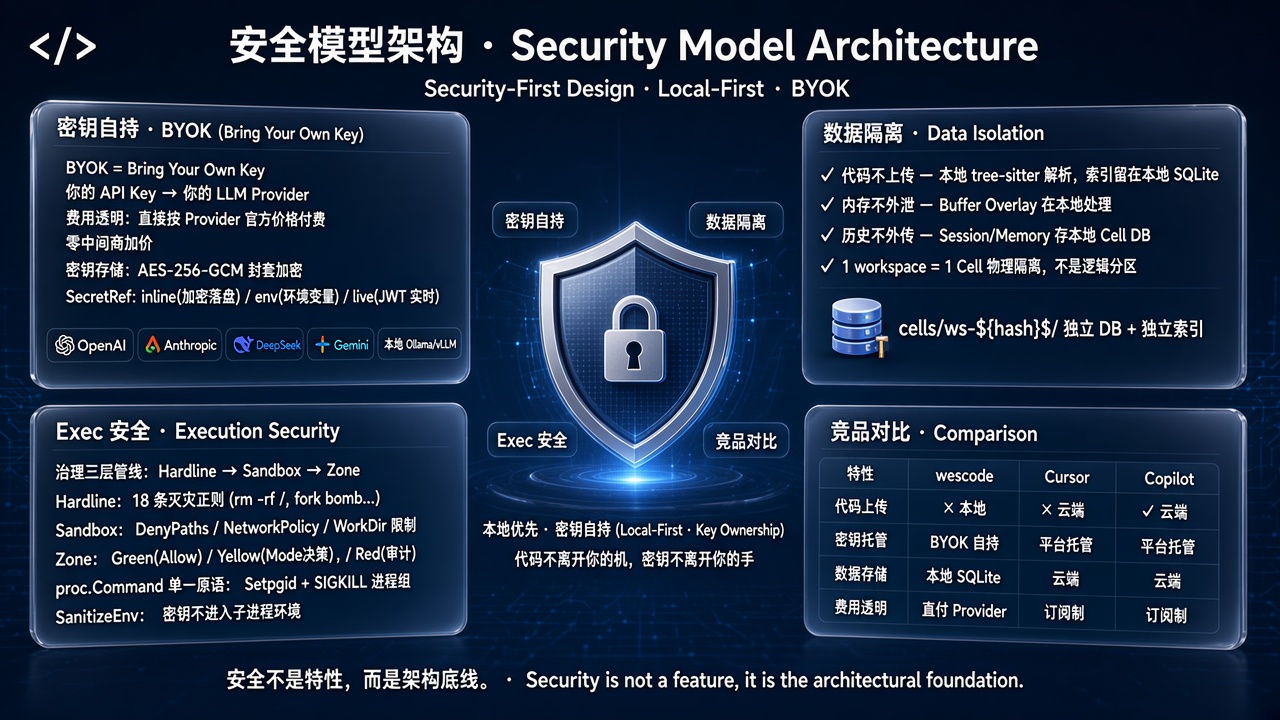
推荐策略: 日常用商业模型做主力,本地模型作为备用(离线场景)或用于不敏感的简单任务。WES 账户 + BYOK 混合配置可以在成本和效果之间找到平衡。
Q: 记忆系统真的能记住所有东西吗?
不能。wescode 的记忆系统(基于 wesgine 的认知结算机制)有几个结构性限制:
记忆是有损压缩。 每次对话结束时,引擎会提取关键事实和偏好写入记忆,但不是逐字保存整段对话。如果你在一次长对话中讨论了一个复杂的架构决策过程,记忆保留的是结论和关键约束,中间的推理过程会被压缩掉。
记忆的召回依赖语义匹配。 记忆条目通过语义相似度被召回到新对话中。如果你的新问题跟之前记住的知识在措辞上差异很大,可能召回不到——这是所有基于 embedding 检索的系统的通病。
跨 workspace 的记忆是隔离的。 wescode 的设计是"1 workspace = 1 Cell",不同项目的记忆不互通。这是有意为之(防止项目 A 的约定污染项目 B),但也意味着你在项目 A 教给 AI 的通用编码偏好不会自动出现在项目 B 里。
记忆有容量管理。 引擎会自动执行 GC(垃圾回收),长期不被召回的记忆条目会被标记为 stale 并最终清理。你不会因为"记忆太多"而出问题,但也意味着很久以前教的、一直没被用到的知识可能被清掉。
workaround: 把重要的项目约定写在 AGENTS.md 或 .cursor/rules/ 文件里,而不是只靠对话教 AI。写在文件里的规则是永久的,每次对话都会被加载,不受记忆 GC 影响。
什么时候会变成问题? 当你在项目 A 里教了半小时 AI "用 Tailwind 不用 styled-components",然后在项目 B 里 AI 又建议你用 styled-components——因为两个项目是不同的 Cell,记忆不互通。跨项目的通用偏好只能靠规则文件分发(复制到每个项目仓库,或者用 Git submodule 共享一份规则模板)。
Q: 补全体验跟 Cursor 比怎么样?
直说:Ghost Text 补全体验目前不如 Cursor 的 Tab 补全。
Cursor 的行级补全是他们打磨最久的功能——触发灵敏、补全速度快、上下文猜测准确。wescode 的 Ghost Text 补全通过 FIM(Fill-in-the-Middle)端点驱动,功能上完整,但:
| 维度 | Cursor Tab | wescode Ghost Text |
|---|---|---|
| 触发速度 | 几乎即时 | 200-500ms 延迟 |
| 多行补全 | 经常能补完整函数 | 通常补 1-3 行 |
| 上下文利用 | 用 Embedding 索引增强 | 用 CKG + 当前文件窗口 |
| "猜你想写什么" | 很准 | 基本准确,偶尔跑偏 |
什么时候会变成问题? 如果你写代码 80% 靠 Tab 补全、20% 靠 AI 对话——那 Cursor 的补全体验更好。如果你更多靠 AI 对话做跨文件理解和重构——wescode 的 CKG + Agent Chat 比 Cursor 更有深度。两者的侧重点不同。
改进计划: 补全体验是当前优化重点之一。FIM 端点的上下文注入(利用 CKG 的调用关系做 context 增强)在开发中。
Q: 跟 Claude Code 比呢?
Claude Code 是 Anthropic 官方出的 CLI Agent,有几个 wescode 做不到或做得不如它的点:
- Claude Code 直接用最新最好的 Claude 模型, 优化深度可能比第三方客户端更好(因为他们控制模型和客户端两端)
- Claude Code 的终端交互体验非常流畅, 对于纯命令行党来说可能比 GUI 编辑器更顺手
- Anthropic 对 Claude Code 的投入和迭代速度很快, 功能演进节奏我们追不上
反过来,wescode 有而 Claude Code 没有的:
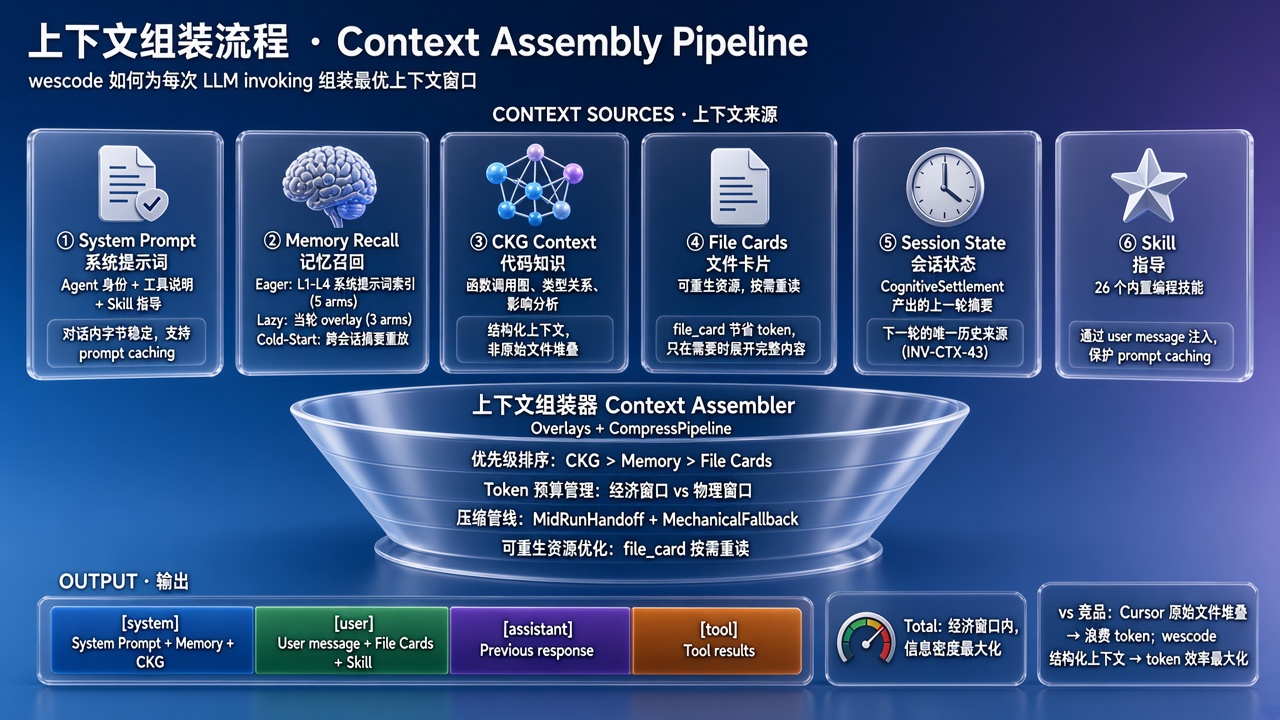
- CKG 调用图(Claude Code 用 grep+read 做代码理解,遇到 40 万行以上的项目会系统性不够)
- CSE 自动约束推导(隐式规则不会被改掉)
- GUI 编辑器的完整开发体验(调试器、Git 集成、插件生态)
- 多模型支持(Claude Code 只能用 Claude)
- 长期记忆跨会话保留
简单说: Claude Code 适合"在终端里快速完成任务"的场景,wescode 适合"在编辑器里深度理解和改造项目"的场景。两者的交集不大,甚至可以同时用——Claude Code 做 CLI 任务,wescode 做编辑器内的深度开发。
Q: 还有什么已知的痛点?
直说几个:
-
首次安装到能用需要配置 API Key, 不像 Cursor 注册就能写代码。我们提供 WES 账户来降低门槛(注册后直接用,无需自己申请 API Key),但 BYOK 用户多了一步配置。
-
Windows 支持还在完善中。 macOS 和 Linux 是当前的主要开发和测试平台,Windows 上的一些边界场景(比如 WSL 集成、路径处理、中文路径)可能有粗糙的地方。
-
文档还不够全。 这是创业期产品的通病——功能迭代快但文档跟不上。你可能需要读设计文档(
design/目录)来理解某些高级功能的用法。 -
内联补全(Ghost Text)体验还在打磨。 wescode 有 Ghost Text 补全(通过 FIM 端点驱动),但流畅度和触发灵敏度跟 Cursor 的 Tab 补全相比还有差距。我们先做好了代码理解(CKG)和编辑正确性(CSE),补全体验在持续改进中。
-
多语言项目支持深度不均匀。 Go、TypeScript、Python、Java 的 CKG 支持最完整;Rust、C/C++ 其次;其余语言只有 tree-sitter 级别的符号提取。如果你的主力语言不在前四个里,CKG 的体验会打折扣。
-
AI 编辑大文件时响应延迟。 对超过 2000 行的文件做大范围修改时,编辑引擎的三级匹配需要更多时间。这不是 bug——是精确匹配的代价——但体验上会有等待感。
我们不认为承认不足会伤害产品。相反,你现在知道了边界在哪里,能做出更好的选型判断。
Q: 这些做不到的东西有时间线吗?
按优先级排列我们当前的改进路线:
| 局限 | 优先级 | 预计时间 | 难度 |
|---|---|---|---|
| Ghost Text 补全流畅度 | P0 | 近期持续优化 | 中——FIM + CKG context 注入 |
| Rust trait 完整追踪 | P1 | 下个大版本 | 高——需要新的类型推导 Pass |
| 动态派发部分覆盖 | P1 | 下个大版本 | 高——需要类型流分析 |
| Windows WSL 边界问题 | P1 | 近期 | 中——路径归一化 |
| 跨语言 FFI 桥接 | P2 | 中期 | 很高——需要多 AST 关联 |
| 跨 workspace 通用记忆 | P2 | 中期 | 中——需要设计共享机制 |
| ORM 代码生成追踪 | P3 | 远期 | 很高——需要理解生成规则 |
我们的工程原则是先解决影响面最大的问题。 补全流畅度影响每个用户的每次编辑;Rust trait 追踪只影响 Rust 用户;跨语言 FFI 只影响少数多语言项目。
你可以参与排优先级。 GitHub Issues 里的 👍 反应数量直接影响我们的排期。如果你的项目被某个局限卡住了——去 Issues 找到对应的(或创建一个),点个 👍,写一下你的具体场景。用户场景越具体,修复越快。
Q: 总结一下,wescode 适合谁、不适合谁?
| 适合 | 不适合 |
|---|---|
| 项目 > 5 万行,需要精确影响面分析 | 只写简单脚本 / 小项目(grep 就够了) |
| 主力语言是 Go / TS / Python / Java | 主力语言是 Haskell / Elixir 等小众语言 |
| 在意代码不出本机 | 对隐私没要求,Cursor 方便就行 |
| 想自己控制模型和费用(BYOK) | 不想管 Key,注册即用更重要 |
| 团队需要共享 AI 行为规则 | 个人独立开发,不需要协作 |
| 经常在离线环境工作(高铁 / 内网) | 始终在线 |
| 做大型重构、技术债务治理 | 只做新功能开发,不碰旧代码 |
最终判断标准不是这张表,是你自己的一手体验。 装一个试一周——上面所有"做不到"的都不影响你试用期间得出有效结论。
一句话总结: wescode 的长板很长(CKG 调用图、BYOK、数据不出设备),短板也真实存在(补全体验、社区生态、语言覆盖不均匀)。如果长板命中你的核心需求——试试不亏。如果短板恰好是你的 blocker——等改进或选更适合的工具。