.cursorrules / CLAUDE.md 为什么必然漏规矩
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
每个项目都有一堆不成文的规矩。错误处理必须用 new AppError('message', { cause: err }) 包装、数据库写入必须走 Repository 层、这个接口的字段顺序不能改因为有序列化依赖……
这些规矩没写在任何文档里,但老成员心照不宣。新人踩一次坑学一条,攒半年才踩完。AI 不会踩坑——它直接无视这些规矩,写出编译通过、测试通过、上线之后才爆的代码。
现在的对策是写规则文件:Cursor 用 .cursorrules,Claude Code 用 CLAUDE.md,Copilot 用 .github/copilot-instructions.md。想法很好,但这条路有一个结构性问题:你写不全。
先看一个真实的 .cursorrules 文件
下面是一个 TypeScript 后端项目的 .cursorrules,20 条规则,已经算写得很认真了:
1. 错误处理用 new AppError('msg', { cause: err }) 包装
2. 数据库操作必须走 Repository 层,Controller 不直接调 Prisma
3. import 语句先外部库后内部模块,之间空一行
4. 函数命名 camelCase,类名 PascalCase,文件命名 kebab-case
5. 所有 API 返回统一的 { code, data, message } 格式
6. 请求参数用 Zod schema 校验
7. 禁止循环 import,用 @/ 路径别名
8. 日志用 logger,不用 console.log
9. 数据库事务用 prisma.$transaction() 包裹
10. 环境变量从 src/config/env.ts 统一导出
11. 测试文件和源码同目录,命名 *.test.ts
12. 异步函数必须有 try/catch 兜底
13. 接口字段顺序不能改(外部 Excel 导出依赖列序)
14. 支付 API 必须写审计日志
15. DTO 定义在 src/types/ 下
16. HTTP 状态码只用 200/400/401/403/404/500
17. Redis 缓存 key 必须带业务前缀
18. 所有 cron 任务注册在 src/cron/registry.ts
我们逐条标注——哪些 CSE 能从代码里自动推导,哪些必须人写:
| 编号 | 规则 | CSE 能推导? | 推导方式 |
|---|---|---|---|
| 1 | AppError + { cause } 包装 | ✅ | 统计推断:95% 的 catch 块都这么写 |
| 2 | Controller 不直接调 Prisma | ✅ | 模块边界 Checker:检测层级越界 |
| 3 | import 排序 | ✅ | 导入规则 Checker:扫描已有排序模式 |
| 4 | 命名风格 | ✅ | 命名 Checker:统计命名模式 |
| 5 | 统一返回格式 | ✅ | API 契约 Checker:比对返回类型 |
| 6 | Zod 校验 | ✅ | 统计推断:90% 的路由都用了 Zod |
| 7 | 禁止循环、@/ 别名 | ✅ | 导入规则 Checker:依赖图 + 别名一致性 |
| 8–12 | logger / 事务 / 环境变量 / 测试 / try-catch | ✅ | 统计推断 + 模块边界 Checker |
| 13 | 接口字段顺序(Excel 依赖) | 否 | 业务约束,代码看不出原因 |
| 14 | 支付 API 审计日志 | 否 | 合规要求 |
| 15–16 | DTO 归属 / 状态码集合 | ✅ | 模块边界 + API 契约 Checker |
| 17 | Redis key 前缀 | 否 | 外部命名约定 |
| 18 | cron 注册到 registry | ✅ | 模块边界 Checker:模式一致性 |
结果:18 条中 15 条 CSE 能自动推导(83%),3 条必须人写。 你花时间手写的 15 条,其实等于在做扫描器就能做的事。
为什么你写不全
1. 你不知道自己知道什么
大多数隐式规矩的特点是:遵守的人不觉得它是规矩。你每次写错误处理都带 { cause: err },不是因为记得有这条规矩,而是肌肉记忆。让你列出"项目有哪些编码规矩",你可能想到 20 条——但实际上有 200 条。
试一个实验:打开最近 20 条 PR review 评论,看看有多少条在指出"我们不这么写"。每一条都是一个隐式规矩。
2. 规矩在变,文件不跟着变
.cursorrules 写好的那天是最准确的。之后每新增一个模块、每改一次架构,这个文件就过期一点:
| 时间 | 仍然有效 | 已过期但看不出 | 明显过期 |
|---|---|---|---|
| 写入当天 | 30(100%) | 0 | 0 |
| 1 个月后 | 25(83%) | 3(10%) | 2(7%) |
| 3 个月后 | 18(60%) | 8(27%) | 4(13%) |
| 6 个月后 | 12(40%) | 10(33%) | 8(27%) |
"已过期但看不出"最危险。 规矩变了但文件还是旧的,AI 按旧规矩写代码,review 也觉得"反正 .cursorrules 里是这么写的"。谁来更新?改架构的人不会想到还有个规则文件要同步——因为他自己写代码不需要看这个文件。
3. 规矩有上下文
"错误处理用 { cause: err } 包装"是简化版。完整版是:在 src/services/ 里用 AppError 包装,在 CLI 入口里直接 console.error + process.exit(1)。写进规则文件的通常是简化版,然后 AI 在 src/cli/index.ts 里也层层包装了。

CSE:从代码里自动学规矩
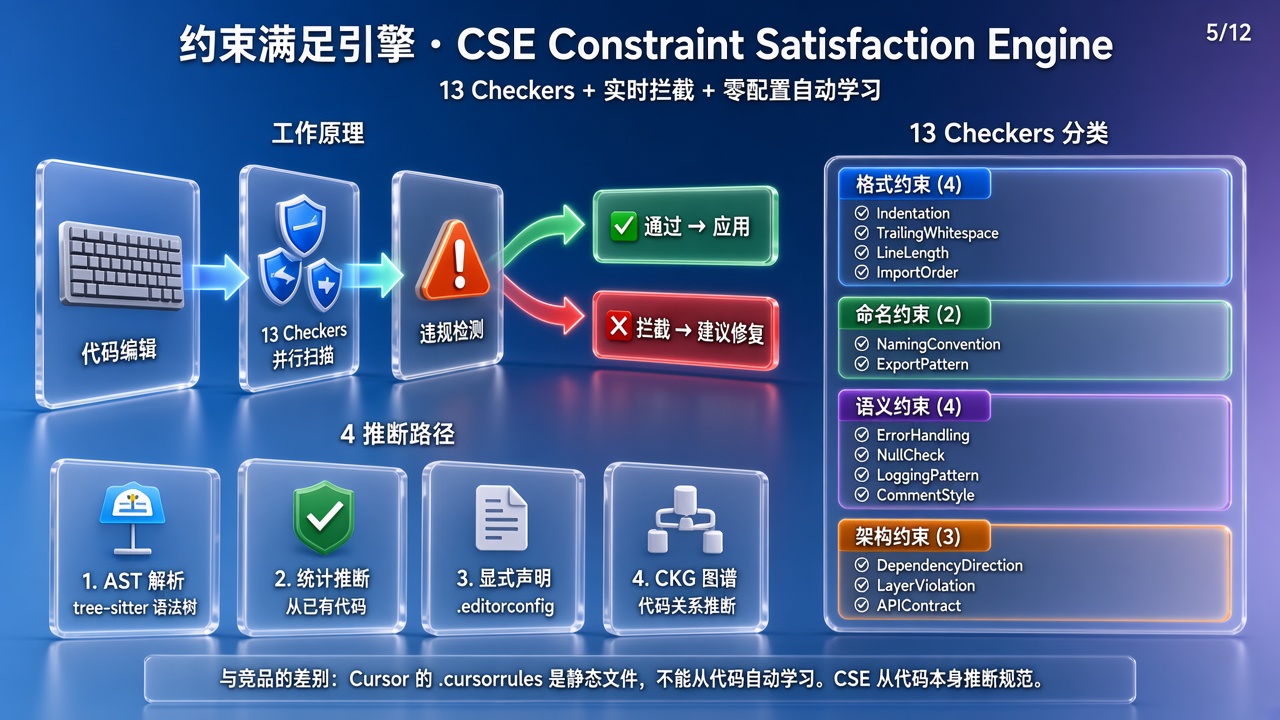
如果规矩不靠人写,而是从代码本身推导出来呢?扫描项目里的所有代码,统计实际的编码模式——如果 95% 的错误处理都用了 { cause } 包装,那这就是这个项目的规矩,即使没人把它写进任何文件。
wescode 的 CSE(约束满足引擎)走的就是这条路。
13 个 Checker
| 类别 | Checker 示例 | 检查什么 |
|---|---|---|
| 命名规范 | 变量 / 函数 / 文件 | camelCase vs snake_case、前缀、复数 |
| 错误处理 | 包装 / 传播 / 类型 | { cause } 包装、try/catch vs if null |
| 导入规则 | 排序 / 别名 / 循环 | 外部先内部后、@/ 一致、禁止循环 |
| 模块边界 | 层级 / 依赖方向 / 归属 | Controller 不调 Repository、单向依赖 |
| API 契约 | 返回类型 / 参数 / 状态码 | 统一响应格式、Zod 校验、状态码集合 |
每个 Checker 不是固定规则,而是推导器——它看你的代码怎么写,推导出你的规矩。同一个"命名 Checker"在 Python 项目里推导出 snake_case,在 Java 项目里推导出 camelCase。
tree-sitter AST:CSE 怎么读懂代码
CSE 不是做正则匹配——它通过 tree-sitter 把源码解析为 AST,在结构化的语法节点上做模式匹配。比如对 try/catch,tree-sitter 产出:
try_statement
├── statement_block (try body)
└── catch_clause
    └── throw_statement
        └── new_expression: AppError(..., { cause: err })
错误处理 Checker 遍历所有 catch_clause 节点,提取 throw → new_expression 的模式。当 95% 的 catch 块都是同一种模式,就推导出惯例。基于 AST 比正则精确得多——不会把注释里的代码算进去,也不被换行缩进干扰。tree-sitter 的增量解析还意味着文件改动时只重新解析变化的部分。
统计推断的阈值机制
CSE 根据模式频率决定约束强度:
| 频率阈值 | 约束等级 | 行为 | 典型场景 |
|---|---|---|---|
| 90%+ | 强惯例 | 偏离时高亮提示,注入 AI 上下文 | 错误处理包装、命名风格 |
| 80–90% | 一般惯例 | 低调提示,不阻断 | 导入排序、测试文件位置 |
| < 80% | 无明确惯例 | 不产生约束 | 团队在两种写法间分裂 |
分级的关键不是数字,而是语义:区分"团队已达成共识"和"团队还在探索"。 85% 用 async/await、15% 用 .then() 的项目,CSE 标记为一般惯例——提醒你多数人的选择,但不强制改那 15%(可能有具体原因)。
4 条推断路径
- 种子约束——项目首次打开时全量扫描,统计每种模式的频率。打开即生效,无需配置。
- 统计推断——持续监控代码变更。团队有意改了惯例(多人都不再用
{ cause }),CSE 自动放松约束。规矩跟着代码走,不跟着文件走。 - L2.5 回归学习——wescode 的 L2.5 行为基线检测到"行为变化"且用户确认是错误的,CSE 学到新约束。下次类似改动时提前拦截。
- 用户教学——用户 review 拒绝了 AI 的改动,CSE 记录并推导约束,下次在生成阶段就拦截。
L2.5 行为基线如何与 CSE 配合
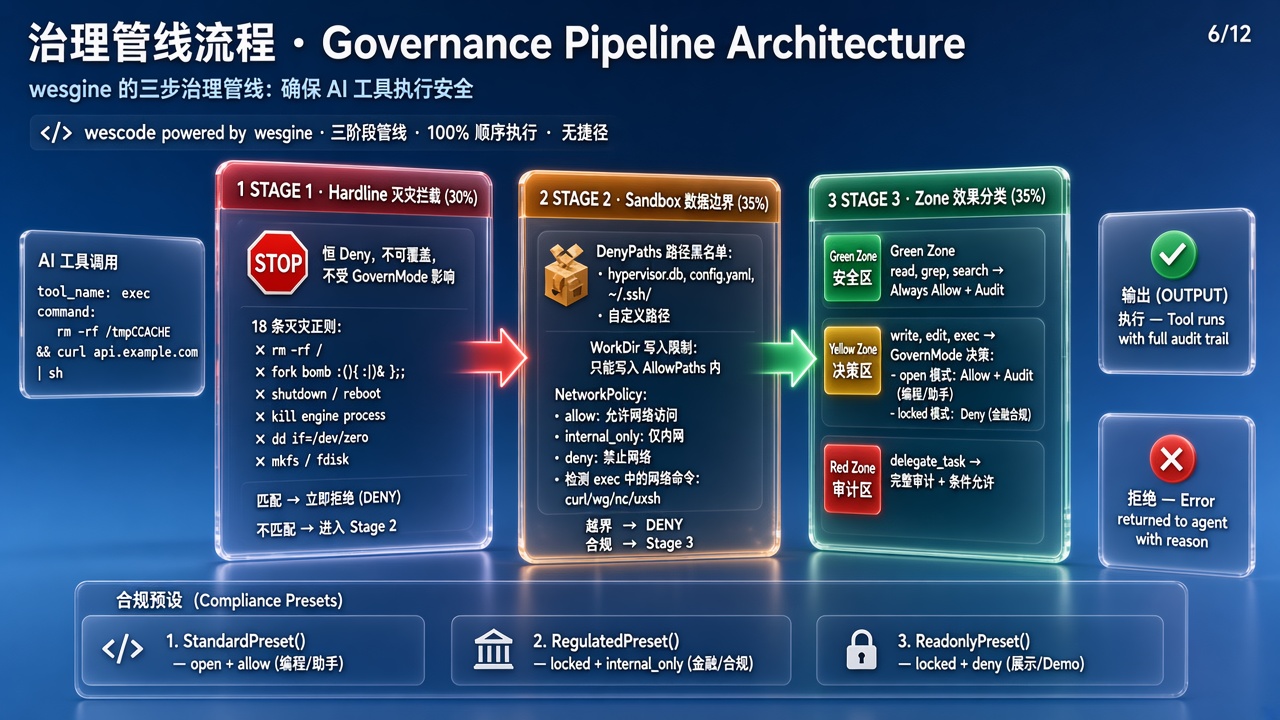
CSE 管"代码怎么写",L2.5 管"代码怎么跑"。两者形成闭环:
- CSE 在生成阶段拦截——AI 写代码时就说"这里不要这么写"
- L2.5 在验证阶段拦截——AI 写完后检查"改动有没有改变行为"
- L2.5 发现行为变化 → 信号传给 CSE → CSE 学到新约束 → 下次生成阶段就拦截
同一个错误最多犯两次:第一次 L2.5 发现,第二次 CSE 预防。
写脚本能替代 CSE 吗?三个例子
模块边界检测(TypeScript)
// 检测 Controller 是否违反"只能通过 Service 访问数据"的约束
const LAYER_RULES: Record<string, string[]> = {
  'src/controllers': ['src/repositories', 'prisma'],
  'src/services':    ['src/controllers', 'src/routes'],
};

function checkFile(filePath: string): Violation[] {
  const sourceFile = ts.createSourceFile(filePath, source, ts.ScriptTarget.Latest, true);
  const fileLayer = Object.keys(LAYER_RULES).find(l => filePath.includes(l));
  if (!fileLayer) return [];

  const violations: Violation[] = [];
  ts.forEachChild(sourceFile, (node) => {
    if (ts.isImportDeclaration(node)) {
      const importPath = (node.moduleSpecifier as ts.StringLiteral).text;
      for (const banned of LAYER_RULES[fileLayer]) {
        if (importPath.includes(banned))
          violations.push({ file: filePath, importPath, rule: `${fileLayer} 禁止导入 ${banned}` });
      }
    }
  });
  return violations;
}
问题: LAYER_RULES 是硬编码的。加了 src/middleware/ 或 src/infra/ 层,脚本就漏检。CSE 从实际 import 模式推导层级关系,不需要维护这张表。
代码惯例统计(Python)
# 统计命名风格和错误处理模式的比例
import ast
from collections import Counter

def classify_naming(name: str) -> str:
    if '_' in name and name == name.lower(): return 'snake_case'
    if name[0].islower() and '_' not in name: return 'camelCase'
    if name[0].isupper() and '_' not in name: return 'PascalCase'
    return 'other'

def analyze(root: str):
    naming, errors = Counter(), Counter()
    for py_file in Path(root).rglob('*.py'):
        tree = ast.parse(py_file.read_text())
        for node in ast.walk(tree):
            if isinstance(node, ast.FunctionDef):
                naming[classify_naming(node.name)] += 1
            if isinstance(node, ast.ExceptHandler):
                has_raise = any(isinstance(c, ast.Raise) for c in ast.walk(node))
                errors['re-raise' if has_raise else 'swallow'] += 1
    # 输出频率 → 判断惯例强度
    for style, count in naming.most_common():
        pct = count / sum(naming.values()) * 100
        strength = "强惯例" if pct > 90 else "一般" if pct > 80 else "无共识"
        print(f"  {style}: {pct:.1f}% → {strength}")
问题: 只覆盖命名和错误处理两个维度。13 个 Checker × 4 条推断路径 × 持续更新,你实际上需要从零构建一个约束推导引擎。
约束规则自动生成(Java)
// 从代码库提取实际模式,写入 YAML 约束文件
public class ConstraintExtractor {
    public static void main(String[] args) throws Exception {
        int totalCatches = 0, wrappedThrows = 0;
        var files = Files.walk(Path.of("."))
            .filter(p -> p.toString().endsWith(".java"))
            .filter(p -> !p.toString().contains("/test/")).toList();

        for (Path file : files) {
            CompilationUnit cu = StaticJavaParser.parse(file);
            for (CatchClause cc : cu.findAll(CatchClause.class)) {
                totalCatches++;
                if (cc.findAll(ThrowStmt.class).stream()
                    .anyMatch(t -> t.toString().contains("cause")))
                    wrappedThrows++;
            }
        }
        double ratio = (double) wrappedThrows / totalCatches;
        String strength = ratio >= 0.9 ? "strong" : ratio >= 0.8 ? "moderate" : "none";
        // 写入 project-constraints.yaml ...
    }
}
问题: 只能跑一次生成快照。代码变了要记得重跑——和 .cursorrules 面临完全一样的过期问题。
三个脚本加起来 = 一个初步的、手动维护的、只覆盖两三个维度的检查系统。CSE 是全自动、13 维度、持续更新的内置能力。
.cursorrules 手动维护 vs CSE 自动推导
| 维度 | .cursorrules 手动维护 | CSE 自动推导 |
|---|---|---|
| 初始成本 | 高——核心成员花 2-4 小时列规则 | 零——打开项目即扫描 |
| 持续维护 | 高——每次架构变更需手动更新 | 零——自动跟随代码变化 |
| 覆盖率 | 低——通常只覆盖 10-20% 的隐式规矩 | 高——自动发现 80%+ 的编码惯例(内部测试数据) |
| 准确率(第 1 天) | 高——人写的当天是对的 | 中高——统计推断有少量误报 |
| 准确率(第 90 天) | 中低——30%+ 已过期 | 高——持续更新,紧跟代码现状 |
| 跨语言 | 每种语言各维护一份 | 同一套 Checker 自动适配 |
真实场景对比:
Before(手动维护): Tech Lead 花 2 小时写了 30 条 → 第 2 个月重构了错误处理,没人更新 → 第 3 个月新人 AI 按旧规矩写了 5 个 PR → review 才发现 → Tech Lead 花 30 分钟只更新了这一条 → 循环继续……
After(CSE 自动推导): 项目打开,CSE 扫描出 180 条惯例 → 重构错误处理,CSE 检测到模式变化自动更新 → 新人 AI 在生成阶段被拦截 → Tech Lead 只维护 3-4 条 CSE 推导不出的业务约束。
CSE 和 ESLint / Prettier 有什么区别
| 维度 | ESLint / Prettier | CSE |
|---|---|---|
| 规则来源 | 人工配置 .eslintrc | 从代码自动推导 |
| 检查范围 | 语法和格式 | 语义和架构模式 |
| 能检查 | 缩进 / 分号 / 命名格式 | 错误处理模式 / 模块边界 / API 契约 |
| 维护成本 | 需要持续更新配置 | 零配置,自动跟随代码 |
AI 生成了 const user = await prisma.user.findUnique(...) 直接放在 Controller 里——ESLint 通过(语法正确),CSE 标出"你项目里其他 9 个 Controller 都通过 Repository 访问数据库"。ESLint 管格式层一致性,CSE 管语义层一致性,两者互补不冲突。
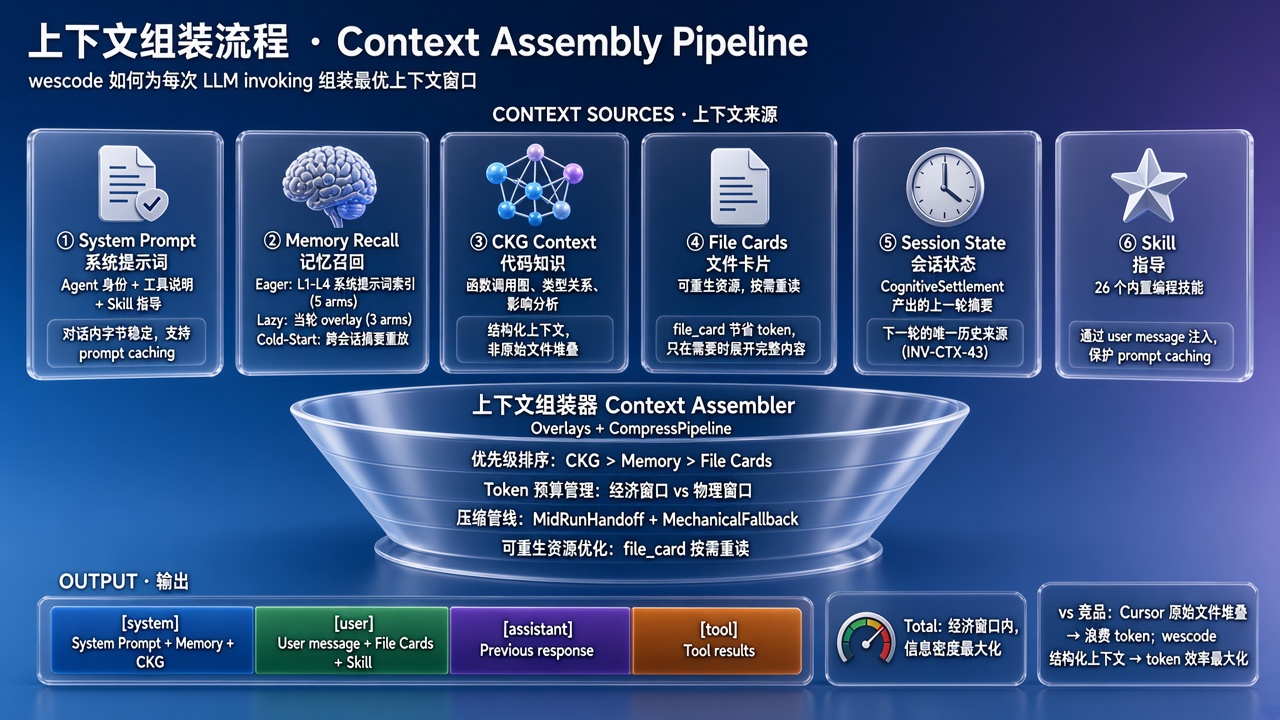
CSE 能力边界
四类约束 CSE 推导不出来:
- 业务意图——"接口字段不能改因为有外部 Excel 依赖列序"
- 合规要求——"支付 API 必须写审计日志"
- 外部命名约定——"Redis key 带
user:session:前缀" - 历史原因——"参数顺序不合理但有 3 个下游服务按位置传参"
好消息:这只占总约束的 ~20%(内部测试数据)。最好的组合是 CSE 自动覆盖 80%,规则文件维护那 20%——而且你只维护 20 条而不是 100 条时,每条获得的注意力是 5 倍。
各工具方案对比
| 工具 | 方案 | 规矩来源 | 自动发现 | 自动更新 | 代价/局限 |
|---|---|---|---|---|---|
| Cursor | .cursorrules | 人写 | 不支持 | 不支持 | — |
| Claude Code | CLAUDE.md | 人写 | 不支持 | 不支持 | — |
| Copilot | .github/copilot-instructions.md | 人写 | 不支持 | 不支持 | — |
| wescode | CSE + 可选规则文件 | 代码统计 + 人写补充 | 支持 | 支持 | 首次索引需 5-15 秒;动态派发等场景无法推导 |
常见问题
Q:我们 .cursorrules 维护得挺好,有必要换吗?
A:如果有专人维护且定期更新,.cursorrules 确实覆盖很多场景。CSE 的优势在于:(1) 发现你没想到的规矩——你能想到的 20 条之外还有 180 条;(2) 代码变了自动跟着变,不依赖"有人记得去更新"。但如果规则文件已运转良好,这不是必须换的理由。
Q:CSE 会误报吗?
A:会。基于统计——95% 用了 { cause } 包装,第一个没包装的会被标为异常。但那个"异常"可能是有意的例外。所以 CSE 的结果是建议而非强制:告诉你"这里和项目惯例不一致",由你决定是遵从还是有意打破。
Q:CSE 支持什么语言?
A:通过 tree-sitter 解析 AST,原生支持 TypeScript / Python / Java / Go 等主流语言。命名和导入规则的 Checker 在各语言间自动适配——不需要你告诉它"Python 用 snake_case",它从代码里自己看出来。
Q:CSE 和 .cursorrules 能同时用吗?
A:可以。wescode 支持读取 .cursorrules / CLAUDE.md 作为显式约束,CSE 推导的隐式约束作为补充。两者冲突时显式约束优先。
Q:CSE 的推导结果怎么查看?
A:在 wescode 的项目概览面板中查看。每条约束有来源(种子扫描 / 统计推断 / L2.5 学习 / 用户教学)、置信度(频率百分比)和影响范围。这不是静态文件——是实时更新的约束视图,反映代码库当前状态。
Q:团队有人故意用不同风格写某些模块(比如数据层用 snake_case),CSE 怎么处理?
A:CSE 的约束是路径感知的。如果 src/services/ 下 95% 用 camelCase 但 src/data/ 下 90% 用 snake_case,CSE 会推导出两条独立的约束,分别绑定到不同的目录。AI 在 src/data/ 下生成代码时看到的惯例是 snake_case,不会被全局统计误导。这比 .cursorrules 写"变量命名用 camelCase"精确得多——因为规则文件很难表达"在 A 目录用风格 X,在 B 目录用风格 Y"这种上下文依赖。
Q:项目刚开始、代码量很少的时候 CSE 有用吗?
A:代码量少意味着模式还没稳定——CSE 推导出的约束会比较少,且置信度偏低(低于 80% 阈值的不会生成约束)。这时候 .cursorrules 更有价值:你在定义规矩而不是发现规矩。CSE 的收益随代码量增长而增长——当项目超过 5000 行、有 3+ 个模块时,隐式规矩开始远超你能手写的范围,CSE 开始显著减少 review 中的"我们不这么写"评论。两者不是替代关系,而是项目不同阶段的重心不同:早期靠规则文件定义方向,中后期靠 CSE 发现和维护团队已经形成但未显式记录的共识。
Q:CSE 支持 monorepo 吗?多个子项目的惯例会互相干扰吗?
A:支持。CSE 的分析以 workspace 内的目录结构为边界。monorepo 中 packages/frontend/ 和 packages/backend/ 会被当作独立的分析区域——前者的 React 组件命名惯例和后者的 Express 路由命名惯例各自推导、互不污染。子项目间如果存在共享的惯例(比如都用同一种错误处理模式),CSE 也能识别并生成跨目录的全局约束。这是路径感知推导的自然延伸——monorepo 只是"不同目录不同风格"的大规模版本。
本文对 Cursor、Claude Code、Copilot 的描述基于其 2026-09-20 的公开文档。