grep、Embedding、调用图:三种代码检索的能力边界在哪
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
AI 编程工具帮你改代码之前,第一步是找到相关的代码。找得准不准,直接决定后面改得对不对。
你让 AI 改一个函数的参数类型,AI 改了 2 个调用方——但实际有 5 个。漏掉的 3 个,根本原因是工具的检索没找到它们。
三种主流检索方案——grep 文本搜索、Embedding 向量检索、调用图结构分析——各自的能力圈和盲区差距悬殊。搞清楚它们的边界,你就知道工具给出的答案该信几分。
一个项目,一个任务,三种答案
下面所有对比围绕同一个具体任务展开。一个 8 万行的 TypeScript 电商项目,processPayment 要从 (amount: number) 改成 (amount: number, currency: string)。你需要找到所有调用方。
项目关键代码:
// src/gateways/PaymentGateway.ts
interface PaymentGateway {
  processPayment(amount: number): Promise<PaymentResult>
}

class StripeGateway implements PaymentGateway {
  async processPayment(amount: number): Promise<PaymentResult> {
    return await this.stripe.charges.create({ amount })
  }
}
// src/services/OrderService.ts — 调用方 1(直接调用)
class OrderService {
  constructor(private gateway: PaymentGateway) {}

  async checkout(input: CheckoutInput): Promise<Order> {
    const payment = await this.gateway.processPayment(input.amount)
    await this.auditLogger.log('payment_processed', payment)
    return { ...input, paymentId: payment.id }
  }
}
// src/cron/settlement.ts — 调用方 2(接口间接调用)
class SettlementJob {
  constructor(private gateway: PaymentGateway) {}

  async execute() {
    const pending = await this.repo.findPendingOrders()
    for (const order of pending) {
      await this.gateway.processPayment(order.remainingAmount)
    }
  }
}
// src/webhooks/paymentCallback.ts — 调用方 3(回调链路)
class PaymentCallbackHandler {
  async handleRetry(event: PaymentEvent) {
    if (event.status === 'failed') {
      await this.gateway.processPayment(event.amount)
    }
  }
}
// src/admin/manualCharge.ts — 调用方 4(管理后台)
class AdminPanel {
  async manualCharge(userId: string, amount: number) {
    const gateway: PaymentGateway = this.gatewayFactory.create(userId)
    await gateway.processPayment(amount)
  }
}
调用关系:
OrderController → OrderService.checkout() → gateway.processPayment()
SettlementJob.execute()                   → gateway.processPayment()
PaymentCallbackHandler.handleRetry()      → gateway.processPayment()
AdminPanel.manualCharge()                 → gateway.processPayment()
4 个调用方,散落在 4 个不同的业务场景里。名字里都没有 processPayment——它们写的是 this.gateway.processPayment() 或 gateway.processPayment()。
方案一:grep — 快、确定、不思考
grep -rn "processPayment" . --include="*.ts"
1 秒出结果。47 个匹配。逐行分类:
| 类型 | 数量 | 是你要找的吗 | 你要做什么 |
|---|---|---|---|
函数定义(async processPayment(...)) | 3 | 否,是定义不是调用 | 跳过 |
接口声明(processPayment(amount): Promise<...>) | 2 | 否,是类型声明 | 跳过 |
直接调用(this.gateway.processPayment(...)) | 4 | 是 | 逐个确认 |
测试 mock(mockGateway.processPayment.mockResolvedValue(...)) | 14 | 否,测试 mock | 跳过 |
注释(// TODO: 重构 processPayment) | 6 | 否,文字提到 | 跳过 |
字符串/事件名(event: 'processPayment') | 5 | ⚠️ 可能需要改 | 逐个判断 |
类型引用(type ProcessPaymentArgs = Parameters<...>) | 5 | 否,类型元编程 | 可能要改但不是调用方 |
旧代码/变体名(processPaymentLegacy、processPaymentV2) | 4 | 否,不同函数 | 跳过 |
导入语句(import { processPayment } from ...) | 4 | 否,导入声明 | 跳过 |
47 个结果里真正的生产调用只有 4 个。你需要手动排除 43 个干扰项。 这就是大项目里"grep 一个下午"的来源——不是 grep 慢,是筛选慢。
grep 的致命盲区
如果代码里接口方法名和实现类方法名不一样,grep 就失效了:
// 假设 PaymentGateway 接口定义的是 process() 而不是 processPayment()
interface PaymentGateway {
  process(amount: number): Promise<PaymentResult>
}

// 调用方写的是 this.gateway.process(amount)
// grep "processPayment" 搜不到这一行
在依赖注入重、接口抽象多的 Java / TypeScript 项目里,这种情况很常见。grep 搜得到的前提是——你要找的名字必须字面出现在代码里。
grep 的独特优势
grep 也有不可替代的用途。配置文件(YAML、JSON、.env)里的引用:
# cron.yaml — grep 唯一能找到这里
jobs:
  - name: daily-settle
    handler: processPayment
    schedule: "0 2 * * *"
调用图和 Embedding 都不解析 YAML/JSON——配置文件里的字符串引用,只有 grep 能兜底。
grep 的能力边界一句话:代码里字面出现这个字符串的地方,它能找到;没字面出现的,它找不到。快、确定、不思考。
方案二:Embedding 向量检索 — 聪明、模糊、有时太聪明

Cursor、通义灵码、Trae 的主力检索方案。
怎么工作
- 切片:代码文件按函数或固定行数切成 200-500 行的片段
- 算向量:每个片段上传到 Embedding 模型(如 OpenAI
text-embedding-ada-002),变成一个 1536 维的向量 - 存储:向量存在远端数据库。Cursor 官方说:"Embedding 和混淆后的文件名长期存在我们的数据库中"(Privacy FAQ)
- 查询:你提问时,问题也变成向量,返回"距离最近"的代码片段
"距离最近"= 语义最相似。不是"调用关系最近"。
同一个任务,Embedding 返回什么
搜 "processPayment 的调用方",Embedding 按语义相似度排序返回前 8 个结果:
| 排名 | 函数 | 为什么排这里 | 是调用方吗 |
|---|---|---|---|
| 1 | PaymentGateway.refundPayment() | 名字最像——都有 Payment 且都在同一个类 | 否,兄弟方法 |
| 2 | PaymentGateway.validateCard() | 同类的另一个方法 | 否,无调用关系 |
| 3 | PaymentHistory.getRecords() | 名字里有 Payment | 否,无调用关系 |
| 4 | BillingService.calculateFee() | 语义相关(都和钱有关) | 否,无调用关系 |
| 5 | StripeGateway.processPayment() | 接口实现 | ⚠️ 是实现方,不是调用方 |
| 6 | PaymentEventHandler.onSuccess() | 事件处理,语义近 | 否,无调用关系 |
| 7 | OrderService.checkout() | 函数体里有 processPayment 这个词 | 是,真正的调用方 |
| 8 | InvoiceService.generate() | 和支付相关 | 否,无调用关系 |
前 6 个全不对。第 7 个才是真正的调用方——因为 checkout 和 payment 的语义距离比 refundPayment 远。
SettlementJob.execute() 呢?它可能根本不在结果里——因为 "settlement" 和 "payment" 在向量空间里不够近。PaymentCallbackHandler.handleRetry() 可能排在第 12 位——但如果上下文窗口只取前 10 个片段,它就被截断了。
8 个结果里,1 个真正的调用方(排在第 7 位),0 个接口间接调用。
Embedding 真正擅长什么
Embedding 回答的不是"谁在调用它",而是"有没有类似的代码"。这在另一类场景下非常有用:
- 你问"项目里有没有处理超时重试的逻辑"——即使代码里没有"超时重试"四个字,Embedding 也能找到用
setTimeout+ 计数器实现的重试逻辑 retryWithBackoff和exponentialRetry名字不同但功能一样——Embedding 能关联它们- 你想找"和这段排序逻辑类似的代码"——Embedding 比 grep 好用得多
Embedding 的能力边界一句话:语义相近的代码,它能找到;有结构关系但语义不近的,它找不到。回答的是"有没有类似的",不是"改了这里还要改哪里"。
安全成本
Embedding 索引需要把代码片段上传到服务端计算向量。Cursor 的做法是明文不留存,但向量和混淆文件名长期存储。对个人开发者可能无所谓,但对有安全合规要求的团队,代码片段上传这件事本身就可能过不了安审。
方案三:调用图 — 精确、完整、但要先建索引
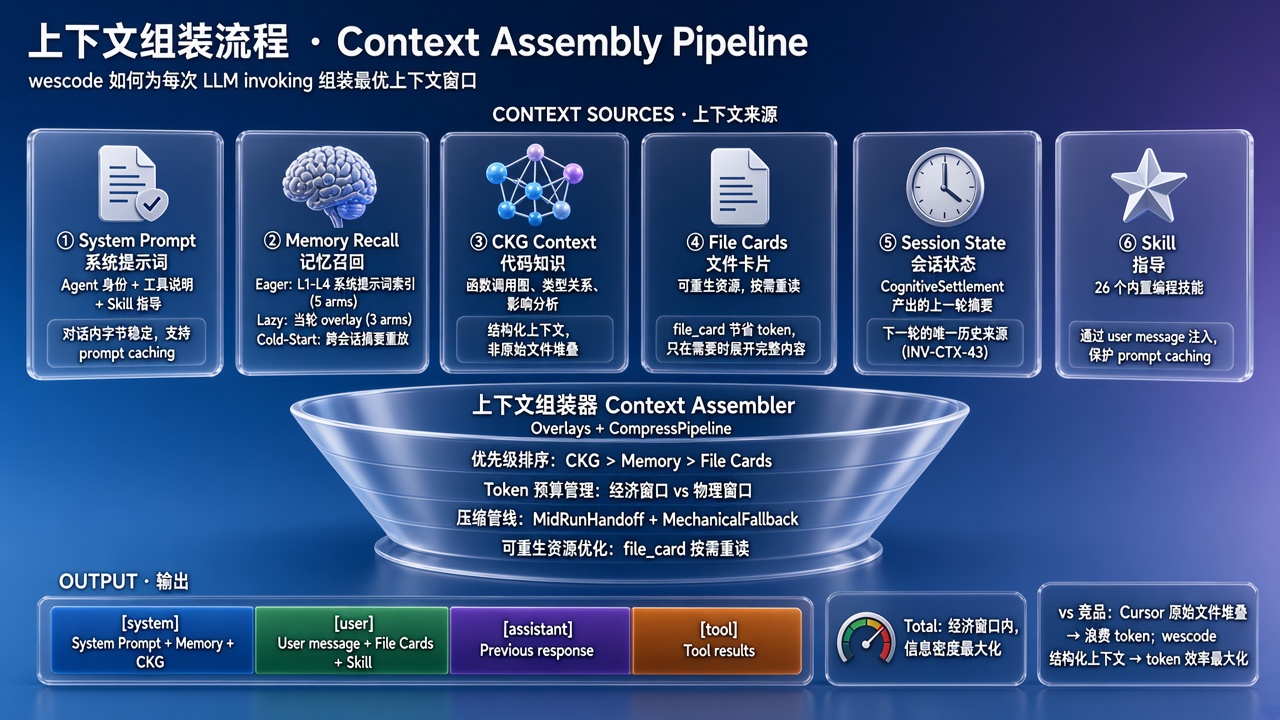
调用图不搜文本,也不算相似度。它通过语法解析直接提取代码的结构关系——谁调用了谁、谁实现了哪个接口、谁依赖了谁。
同一个任务,调用图返回什么
CKG 沿 CALLS 边反向遍历,直接返回:
| 调用方 | 关系类型 | 怎么找到的 |
|---|---|---|
OrderService.checkout() | CALLS | 函数体内有 this.gateway.processPayment() |
SettlementJob.execute() | CALLS + IMPLEMENTS | this.gateway 类型是 PaymentGateway → StripeGateway 实现了这个接口 → 追踪到 |
PaymentCallbackHandler.handleRetry() | CALLS + IMPLEMENTS | 同上,通过接口类型解析 |
AdminPanel.manualCharge() | CALLS + IMPLEMENTS | 通过 gatewayFactory.create() 的返回类型解析 |
4 个结果,4 个真正的调用方。零干扰。零遗漏。
关键区别:SettlementJob 和 PaymentCallbackHandler 能被找到,是因为 CKG 做了接口实现解析——它知道 this.gateway 的类型是 PaymentGateway,知道 StripeGateway 实现了 PaymentGateway(IMPLEMENTS 关系),所以 this.gateway.processPayment() 等价于调用 PaymentGateway.processPayment()。
这件事 grep 做不到(代码里没有 processPayment 这个字面量),Embedding 也做不到(语义距离和调用关系是两个维度)。只有语法级别的类型解析才能推导出来。
CKG 怎么建出这张图
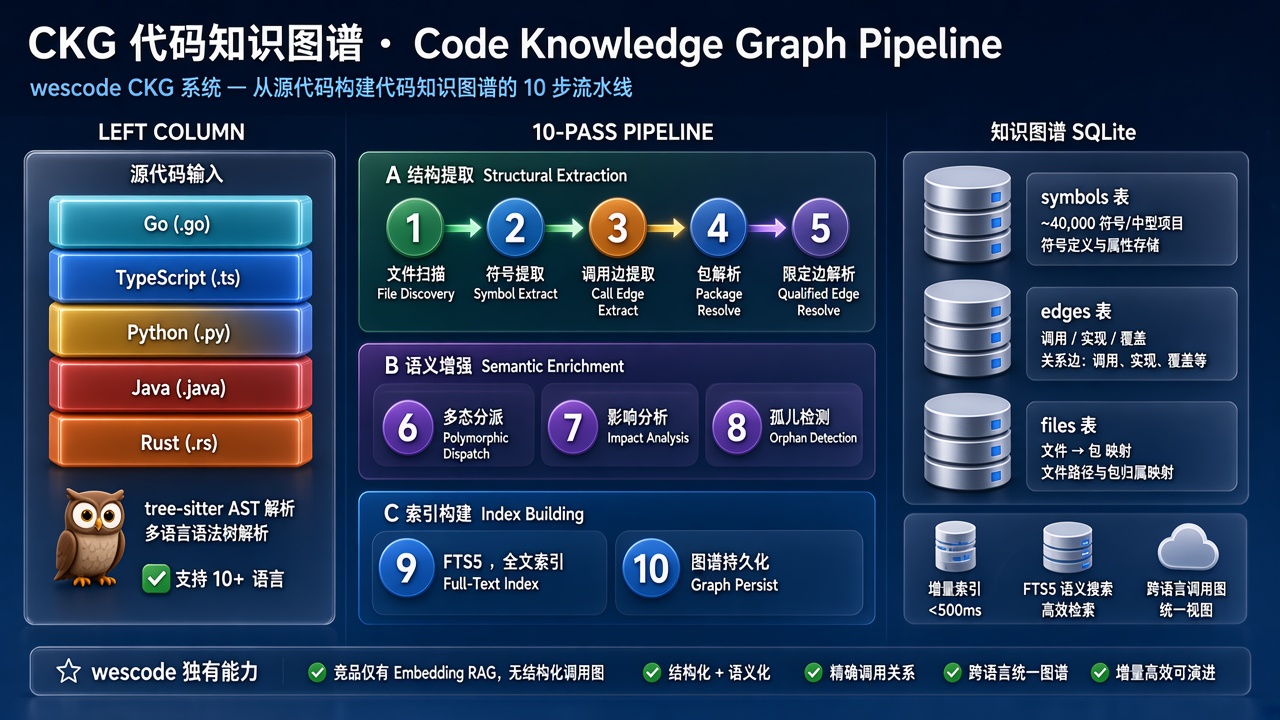
wescode 的 CKG(代码知识图谱)通过 10-Pass 深度索引管线 在本地构建完整的调用图:
| Pass | 做什么 | 产出 | 为什么重要 |
|---|---|---|---|
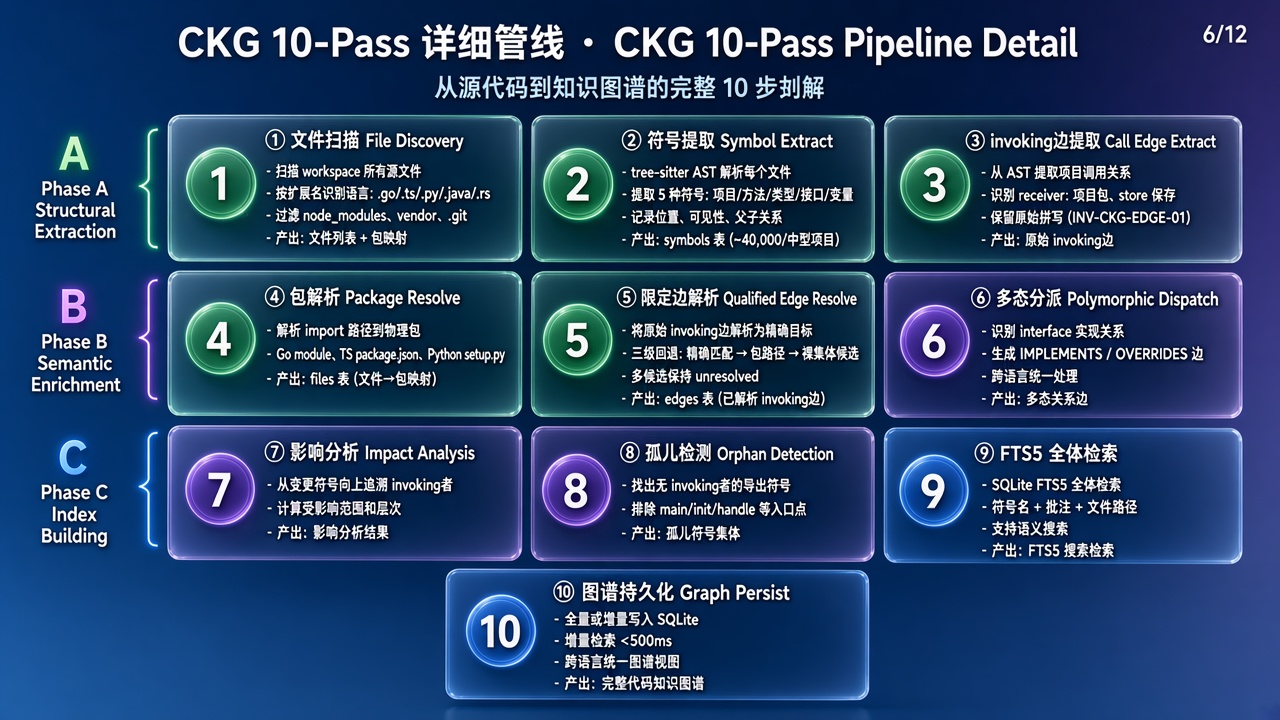
| 1-2 | 文件扫描 + 符号提取:用 tree-sitter 解析每个文件的 AST,提取函数、类、接口、变量定义 | 符号表:谁定义在哪个文件第几行 | 基础数据 |
| 3-4 | 调用关系解析:分析函数体内的调用语句 | CALLS 边:checkout() → processPayment() | grep 做得到的部分 |
| 5-6 | 接口实现解析:分析 implements / extends | IMPLEMENTS 边:StripeGateway 实现 PaymentGateway | grep 做不到的关键步骤 |
| 7-8 | 导入依赖 + 跨文件引用:分析 import 语句 | IMPORTS 边:包级别的依赖关系 | 跨模块追踪 |
| 9-10 | 覆写关系 + 优化:分析方法覆写、消除重复边、优化查询索引 | 完整的知识图谱 | 查询性能 |
六种关系的完整定义:
| 关系 | 含义 | 例子 | grep 能找到吗 | Embedding 能找到吗 |
|---|---|---|---|---|
| CALLS | A 调用 B | checkout() 调用 processPayment() | 直接调用可以 | 不确定 |
| IMPLEMENTS | A 实现接口 B | StripeGateway 实现 PaymentGateway | 不能 | 不能 |
| EMBEDS/EXTENDS | A 继承 B | PremiumOrder 继承 Order | 能 | 可能 |
| IMPORTS | 包 A 依赖包 B | order/ 导入 payment/ | 能 | 可能 |
| DEFINES | 文件 A 定义符号 B | gateway.ts 定义 processPayment | 能 | 可能 |
| OVERRIDES | A 覆盖父类方法 B | 子类 process() 覆盖父类 | 不能 | 不能 |
IMPLEMENTS 和 OVERRIDES 是 grep 和 Embedding 的共同盲区——而它们恰恰是大型 TypeScript / Java 项目里最密集的关系。接口抽象越多、依赖注入越重,盲区越大。
多层影响链
调用图不只找到直接调用方——它能追踪任意层数的影响链。你改了 processPayment 的返回类型:
层 1:OrderService.checkout()     — 直接使用返回值
层 2:OrderController.createOrder() — 使用 checkout() 的返回值
层 3:测试文件 order.e2e.test.ts   — 断言 createOrder 的返回结构
一次图遍历就能列出三层影响。grep 只能找到第一层(如果名字出现的话),Embedding 连第一层都不保证。
索引性能
所有索引在本地完成,存储在本地 SQLite。不上传任何代码到服务器。
| 项目规模 | 首次索引 | 增量更新(文件保存后) | 索引大小 | 内存占用 |
|---|---|---|---|---|
| 1 万行 | < 2 秒 | < 50ms | ~1MB | ~50MB |
| 10 万行 | 5-15 秒 | 100-200ms | ~10MB | ~100MB |
| 50 万行 | 30-60 秒 | 200-500ms | ~50MB | ~200MB |
| 100 万+ | 1-3 分钟 | 300-800ms | ~100MB | ~400MB |
增量更新是关键——你改了一个文件保存后,CKG 只重新解析这个文件及其直接依赖(通常 3-5 个文件),不需要全量重建。100-500ms 内完成,不影响编辑体验。
对比 Embedding 索引——需要把代码片段上传到服务端算向量,受 API 吞吐量和网络延迟限制。Cursor 官方博客承认大仓索引 "could take hours"(Secure Codebase Indexing)。CKG 是纯本地 CPU 计算,10 万行最多 15 秒。
调用图做不到什么
诚实说:
| 做不到 | 为什么 | 影响有多大 | 替代方案 |
|---|---|---|---|
动态派发(obj[methodName]()) | 运行时才能确定调用目标 | 低——大多数业务代码是静态调用 | grep 兜底 |
| 配置文件引用(YAML/JSON 里的字符串) | 不是代码,tree-sitter 不解析 | 中——cron job/配置中心常有 | grep 兜底 |
| 跨语言 FFI(TS 调 WebAssembly/C++) | 语言边界断开 | 低——大多数项目不跨 FFI | 手动确认 |
| 元编程/代码生成 | CKG 看源码不看生成物 | 看项目——重度使用 ORM 代码生成的要注意 | 看生成后的代码 |
| "有没有类似代码" | 调用图只知道谁调谁 | 这不是它的定位 | grep + AI 对话 |
静态类型语言(TypeScript、Java、C#)的覆盖率约 90-95%,动态语言(Python、JavaScript)约 85-90%(内部测试数据)。剩下的 5-15% 靠 grep 兜底。不完整但精确的结果,比完整但充满干扰的结果有用得多。
三种方式一张总表
| 能力 | grep | Embedding 向量检索 | CKG 调用图 |
|---|---|---|---|
| 原理 | 字符串匹配 | 语义向量距离 | 语法解析 + 图遍历 |
| 找字面出现的位置 | 最快 | 可能有 | 不直接做 |
| 找语义相似的代码 | 不能 | 最强 | 不能 |
| 找直接调用方 | 部分(名字出现时) | 不可靠 | 精确 |
| 找接口/抽象调用方 | 不能 | 不能 | 能 |
| 追踪多层影响链 | 不能 | 不能 | 能 |
| 发现孤儿函数(无人调用) | 不能 | 不能 | 能 |
| 需要联网 | 否 | 是(大部分工具) | 否(本地构建) |
| 需要构建索引 | 否 | 是(上传到服务端) | 是(本地构建) |
| 索引速度(10万行) | 即时 | 分钟到小时级 | 5-15 秒(内部测试数据) |
| 结果是否确定性 | 是 | 不是(同一个查询不同时间结果可能不同) | 是 |
| 数据安全 | 不涉及 | 代码片段上传服务端 | 代码不出设备 |
| 干扰项 | 注释/mock/字符串/旧代码 | 名字像但没关系的函数 | 无 |
| 回答的核心问题 | "哪里出现了这个字符串" | "有没有类似的代码" | "改了这里还要改哪里" |
三种方式不是竞争关系,是回答不同问题的不同工具。 grep 在配置文件搜索上不可替代。Embedding 在"找类似实现"上比 grep 强得多。但当你问的是"改了这里还要改哪里"——这是每次修改前最关键的问题——只有调用图能给你一个准确且完整的答案。
各工具用了哪种
| 工具 | grep | Embedding | 调用图 | "改了这里还影响哪里"怎么回答 |
|---|---|---|---|---|
| Cursor | 有 | 有(主力) | 无 | Embedding 找"语义相近"片段,让模型猜,不保证完整 |
| GitHub Copilot | 有 | 有 | 无 | Embedding + LSP 引用(同一编译单元内) |
| Claude Code | 有(主力) | 无 | 无 | 每次从头 grep + 逐文件 read,靠模型推理,慢但透明 |
| wescode | 有 | 无 | 有(CKG) | 图遍历,精确且完整,2 秒内出结果(内部测试数据) |
| 通义灵码 | 有 | 有 | 无 | Embedding + 阿里云服务端推理 |
| Trae | 有 | 有 | 无 | Embedding + 字节服务端推理 |
wescode 选了调用图(CKG),不做 Embedding。这是一个深思熟虑的取舍——
为什么不两个都做? 技术上可以,但两种结果混在一起展示时,用户更难分辨哪些是"真的有调用关系"、哪些是"名字像"。更重要的是:Embedding 索引需要上传代码片段到服务端算向量——这和 wescode "代码不出设备"的安全原则冲突。
放弃了什么? "找类似代码"的便利性。你问"项目里有没有类似的排序逻辑",CKG 回答不了——它只知道谁调用了谁,不知道谁和谁"像"。但 grep + AI 对话能覆盖大部分这类需求。
换来了什么? "找影响范围"的精确性。接口间接调用、多层影响链——这些是 Embedding 无论怎么优化都做不到的,因为语义距离和调用关系是两个正交的维度。一个函数名字叫 checkout 和它调用了 processPayment 之间没有语义关系——但它们之间有结构关系,而这个结构关系正是你改代码前必须知道的。
常见问题
Q:我项目不大(几千行),三种方式有区别吗?
小项目里 grep 就够了——几千行的项目 grep 返回的结果不多,手动排除干扰项也就几分钟的事。三种方式的差距在项目超过 5 万行时开始显现——grep 返回几十个结果需要半小时排、Embedding 开始给出似是而非的建议、而调用图仍然 2 秒给出精确答案。项目越大、接口抽象越多,差距越大。
Q:Embedding 的结果不确定性是什么意思?
Embedding 模型的输出是浮点向量,存在数值精度差异。同一段代码在不同时间算出的向量可能有微小差异(第 6 位小数),导致排序顺序偶尔变化——第 7 名和第 8 名可能互换。大多数情况下这不影响使用,但如果你两次搜同一个问题得到不同排序的结果——这是正常的,不是 bug。调用图的结果是确定性的——同一个查询永远返回同样的结果,因为图的结构是确定的。
Q:调用图对 Python 这种动态类型语言准确吗?
Python 的 duck typing(不声明类型、只要有同名方法就能调用)确实是调用图的盲区。但现代 Python 项目越来越多用 type hints(def process(gateway: PaymentGateway)),有类型注解时 CKG 的准确率和 TypeScript 一样高。没有类型注解时,覆盖率降到 80-85%——仍然比 Embedding 的"名字像就塞进来"准确得多。
Q:Cursor 以后会加调用图吗?
不知道他们的产品计划。技术上 Cursor 要加调用图面临一个架构选择:在云端为每个用户维护实时更新的调用图(工程复杂度和成本远高于存向量),或者重构为本地分析(改变现有的云端架构)。这是架构层面的决策,不是"加一个功能"那么简单。
本文对各工具的描述基于其 2026-09-20 的公开信息。如有更新,以各家最新页面为准。