「即使你用自己的 Key,请求也走我们后端」——这句话的含金量
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
很多人选 Cursor 是因为它支持「自带 API Key」,心想:我的 Key,我直连 OpenAI / Anthropic,代码应该不会经过第三方了吧?
不是的。Cursor 官方 Privacy FAQ 原文写着:
"Are requests always routed through the Cursor backend? Yes! Even if you use your API key, your requests will still go through our backend! That's where we do our final prompt building."
这不是我的解读,是他们自己写的——所有请求,包括你用自己 Key 的请求,都要经过 Cursor 的后端做 prompt 组装,然后再转发给模型供应商。
Cursor 后端到底做了什么
你以为的数据流:
你的编辑器 ──(你的 Key)──→ OpenAI / Anthropic
实际的数据流:
你的编辑器
  │ ① 代码文件分块上传
  ▼
Cursor 后端服务器
  ├─ ② 计算 Embedding 向量(text-embedding-ada-002)
  ├─ ③ 存储 Embedding + 混淆文件名到数据库
  ├─ ④ 根据你的问题做向量检索,找相关代码片段
  ├─ ⑤ 组装完整 prompt(系统指令 + 检索到的代码 + 你的问题)
  ▼
OpenAI / Anthropic API ──(你的 Key)──→ 模型响应
  │
  ▼
你的编辑器
中间发生了五件事,每一件都值得你知道:
① 代码分块上传。 开启索引后,你的文件被切成 200-500 行的片段发到 Cursor 服务器。
② 计算 Embedding。 每个片段被转成 1536 维向量。这需要调用 Embedding 模型,只能在服务端完成。
③ 向量持久化。 官方说明文代码不留存,但 Embedding 向量和混淆文件名长期存在数据库。
④ 向量检索。 你提问时,问题也被转成向量,在服务端数据库里做最近邻搜索。
⑤ Prompt 组装。 把检索到的代码片段、系统指令、你的问题拼成完整 prompt——这一步必须在后端完成,因为索引数据在那里。
这就是为什么即使你自带 Key,请求也要走他们后端——prompt 组装依赖服务端的索引数据,物理上绕不开。
Embedding 向量到底泄漏了多少信息
很多人说"Embedding 又不是源码,有什么关系"。精确分析一下 1536 维向量携带了什么:
| 能从 Embedding 推断的 | 不能推断的 | 安全含义 |
|---|---|---|
| 函数的大致功能(支付/鉴权/加密) | 具体的代码实现 | 竞争对手能知道你在做什么领域 |
| 代码涉及的数据类型(用户信息/交易/医疗) | 变量值和常量 | 能推断你处理什么敏感数据 |
| 函数之间的语义关系(哪些功能相近) | 精确的调用关系 | 能推断业务架构的大致形状 |
| 混淆后的文件名(路径结构) | 原始文件名(已混淆) | 能推断项目的目录组织 |
| 代码使用的框架和库 | 配置参数和密钥 | 能推断技术栈 |
结论:Embedding 不是源码复制件,但也不是无意义的随机数。它是代码的"语义指纹"——携带的信息足以推断你在做什么、用什么技术栈、处理什么类型的数据。对个人开发者和开源项目无所谓,但对竞争情报敏感的商业代码或涉密项目,这个信息量需要评估。
用代码验证 Embedding 的信息泄漏
你可以用 Python 简单验证——两段功能相似但写法不同的代码,Embedding 向量的余弦相似度非常高:
import openai
import numpy as np

client = openai.OpenAI()

# 两段功能相同但写法不同的代码
code_a = "def process_payment(order): charge = stripe.Charge.create(amount=order.total)"
code_b = "async function handlePayment(cart) { await paymentGateway.charge(cart.amount); }"

# 一段完全无关的代码
code_c = "func sortDescending(arr []int) { sort.Sort(sort.Reverse(sort.IntSlice(arr))) }"

resp = client.embeddings.create(model="text-embedding-ada-002", input=[code_a, code_b, code_c])
vecs = [np.array(r.embedding) for r in resp.data]

sim_ab = np.dot(vecs[0], vecs[1]) / (np.linalg.norm(vecs[0]) * np.linalg.norm(vecs[1]))
sim_ac = np.dot(vecs[0], vecs[2]) / (np.linalg.norm(vecs[0]) * np.linalg.norm(vecs[2]))

print(f"支付A vs 支付B 相似度: {sim_ab:.3f}")  # ~0.85+ → 功能语义泄漏
print(f"支付A vs 排序C 相似度: {sim_ac:.3f}")  # ~0.60  → 无关代码差异明显
这说明 Embedding 携带了代码的业务语义——即使变量名完全不同,"支付处理"的向量和"支付网关"的向量在语义空间里非常接近。
Privacy Mode 具体保护什么、不保护什么

Cursor 有 Privacy Mode。很多人以为开了就安全了。精确对照一下:
| 维度 | Privacy Mode OFF | Privacy Mode ON | 你的代码出设备了吗 |
|---|---|---|---|
| 代码用于模型训练 | 可能 | 不会 | — |
| 代码经过 Cursor 后端 | 是 | 是 | ✅ 出了 |
| Embedding 存在 Cursor 数据库 | 是 | 是 | ✅ 出了 |
| 明文代码在请求后留存 | 否(请求结束删除) | 否 | — |
| 风控触发时数据留存 | 可能 | 可能 | ✅ 出了 |
| 代码到达模型供应商 | 是 | 是 | ✅ 出了 |
关键行是第 2-3 行和第 5 行:
- 代码经过后端:Privacy Mode 不改变数据路径。代码在请求期间确实到了 Cursor 的服务器上。
- Embedding 持久化:Privacy Mode 不删除索引数据。
- 风控留存:官方原文——"if your prompts trigger abuse detectors your data may be stored for investigation"(Data Use)。
Privacy Mode 的保护是"不训练",不是"不离开设备"。这是两件完全不同的事。
怎么自己验证"请求是不是走了后端"
不用信任何人的说辞——抓包看一眼就知道了。
macOS / Linux:用 tcpdump 或 mitmproxy
# 方法 1:看 DNS 解析——你的编辑器在连谁
sudo tcpdump -i any -n port 53 2>/dev/null | grep -E "cursor|anthropic|openai"

# Cursor 会出现类似这样的请求:
# api2.cursor.sh  ← Cursor 后端
# 然后才有
# api.openai.com  ← 模型供应商

# 方法 2:用 mitmproxy 看完整请求
pip install mitmproxy
mitmproxy --mode regular --listen-port 8080
# 在系统网络设置里配代理 127.0.0.1:8080
# 打开 Cursor 发一条消息,看请求目标
用 TypeScript 写一个自动化验证脚本
如果你想程序化地验证数据路径,可以用 Node.js 的 dns 模块捕获编辑器的 DNS 查询:
import * as dns from 'dns';
import { promisify } from 'util';

const resolve = promisify(dns.resolve4);

// 你的 AI 编程工具在调用 LLM 时会解析这些域名
const suspectDomains = [
  'api2.cursor.sh',        // Cursor 后端
  'api.openai.com',        // OpenAI 直连
  'api.anthropic.com',     // Anthropic 直连
  'api.deepseek.com',      // DeepSeek 直连
];

async function checkDataPath() {
  for (const domain of suspectDomains) {
    try {
      const ips = await resolve(domain);
      console.log(`✅ ${domain} → ${ips.join(', ')}`);
    } catch {
      console.log(`❌ ${domain} → 未解析(你没有连接这个服务)`);
    }
  }
  // Cursor 用户会看到 api2.cursor.sh 和 api.openai.com 都有解析
  // wescode 用户只会看到 api.openai.com(或你选的供应商)
}

checkDataPath();
Windows:用 Fiddler 或 Wireshark
# Fiddler Classic(免费)
# 1. 下载安装 → 开启 HTTPS 解密
# 2. 过滤 Host 包含 "cursor" 或 "openai"
# 3. 在 Cursor 里发一条消息
# 4. 看请求链:先到 cursor 后端,再到模型供应商
你会看到:即使你在 Cursor 里填了自己的 OpenAI Key,第一跳仍然是 api2.cursor.sh(Cursor 后端),不是 api.openai.com。
用同样的方式测 wescode——你会看到请求直接到 api.openai.com 或 api.anthropic.com,中间没有任何第三方域名。
wescode 的安全五层架构
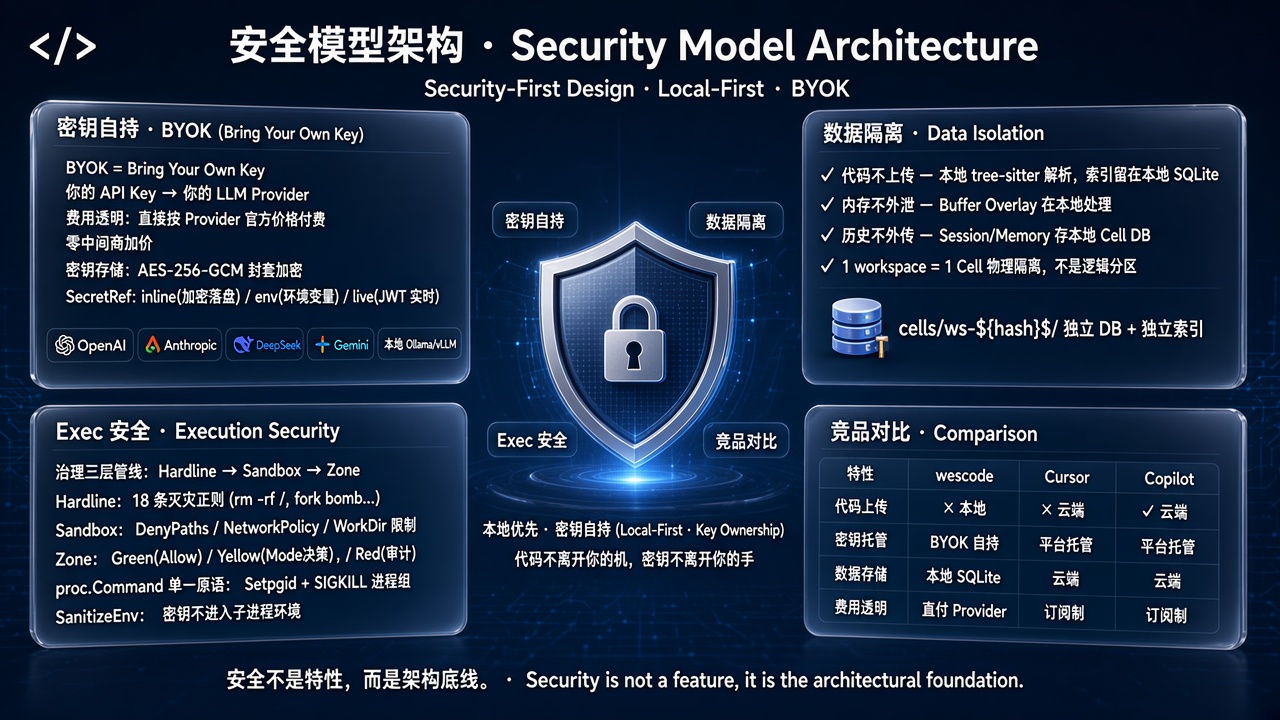
wescode 的架构从底层到顶层每一层都在本地完成,除了最后一步 LLM 调用:
| 层 | wescode 做什么 | Cursor 做什么 |
|---|---|---|
| ① 代码解析 | tree-sitter 本地解析 AST,提取符号、调用关系 | 本地分块,但分块后上传到后端 |
| ② 索引存储 | 本地 SQLite,CKG 知识图谱存在你的硬盘上 | Embedding 向量存在 Cursor 数据库 |
| ③ Prompt 组装 | 本地完成:CKG 查询 → 确定哪些代码放进 prompt → 拼装完整请求 | 后端完成:向量检索 → 拼装 → 转发 |
| ④ LLM 调用 | 你的 Key 直连模型供应商 API,不经过任何中间方 | 你的 Key 由 Cursor 后端代为转发 |
| ⑤ 本地模型 | Ollama / vLLM,全程断网,零出站流量 | 不支持本地模型 |
每一层都有对照——区别不是个别环节,是整体架构设计方向不同:Cursor 选了"云端索引 + 云端组装",wescode 选了"本地索引 + 本地组装"。
Before / After:有没有本地索引的区别
| 维度 | 没有本地索引(Cursor 模式) | 有本地索引(wescode 模式) |
|---|---|---|
| 代码分析耗时 | 上传等待 + 服务端计算,大仓可能数小时 | 本地并行,万行级项目 2-5 分钟(内部测试数据) |
| 离线可用 | 索引在云端,断网无法查询 | 索引在本地 SQLite,可离线查询 |
| prompt 精确度 | Embedding 做语义近似匹配 | CKG 做精确的调用链追踪 |
| 代码出设备 | 代码片段发到服务端 | 只有最终 prompt 发出 |
| 响应速度 | 取决于网络延迟 + 服务端负载 | 本地查询 < 50ms(内部测试数据) |
合规审计路径对照
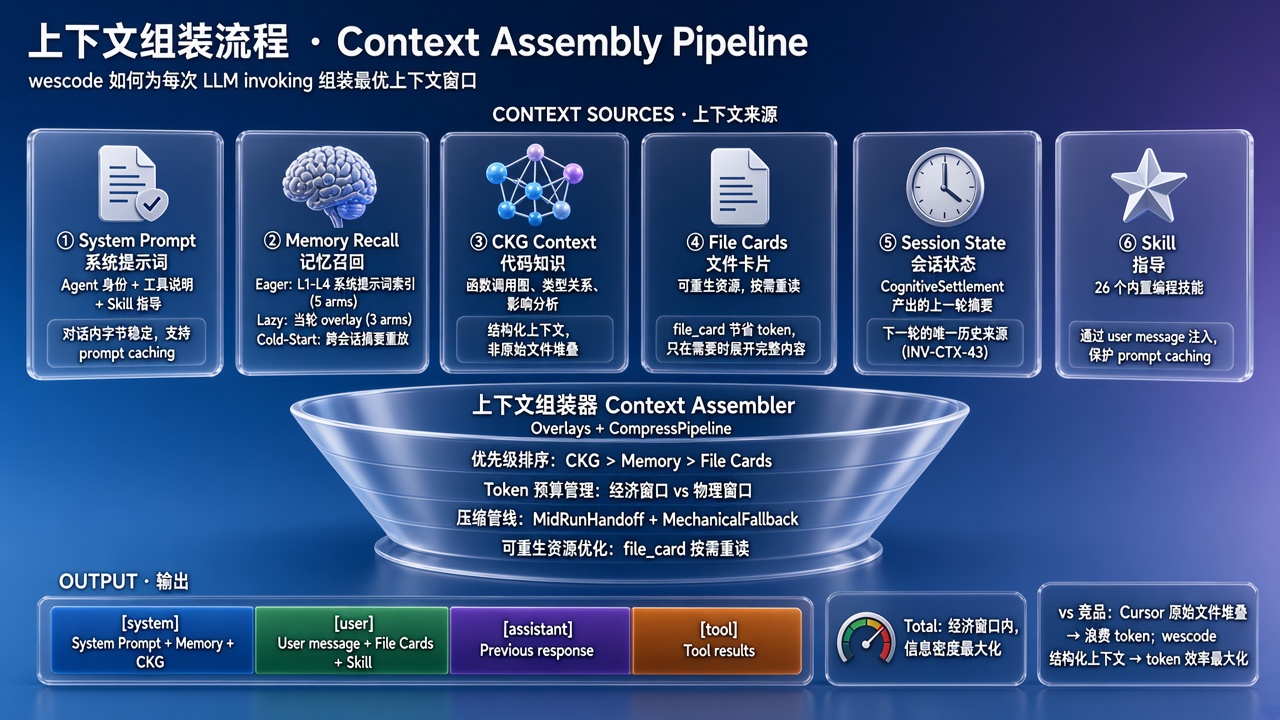
如果你的公司做安全审计,审计员会问这些问题。两种架构的回答:
| 审计问题 | Cursor 的回答 | wescode 的回答 |
|---|---|---|
| 代码是否离开受控环境? | 是(经过 Cursor 后端) | 否(本地解析+组装) |
| 代码被传输到了哪些服务器? | Cursor 后端 + 模型供应商 | 仅模型供应商(直连) |
| 是否有第三方持久化存储代码相关数据? | 是(Embedding 向量在 Cursor 数据库) | 否(索引在本地 SQLite) |
| 断网后能否继续工作? | 不能 | 索引/导航/影响分析可用(LLM 调用仍需联网,除非使用本地模型) |
| 是否支持完全离线模式? | 不支持 | 支持(Ollama / vLLM,但本地模型推理质量低于商业大模型) |
| 数据流中有多少个第三方节点? | 2(Cursor + 模型供应商) | 1(仅模型供应商) |
| 能否审计发出的完整请求内容? | 不能(Cursor 后端包了一层) | 能(请求从你电脑直发,可抓包) |
金融和政企安审关心的不是"你承诺不存"——他们关心的是"代码有没有物理上到过不受控的环境"。 答案是"有"就可能过不了,不管中间方的安全承诺多好。
用 Java 写企业级安全审计检查
对于需要安审的企业项目,可以用以下代码自动检查开发工具的网络行为:
import java.net.InetAddress;
import java.util.List;
import java.util.Map;

public class DevToolSecurityAudit {

    // 已知的 AI 编程工具后端域名
    private static final Map<String, String> KNOWN_BACKENDS = Map.of(
        "api2.cursor.sh",    "Cursor 后端(代码经此中转)",
        "api.cursor.sh",     "Cursor 后端(旧域名)",
        "copilot-proxy.githubusercontent.com", "GitHub Copilot 后端"
    );

    // 允许的直连域名(模型供应商 API)
    private static final List<String> ALLOWED_DIRECT = List.of(
        "api.openai.com",
        "api.anthropic.com",
        "api.deepseek.com"
    );

    public static void auditDevToolNetwork() {
        System.out.println("=== 开发工具网络安全审计 ===\n");
        for (var entry : KNOWN_BACKENDS.entrySet()) {
            try {
                InetAddress.getByName(entry.getKey());
                System.out.printf("⚠️  检测到 %s 可达 → %s%n", entry.getKey(), entry.getValue());
                System.out.println("   审计建议:评估代码是否经过此中间节点");
            } catch (Exception e) {
                System.out.printf("✅ %s 不可达 → 未使用此后端%n", entry.getKey());
            }
        }
    }
}
对"代码经过后端"的安全影响分级
不同场景对这件事的敏感度完全不同。诚实地分级:
| 场景 | 风险等级 | Cursor 够用吗 | 推荐方案 |
|---|---|---|---|
| 个人开发者 / 开源项目 | 低 | ✅ Privacy Mode 足够 | Cursor 或 wescode 都行 |
| 普通企业内部工具 | 中 | ⚠️ 需要评估安审 | wescode BYOK 直连更保险 |
| 金融机构 / 交易系统 | 高 | 不够,代码出设备过不了安审 | wescode + 本地模型 |
| 政企 / 涉密项目 | 极高 | 不够,硬性禁止 | wescode + Ollama/vLLM 零出站 |
| 医疗 / 患者数据相关 | 高 | 不够,合规要求数据不出境 | wescode + 国内供应商直连 |
低风险场景:个人项目、开源代码。Cursor 的 Privacy Mode 完全够用——不持久化、不训练,对个人来说已经是合理的安全承诺。选择更多取决于功能和价格。
中风险场景:企业内部代码。很多公司的安审流程会问"代码是否经过第三方服务器"——不管 Cursor 承诺多好,答案是"是"就可能过不了。这不是技术问题,是流程问题。
高风险场景:金融核心系统、医疗数据。这类场景需要的是代码在物理上不出设备,不是"我们承诺不存"。只有本地方案能满足。
其他国内 AI 编程工具
同样的问题看一下国内几款主流工具:
通义灵码——阿里云插件,所有请求走阿里云服务端。代码上下文经阿里服务端处理后调用通义模型。不支持自带 Key,不支持离线。
字节 Trae——独立 IDE,内置 Claude 和 GPT 模型,请求走字节后端。完全免费(补贴期)。代码上下文发送到字节服务端。
CodeGeeX——智谱出品。标准使用走云端,但支持私有部署——如果你有 GPU 资源,可以完全不联网。是这批工具里唯一的本地方案。
三者的数据流对比:
| 维度 | 通义灵码 | Trae | CodeGeeX |
|---|---|---|---|
| 代码发往哪 | 阿里云服务端 | 字节后端 | 智谱云 / 可私有部署 |
| 数据在国内吗 | ✅ | ✅ | ✅ |
| 自带 Key | 不支持 | 不支持 | 不支持 |
| 零出站部署 | 不支持 | 不支持 | 支持(私有部署) |
| 隐私声明透明度 | 中(有使用协议) | 低(无独立隐私页) | 中 |
共同优势:数据在国内服务器,对国内企业的数据出境合规友好——如果你的公司要求代码不出境(但可以在国内云上),国产工具比 Cursor 更合适。 共同局限:如果要求代码不出设备,那只有本地方案。
"BYOK"在不同工具里的含义完全不同
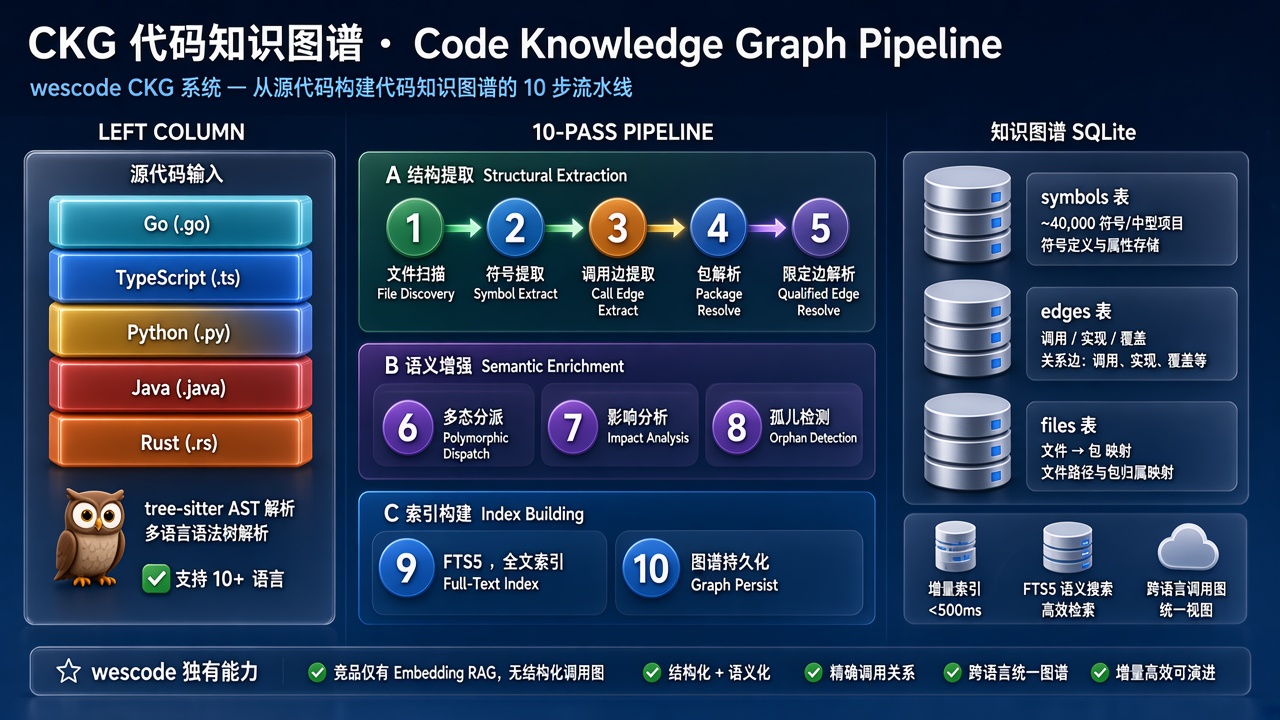
"自带 Key"这四个字在不同工具里差距非常大。精确对照:
| 维度 | Cursor "自带 Key" | Claude Code BYOK | wescode BYOK |
|---|---|---|---|
| 你自带 API Key | 支持 | 支持 | 支持 |
| 请求经过他们后端 | 是(官方确认) | 否 | 否 |
| 代码索引在哪 | 他们的数据库(Embedding) | 不做索引 | 你的硬盘(SQLite) |
| prompt 组装在哪 | 他们的服务器 | 你的终端 | 你的编辑器 |
| 支持的模型 | 预设清单内 | 仅 Anthropic 系列 | 任何 OpenAI 兼容 API |
| 接本地模型 | 不支持 | 不支持 | 支持(Ollama / vLLM,推理质量低于商业大模型) |
| 离线可用 | 不支持 | 不支持 | 支持(LLM 调用除外) |
| 审计可查 | 不能看 Cursor 后端做了什么 | 能看发出的请求 | 能看发出的请求 |
三种"BYOK",只有后两种真正做到了"你的 Key 直连供应商"。 Cursor 的 BYOK 更准确地说是"你的 Key,由我代为使用"。
常见问题
Q:Cursor 开了 Privacy Mode 就安全了吧? A:Privacy Mode 保证「不用于训练」。但代码仍然经过 Cursor 后端(他们自己说的),Embedding 仍存在他们数据库,风控触发时仍可能留存。「不训练」≠「不离开设备」。见上方对照表。
Q:wescode 调 LLM 的时候代码不也发出去了吗? A:是的。LLM 调用必须联网,prompt 里会包含代码上下文。但它直连模型供应商,不经过 wescode 的任何中间服务器。区别在于中间多不多一跳——抓包验证方法见上文。
Q:如果我完全不想代码出去呢? A:用本地模型(Ollama / vLLM)。wescode 支持接入本地部署的模型——索引本地做,LLM 也本地跑,全程断网可用。这是唯一真正意义上的"零出站"方案。代价是本地模型的推理质量和商业大模型有差距。
Q:Embedding 向量能反推出原始代码吗? A:直接反推很难——1536 维向量到源码不是可逆映射。但 Embedding 携带了代码的语义信息——函数做什么、处理什么数据、和哪些概念相关。对大部分场景够安全,但对"不允许任何代码语义信息离开受控环境"的极端要求(比如涉密项目),这是需要评估的风险。
Q:你说的这些都有出处吗? A:本文引用的 Cursor 信息全部来自他们的官方页面:Privacy FAQ、Secure Codebase Indexing、Data Use & Privacy。你可以自己去核实每一条。
Q:企业做安审时,应该重点关注哪些数据路径问题? A:三个关键问题——①代码是否到过非受控服务器(包括请求期间的临时传输);②是否有代码相关数据被持久化存储在第三方(包括 Embedding);③是否能审计完整的出站请求内容。Cursor 在三个问题上的答案分别是"是、是、不完全能",wescode 的答案是"否(仅直连供应商)、否(本地 SQLite)、能(请求从本地直发)"。
本文所有 Cursor 相关信息均引自其官方公开文档,引用日期 2026-09-20。如 Cursor 后续更新了隐私政策,请以其最新官方页面为准。