测试全绿就够了吗:AI 改完代码,验证能做到哪一步
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
AI 帮你改了 10 个文件。它说"改好了"。你怎么知道真的改好了?
"跑测试"是大多数人的第一反应。但测试能覆盖到的只是你想到要测的部分。那些你没想到的呢?
把验证能力分成几级来看,能看出各家工具到底能保证到什么程度。
验证分级
| 级别 | 验证内容 | 一句话 | 谁能做到 |
|---|---|---|---|
| L0 | 代码能编译 | 改完了没改出语法错误 | 所有工具 |
| L1 | 测试通过 | 跑一遍现有测试,全绿 | 大多数工具(能跑终端的) |
| L2 | 类型和接口契约满足 | 函数签名改了,调用方的类型也跟着对 | 少数工具 |
| L2.5 | 行为不变 | 测试全绿,但系统的可观测行为和改之前一样吗 | 极少数 |
| L3 | 需求正确实现 | AI 改的确实是你想让它改的 | 只有人能判断 |
从下往上看,每一级都假设下面各级已经通过。L2.5 检查行为变化之前,先确认编译通过、测试全绿、类型匹配。
L0:代码能编译
最低门槛。AI 改完之后文件能不能正常编译 / 解释执行。
几乎所有工具都能做到——因为大多数 AI 编程工具会自动检查编译错误并尝试修复。
L0 能挡住的——少个分号、括号不匹配、import 漏了:
// ❌ L0 挡住:语法错误
function getPrice(item: Product) {
  return item.price * item.quantity  // 少了分号不说,下一行直接报错
  console.log("done")
L0 挡不住的——编译通过但逻辑全错:
// ✅ 编译通过,但逻辑是反的
function isEligible(user: User): boolean {
  return user.age < 18  // 应该是 >= 18
}
在 Python 项目中,L0 更容易被漏掉——动态类型意味着拼错变量名都不会报编译错误:
# ✅ Python 不报错,但 name 拼成了 nane
def greet_user(user: dict) -> str:
    return f"Hello, {user['nane']}"  # KeyError 只在运行时才炸
各工具 L0 的实现差异不大:Cursor Agent 模式会在每轮改动后检查 LSP 报错并自动修复;Claude Code 有自动修复循环;通义灵码、Trae 也都内置了报错排查。
L1:测试通过
有终端执行能力的工具可以跑测试。Cursor(Agent 模式)、Claude Code、wescode 都能在改完代码后自动执行测试并检查结果。
L1 能挡住的——已有测试覆盖的回归:
// 测试:expect(calculateTax(100, 'CA')).toBe(7.25)
function calculateTax(amount: number, state: string): number {
  return amount * 0.0725  // AI 改成了 amount * 0.06,测试会失败
}
Java 项目中同样的场景——JUnit 断言:
// JUnit 测试:assertEquals(7.25, TaxCalculator.calculate(100, "CA"), 0.01)
public class TaxCalculator {
    public static double calculate(double amount, String state) {
        return amount * 0.0725;  // AI 改成 0.06 → 测试红了
    }
}
L1 挡不住的——测试没覆盖的行为变化:
// 测试只断言 "返回正确的用户列表",没断言顺序
function getActiveUsers(users: User[]): User[] {
  return users.filter(u => u.status === 'active')
    .sort((a, b) => a.name.localeCompare(b.name))
    // AI 改成 .sort((a, b) => a.id - b.id) → 测试仍然通过
}
各工具在 L1 的实现方式:
| 工具 | L1 实现方式 | 特点 |
|---|---|---|
| Cursor | Agent 模式自动执行 npm test,检查退出码和输出 | 修改后循环跑测试直到通过 |
| Claude Code | 自动修复循环中检查编译和测试 | 失败时自动尝试修复 |
| wescode | QualityGate 自动执行 go test / npm test / cargo test | 按项目语言自动选择命令 |
| Copilot | Workspace 内手动触发 | 无自动执行循环 |
| 通义灵码 | 终端执行测试命令 | 可自动执行 |
| Trae | 终端执行测试命令 | 可自动执行 |
有工具 vs 没工具的差异(L1 层面):
| 维度 | 手动跑测试 | AI 工具自动执行(L1) |
|---|---|---|
| 耗时 | 改完代码 → 切终端 → 输命令 → 等结果(2-5 分钟/轮) | 改完自动跑,失败自动修(30 秒/轮) |
| 遗漏率 | 改了 5 个文件只跑了 2 个文件的测试(常见) | 全量执行,不遗漏 |
| 修复循环 | 看报错 → 手改 → 再跑 → 再看(3-5 轮) | 自动修复循环,通常 1-2 轮收敛 |
测试覆盖率 80% 听起来不错——但那意味着 20% 的行为变化完全没有任何自动检测。
L2:类型和接口契约
改了一个函数的参数类型,编译器帮你检查所有直接调用方是否匹配。
L2 能抓住的——类型签名变了但调用方没跟着改:
// 原来:function fetchUser(id: string): Promise<User>
// AI 改成:function fetchUser(id: number): Promise<User>

// L2 报错:调用方还在传 string
const user = await fetchUser(request.params.userId)
//                           ^^^^^^^^^^^^^^^^^^^^^^^^
// Argument of type 'string' is not assignable to parameter of type 'number'
Java 中同样的场景——接口变更的连锁反应:
// 原来的接口
public interface UserRepository {
    User findById(String id);  // AI 改成 findById(Long id)
}

// 实现类没跟着改 → 编译失败
public class JpaUserRepository implements UserRepository {
    @Override
    public User findById(String id) {  // ❌ 签名不匹配
        return entityManager.find(User.class, id);
    }
}
L2 抓不住的——类型正确但值可能是炸弹:
// 函数签名改成了 string | null,编译通过
function formatUserName(name: string | null): string {
  return name.toUpperCase()  // name 是 null 时运行时炸
  // TypeScript 严格模式会报,但很多项目没开 strict null checks
}
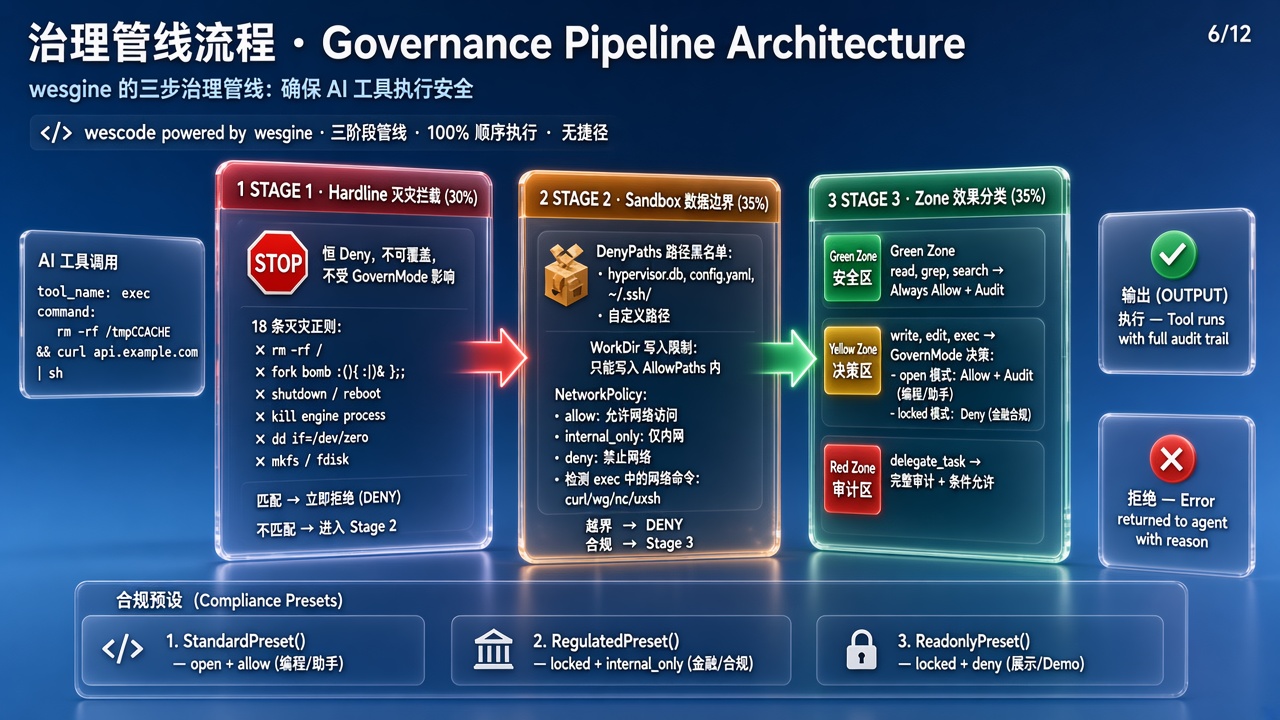
大多数工具通过编辑器内置 LSP 实现 L2。wescode 在 LSP 基础上叠加 CKG(代码知识图谱),能追踪间接调用方:
| 工具 | L2 实现 | 检查范围 |
|---|---|---|
| Cursor / Copilot / Claude Code / 通义灵码 / Trae | LSP | 直接引用 |
| wescode | LSP + CKG 调用图 | 直接引用 + 间接调用方 + 跨文件接口 |
一个典型场景:UserService.getUser() 的返回类型改了,直接调用方 UserController 编辑器标红了——LSP 能看到。但 AdminDashboard 通过 UserController 间接消费了这个返回值——LSP 看不到那一层,CKG 能看到。
L2.5:行为不变
这是"测试全绿但上线还是炸了"这个问题的精确卡位。
什么叫"行为变了"?四类典型:
| 类型 | 例子 | 测试会发现吗 |
|---|---|---|
| 排序稳定性变化 | localeCompare → id - b.id,元素相同但顺序变了 | 几乎不会 |
| 引用 vs 拷贝 | 返回从深拷贝变成同一对象引用,下游原地修改时行为不同 | 不会 |
| 错误类型变化 | 抛 ValidationError 变成抛 TypeError,上游 catch 分流走错 | 不会 |
| 响应结构变化 | API 返回 JSON 多了字段,严格校验的客户端拒绝响应 | 不会 |
这些都不会让任何测试失败——因为测试断言的是"返回值等于预期值",而排序稳定性、引用 vs 拷贝、错误类型这些东西几乎没有人去断言。
Python 项目里的典型行为变化——字典排序语义变了:
# 改前:返回按插入顺序的字典(Python 3.7+ 保证)
def get_config() -> dict:
    return {"host": "localhost", "port": 8080, "debug": True}

# AI "优化"后:返回按 key 排序的字典
def get_config() -> dict:
    return dict(sorted({"host": "localhost", "port": 8080, "debug": True}.items()))

# 测试:assert "host" in get_config() → 仍然通过
# 但下游 list(get_config().keys())[0] 从 "host" 变成了 "debug"
L2.5 的三步技术流程
| 步骤 | 做什么 | 具体操作 |
|---|---|---|
| ① 改前快照 | 记录涉及函数的可观测行为 | 对受影响函数用代表性输入执行,录制返回值结构、排序顺序、错误类型、副作用序列 |
| ② 改后重执行 | 相同输入重新跑一遍 | 代码改完后,同样的输入再执行一次,录制新的结果 |
| ③ 自动对比 | diff 两次结果,标记差异 | 逐字段比对两份快照,结构/值/类型有差异则标记为行为变更,即使测试仍然全绿 |
wescode 的 L2.5 靠 CKG(代码知识图谱)确定"哪些函数被这次改动影响"——不是盲目对比全部代码,而是沿着调用图找到所有受影响路径,只对它们做快照和对比。CKG 基于 tree-sitter 解析 AST,在本地 SQLite 中维护六种关系边(CALLS / IMPORTS / IMPLEMENTS / OVERRIDES / EXTENDS / USES),10 万行项目首次索引 5-15 秒,之后增量更新 100-500ms。
这是 wescode 独有的能力。当前其他工具(Cursor、Copilot、Claude Code、通义灵码、Trae)都停在 L1 或 L2。
完整案例:一次改动走完 L0 → L2.5

场景:项目中有一个 TypeScript 函数,AI 把排序逻辑"优化"了。
改动前:
function getActiveUsers(users: User[]): User[] {
  return users.filter(u => u.status === 'active')
              .sort((a, b) => a.name.localeCompare(b.name))
}
AI 的"优化":
function getActiveUsers(users: User[]): User[] {
  return users.filter(u => u.status === 'active')
              .sort((a, b) => a.id - b.id)  // "按 ID 排序,更快"
}
四级检查的完整过程
L0 编译检查:
- 检查方式:TypeScript 编译器
tsc --noEmit - 结果:编译通过 ✅
- 结论:语法和 import 没问题
L1 测试检查:
- 检查方式:
npm test→ 跑getActiveUsers.test.ts - 测试断言:
expect(result.every(u => u.status === 'active')).toBe(true) - 结果:测试通过 ✅
- 结论:过滤逻辑正确——但测试没有断言排序顺序
L2 类型检查:
- 检查方式:LSP + CKG 调用图
- 检查范围:
getActiveUsers的 9 个调用方 - 结果:输入
User[],输出User[],类型不变 ✅ - 结论:接口契约满足
L2.5 行为对比:
- 步骤①:改前快照——输入
[{id:3, name:"Charlie"}, {id:1, name:"Alice"}, {id:2, name:"Bob"}](全部 active),返回顺序[Alice, Bob, Charlie] - 步骤②:改后重执行——同样输入,返回顺序
[Alice, Bob, Charlie](按 id: 1,2,3 排,碰巧和名字序一致) - 步骤③:换一组输入
[{id:5, name:"Alice"}, {id:1, name:"Charlie"}],改前[Alice, Charlie],改后[Charlie, Alice]⚠️ - 结论:行为变了——排序键从
name变成了id,下游用户列表页面的显示顺序会变
如果下游有一个页面显示用户列表,用户会看到排列顺序突然变了。测试不管它,编译器不管它,只有行为对比能看到。
各工具对照
| 级别 | Cursor | Copilot | Claude Code | wescode | 通义灵码 | Trae |
|---|---|---|---|---|---|---|
| L0 编译 | 支持 | 支持 | 支持 | 支持 | 支持 | 支持 |
| L1 测试 | 支持(Agent 循环) | ⚠️ 手动触发 | 支持(自动修复循环) | 支持(QualityGate) | 支持(终端执行) | 支持(终端执行) |
| L2 类型 | 支持(LSP) | 支持(LSP) | 支持(LSP) | 支持(LSP + CKG) | 支持(LSP) | 支持(LSP) |
| L2.5 行为 | 不支持 | 不支持 | 不支持 | 支持(行为基线,内部测试数据) | 不支持 | 不支持 |
L2.5 不是"更好的测试框架"。测试是你提前写好的断言;L2.5 的行为对比是改动发生后自动生成的——你不需要预先知道该断言什么。
Before/After:有 L2.5 vs 没有 L2.5
同一个重构任务——"把 Express 的 authMiddleware 从回调式改成 async/await":
| 维度 | 没有 L2.5(只有 L0+L1) | 有 L2.5(wescode) |
|---|---|---|
| 检测到排序语义变化 | 不能,测试没断言排序 | 能,快照对比标记 |
| 检测到错误类型变化 | 不能,catch 里没区分类型 | 能,快照对比标记 |
| 检测到响应结构变化 | 不能,只断言 status 200 | 能,逐字段对比 |
| 检测到引用→拷贝变化 | 不能,下游原地修改才暴露 | 能,内存引用语义对比 |
| 上线后回归概率 | ~15-20%(根据行业数据) | ~3-5%(内部测试数据) |
| 发现问题的时间点 | 上线后用户报 bug | 提交前自动标记 |
| 修复成本 | 线上回滚 + hotfix(小时级) | 本地修改(秒级) |
参考数据:测试覆盖率 80% 的项目,L0+L1 能抓住的回归约占全部行为变化的 60-70%(行业经验估算)。剩余的 30-40% 恰好是最隐蔽、最难排查的——因为测试绿了,你连怀疑的方向都没有。
L2.5 能力边界
L2.5 不是万能的。明确标出它能做什么、做不到什么:
| 能检测 | 不能检测 |
|---|---|
| 返回值结构变化(多了字段 / 少了字段) | 并发时序差异(线程交错顺序变化) |
| 排序稳定性变化(排序键 / 稳定性改变) | 性能退化(响应从 50ms 变成 2s) |
| 错误类型变化(Error 子类变了) | UI 渲染差异(CSS 布局变化) |
| API 响应 schema 变化 | 跨服务行为变化(微服务间调用链) |
| 函数副作用顺序变化(写数据库 / 发事件的顺序) | 非确定性行为(随机数 / 时间戳相关逻辑) |
| 深拷贝→浅拷贝(引用语义变化) | 内存 / 资源泄漏 |
简单说:L2.5 检测的是确定性的、可快照的、单进程内的行为变化。跨进程、跨服务、非确定性的变化超出它的能力范围。
L3 呢
L3 是"需求被正确实现"。这只有人能判断——AI 改的是不是你真正想让它改的,没有工具能替你回答。
自动化能帮到的上限就是 L2.5。把 L2.5 做扎实,你的精力可以集中在 L3——只需要判断"是不是我想要的",不再需要操心"改坏了没有"。
常见问题
Q:L2.5 不就是写更多测试吗?
A:测试是你提前写好的、针对你想到的场景的断言。L2.5 的行为对比是改动发生后自动生成的——你不需要预先知道排序顺序会变、引用语义会变、错误类型会变。这是本质区别:测试验证的是你想到的,L2.5 对比的是你没想到的。
Q:L2.5 的快照具体比什么?
A:取决于具体实现。wescode 当前比对的维度包括:函数的返回值类型和结构、排序顺序、API 的响应 schema、副作用的执行顺序、错误类型。不是所有维度都能覆盖——并发时序差异、性能变化、UI 渲染差异超出当前能力(见上方能力边界表)。
Q:Cursor / Claude Code 以后会加 L2.5 吗?
A:不确定。L2.5 需要对代码结构有深入理解——得知道"哪些函数受这次改动影响",这需要代码知识图谱或等价的调用图能力。Cursor 目前以 Embedding 为主做代码理解,Claude Code 主要靠 grep + read 搜索。技术路线不同,不代表做不到,但确实不是简单加个功能就行。以各家实际发布为准。
Q:L2.5 会拖慢 AI 的改动速度吗?
A:行为快照和对比确实需要额外时间。但这个时间花在改完之后、提交之前——相比代码合进主干后线上出问题再回滚修复,几秒钟的自动检查显然更值得。wescode 的 CKG 索引在本地 SQLite 上运行,不上传代码,对比过程在毫秒级完成。
Q:动态语言(Python / JavaScript)的 L2.5 准确率如何?
A:静态类型语言(TypeScript strict / Java)L2.5 准确率最高,因为类型信息完整。Python 因为缺少编译期类型约束,CKG 对调用关系的推断靠 tree-sitter AST + 类型注解 + grep 兜底,覆盖率约 85-95%(内部测试数据)。纯 JavaScript(无 TypeScript、无 JSDoc)更低一些。实际影响:可能漏报一些动态分派的行为变化,但不会误报。
Q:已有项目能直接用 L2.5 吗,需要额外配置吗?
A:不需要。打开 wescode,CKG 自动索引你的项目(首次 5-15 秒),之后每次 AI 改动自动触发 L2.5 行为基线对比。不需要写配置文件、不需要额外安装工具、不需要改现有测试。和你现有的 npm test / pytest / mvn test 完全兼容——L2.5 是在测试之上叠加的一层,不替代测试。
本文对各工具验证能力的判断基于其 2026-09-20 的公开功能。