Agent 模式的三条技术路线,各自的天花板
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
你让 AI 把一个 Express REST API 迁移到 Fastify。它改了路由定义,跑起来了。你以为完成了。
三天后线上报了一个诡异的 bug:authMiddleware 还是 Express 的,挂在一个 Fastify 路由上——不报错,但 req.user 永远是 undefined。AI 改了最显眼的 10 个文件,漏了第 11 个。它不知道那个中间件存在,因为没有任何东西告诉它 authMiddleware 和 userRoutes 之间有调用关系。
这不是模型不够聪明。这是架构决定的天花板。
2026 年的 AI 编程 Agent 实现,按架构可以归为三条路线。我们用同一个任务——把 Express API 迁移到 Fastify(约 8000 行,12 个路由文件,6 个中间件,40+ 个测试)——展示各自怎么做、做到哪就做不动了。
路线一:提示词路由
根据意图选模板、调模型、执行工具、返回结果。每一步相对独立,步骤间上下文断裂。
// 路线一:提示词路由的核心循环
async function promptRouting(task: string) {
  const intent = classifyIntent(task)            // "迁移框架"
  const template = selectPrompt(intent)          // 选预设模板
  const context = gatherCurrentFile()            // 只有当前打开的文件

  const plan = await llm.generate(template, context)

  for (const step of plan.steps) {
    const result = await executeTool(step)        // 每步独立调用
    // ⚠️ 步骤 2 不知道步骤 1 改了什么
    // ⚠️ 上下文 = 模板 + 工具返回值,没有全局视图
    if (result.error) {
      return { error: result.error }              // 报错就停,无恢复机制
    }
  }

  return plan.summary
  // Run 结束:无认知产物,下次从零开始
}
Express→Fastify 实际执行:
Agent 收到"迁移 Express 到 Fastify"的指令,匹配到"框架迁移"模板。模板告诉它:找到入口文件、修改路由定义、更新依赖。它打开 app.ts,改了路由注册方式;接着打开 routes/users.ts、routes/orders.ts,改了处理函数签名(3 步)。然后 Agent 认为任务完成——因为模板没有提示"检查中间件"。
authMiddleware 仍然是 Express 的 (req, res, next) 签名。你手动指出"还有中间件",它改了 authMiddleware,又漏了 errorHandler、rateLimiter。每次你发现一个遗漏,就要开一轮新对话重新描述上下文。3-5 步后需要人工介入,每个遗漏又是一轮。
问题的根源不是模型"不够聪明",而是架构上不存在"发现未知影响面"的机制。模型能看到的 = 你告诉它的 + 模板预定义的。模板没写"检查 config/"下面的文件,Agent 就不会去看——即使 config/server.ts 里有一行 express.static() 正等着爆炸。
天花板在哪:Agent 的视野 = 你告诉它的 + 模板预定义的。它不会自己去"发现"代码中的依赖关系。
路线二:上下文编排
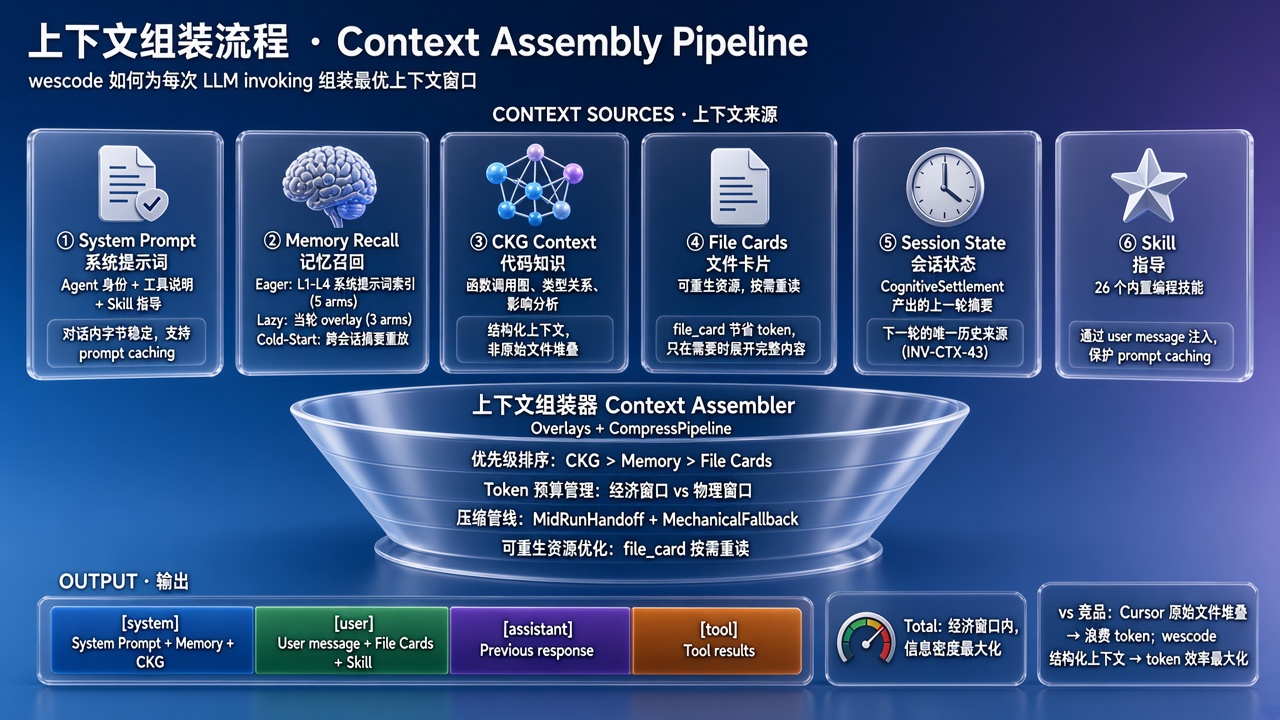
有上下文窗口管理,能在多步操作中维持连贯的执行环境。核心能力是从代码库中智能选取相关文件填入上下文窗口。
// 路线二:上下文编排的核心循环
async function contextOrchestration(task: string, codebase: Index) {
  const relevant = await codebase.semanticSearch(task)  // Embedding 检索相关文件
  let context = buildWindow(relevant, MAX_TOKENS)       // 上下文窗口管理
  let iteration = 0

  while (!done && iteration < MAX_ITERATIONS) {
    const action = await llm.decide(context, tools)     // 模型决策下一步
    const result = await executeTool(action)
    context = rebalanceWindow(context, result)           // 窗口满了截断旧内容

    if (result.error) {
      context = injectError(context, result.error)       // 错误信息留在上下文里
      // ✅ 能在上下文内修正错误
    }
    iteration++
    // ⚠️ 关掉对话 → 所有"理解"消失
    // ⚠️ 没有长期记忆,不知道你上周说过"统一用 async/await"
  }
}
Express→Fastify 实际执行:
Embedding 索引找到了路由文件(语义上"Express route"和"Fastify route"很近)、大部分中间件(名字里有"middleware")、部分测试。Agent 开始连续执行:改 app.ts、改 routes/*.ts、改 middleware/auth.ts、改 middleware/cors.ts、改 middleware/logger.ts——十几步,改了 10 个文件。
但漏了两处:config/server.ts 里的 express.static() 调用——文件名是"server config"而非"Express middleware",语义搜索排名靠后;test/integration/auth.test.ts 里的测试 helper——测试文件太多,语义排名分散,窗口截断了集成测试部分。
这不是 Embedding 模型的质量问题——换一个更好的向量模型不会从根本上解决。Embedding 衡量的是语义相似度("这段文字和搜索词有多像"),而代码依赖是结构关系("这个函数调用了那个函数")。config/server.ts 和"Express 迁移"在语义上就是不相关的——但在代码结构上是强关联的。
另一个问题出现在窗口截断时:上下文满了,Agent 丢掉了最早放入的文件内容,包括 app.ts 的初始结构。到第 12 步时,Agent 已经"忘了"入口文件长什么样,做出的修改可能和第 1 步的修改产生冲突而不自知。
用 Python 展示 Embedding 搜索和 CKG 调用图的本质差异:
# Embedding 语义搜索 vs CKG 调用图——本质差异

# --- Embedding 搜索 ---
# 问题:找到和 "Express 迁移" 相关的文件
query_embedding = model.encode("Express Fastify migration middleware")
results = vector_db.search(query_embedding, top_k=20)
# results:
#   routes/users.ts     → 0.92(文件名和内容都含 "route")
#   routes/orders.ts    → 0.91
#   middleware/auth.ts   → 0.85(名字含 "middleware")
#   middleware/cors.ts   → 0.83
#   app.ts              → 0.80
#   ...
#   config/server.ts    → 0.31  ← 语义距离远,被截断
#   test/helpers/mock.ts → 0.28  ← 排名靠后,不进窗口

# --- CKG 调用图 ---
# 问题:找到和 express 模块有调用关系的所有文件
callers = ckg.query("""
    SELECT DISTINCT source_file
    FROM edges
    WHERE target_symbol LIKE 'express.%'
       OR target_module = 'express'
""")
# callers:
#   app.ts              → IMPORTS express
#   routes/users.ts     → CALLS express.Router()
#   routes/orders.ts    → CALLS express.Router()
#   middleware/auth.ts   → CALLS (req, res, next) 签名
#   middleware/cors.ts   → CALLS (req, res, next) 签名
#   config/server.ts    → CALLS express.static()  ← 被精确找到
#   test/helpers/mock.ts → IMPORTS express for mock ← 被精确找到
关键区别:Embedding 是"名字像不像"的概率匹配,CKG 是"谁真的调用了谁"的确定性追溯。8000 行项目里两者的差异可能是 2 个文件(如上例);80000 行项目里差异可能是 20 个文件——后者就是线上 bug 的来源。
天花板在哪:Embedding 找的是"名字像的代码"而不是"有调用关系的代码"。config/server.ts 的文件名和 Express 没有语义关联,但它引用了 express.static()——这个关系只有调用图能捕获。
路线三:认知引擎
有持久记忆、Plan 系统、循环检测、认知结算。不只执行任务,还积累经验。
// 路线三:认知引擎的核心循环(wescode 的 Agent Loop)
async function cognitiveEngine(task: string, cell: Cell) {
  const memory = await cell.memory.recall(task)          // 注入长期记忆
  const context = assembleContext(memory, task)           // 加载记忆 + 项目上下文
  const plan = await llm.createPlan(context)             // 线性 Plan 清单

  while (plan.hasPendingSteps()) {
    const step = plan.nextStep()
    const impact = await cell.ckg.analyzeImpact(step)    // CKG 精确影响面
    const result = await executeTool(step, impact)

    await cell.cse.checkConstraints(result)              // CSE 约束检查
    await cell.verify(result)                            // L2.5 行为基线验证

    if (cell.cycleDetector.isLoop(result)) {             // 循环检测
      const healed = await cell.cycleDetector.selfHeal() // 首次:注入纠正消息+重置
      if (!healed) await cell.hitl.askUser()              // 第二次:HITL 问用户
    }
    if (context.nearWindowLimit()) {
      await midRunCompress(context)                      // MidRunCompression
    }
    plan.markDone(step)                                  // 引擎盖章(工作账本)
  }

  await cell.cognitiveSettlement()                       // 认知结算:主模型提炼→持久化
}
Express→Fastify 实际执行:
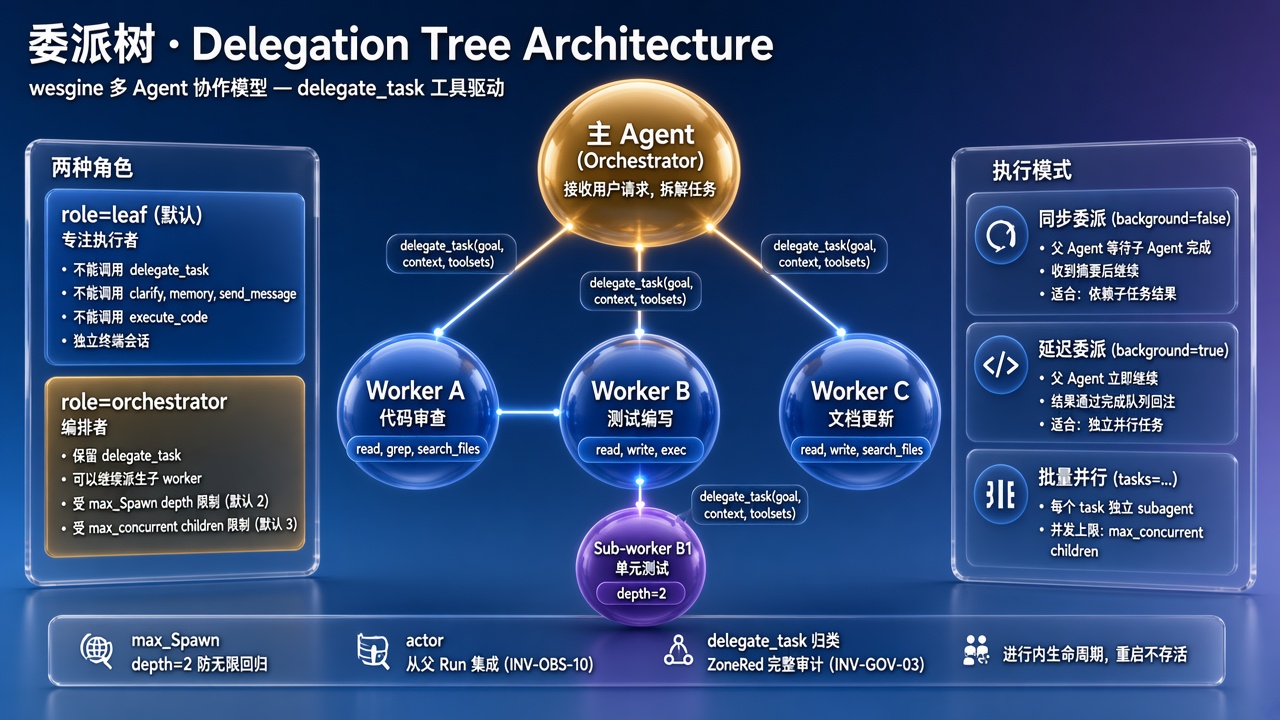
CKG 调用图直接告诉 Agent:authMiddleware 被 userRoutes、orderRoutes 等 5 个文件 CALLS;errorHandler 被 3 个路由文件引用;rateLimiter 被 app.ts IMPORTS;config/server.ts 调用了 express.static()。Plan 列出 14 步,覆盖全部有关系的文件。
第 7 步 CSE 发现 errorHandler 仍用 (err, req, res, next) 四参数签名(Express 约定),标记为约束违反,Agent 立即修正为 Fastify 的 (error, request, reply) 签名。第 12 步 L2.5 行为基线跑通集成测试并对比迁移前后的 API 响应——确认 GET /users/:id 的响应结构和状态码与迁移前一致,同时检测到 POST /orders 的错误返回格式从 { error: "..." } 变成了 { message: "..." },标记为行为变化,Agent 修正了错误处理函数的返回格式。
第 9 步时 Agent 改 rateLimiter 后 build 失败——fastify-rate-limit 的配置格式和 express-rate-limit 不同。Agent 在上下文内看到错误,调整了配置格式。如果同一个错误连续出现(完全相同的操作 + 完全相同的结果),循环检测触发:首次注入纠正消息让模型换一个方向尝试;第二次触发 HITL 问你"这个 rate-limit 配置应该怎么写"。
Run 结束后认知结算把本次迁移的关键发现写入长期记忆——"Express→Fastify 中间件签名差异:(req, res, next) → (request, reply)"、"fastify-rate-limit 配置格式与 express-rate-limit 不兼容"、"错误返回格式需统一为 { error: ... } 而非 { message: ... }"。下次类似迁移直接知道这些要点,不需要重新踩坑。这些产物不是"保存对话历史"——是主模型提炼出的结构化认知,写入 Memory 后自动注入未来的对话上下文。
天花板在哪:依赖 CKG 调用图的完整性。动态分派(obj[methodName]())CKG 无法静态追踪;跨仓库依赖不在索引范围内。
Express→Fastify 迁移的逐步对比
同一个 Express 项目(约 8000 行,12 个路由文件,6 个中间件,40+ 个测试):
| 步骤 | 提示词路由 | 上下文编排 | 认知引擎(wescode) |
|---|---|---|---|
| 影响面定位 | 靠 Prompt 描述,Agent 只看到你提到的文件 | Embedding 语义搜索,按"名字像不像"排名 | CKG 调用图遍历,6 种关系边精确定位 |
| 改路由定义 | ✅ 改了 3 个主要文件 | ✅ 改了 10 个文件 | ✅ 改了 12 个文件(CKG 给出完整清单) |
| 改中间件签名 | 未检测到中间件 | ⚠️ 改了 4/6(2 个语义距离远被漏掉) | ✅ 改了 6/6(CALLS 关系直接命中) |
| 改配置文件 | 不在视野内 | ⚠️ config/server.ts 语义排名靠后被漏 | ✅ CSE 检查到仍引用 express.static |
| 更新测试 | 未涉及测试 | ⚠️ 部分(窗口截断漏掉集成测试) | ✅ CKG 追溯测试中对路由 helper 的调用 |
| 行为验证 | 无 | 可运行测试但不对比行为差异 | L2.5 对比迁移前后 API 响应 |
| 循环检测 | 报错后重试或终止 | 有限重试 | 相同操作+结果 → 自愈 → HITL |
| 下次同类任务 | 从零开始 | 从零开始 | Memory 已有相关经验 |
| 人工介入次数 | 3-5 次 | 1-2 次 | 0 次(CKG 覆盖完整时) |
Before/After 对比——同一个重构任务的完成过程:
| 维度 | Before(路线一/二) | After(路线三) |
|---|---|---|
| 定位影响面 | 人工列清单 or Embedding 猜测,~70% 覆盖(内部测试数据) | CKG 调用图自动遍历,~95% 覆盖(内部测试数据) |
| 发现第一个遗漏的时间 | 上线后(线上 bug 报告) | 执行中(CKG 在 Plan 阶段就列出) |
| 修复遗漏的成本 | 新对话 + 重新描述上下文 + 手动指出文件 | Agent 自行在当前 Plan 内处理 |
| 同类迁移的第二次 | 时间和遗漏率与第一次相同 | Memory 已有经验,遗漏率下降 |
| 一周内完成 3 次类似迁移的总时间 | 3 × 2 小时 = 6 小时 | 2 + 1.5 + 1 = 4.5 小时(认知积累) |
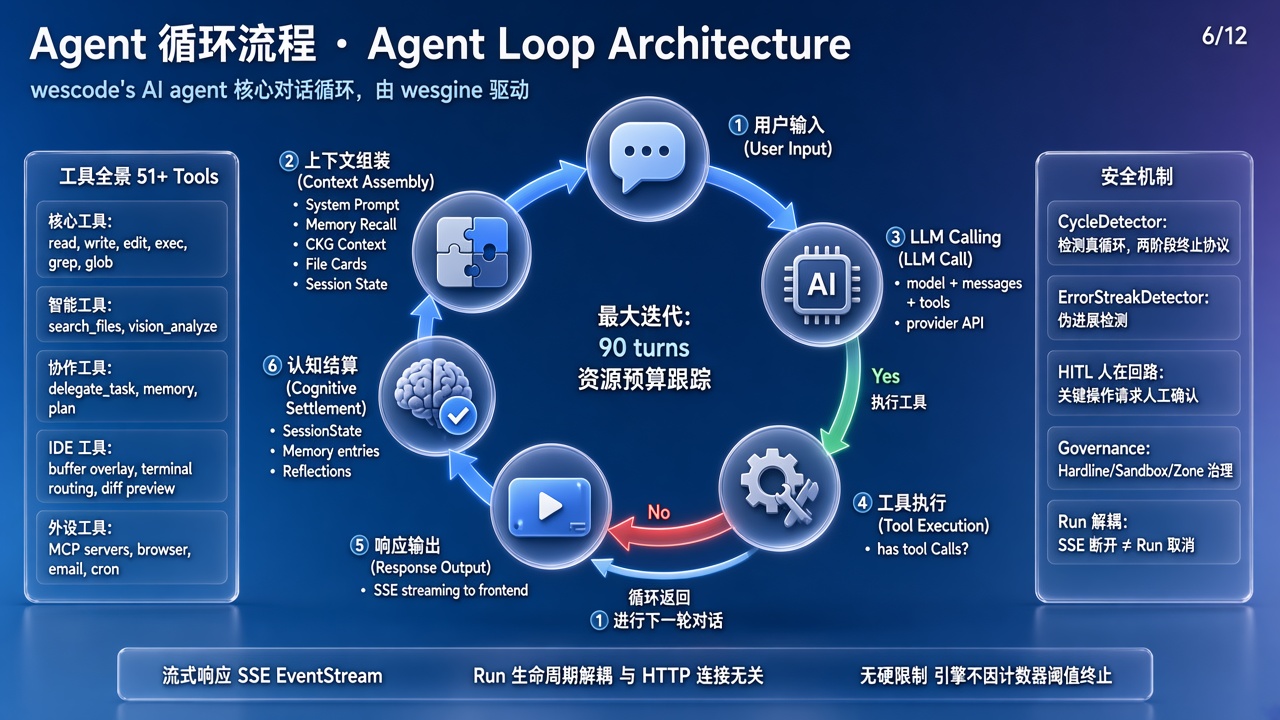
Agent Loop 架构全貌
wescode 的 Agent Loop 不是一个简单的 while 循环。完整流程:
用户请求
  → 加载长期记忆(偏好 / 纠正 / 经验)+ 组装上下文
  → Plan 规划(线性清单,模型驱动)
  → 执行工具调用
    → CKG 影响面分析(调用图精确定位谁受影响)
    → 验证(构建 / 测试 / CSE 约束检查 / L2.5 行为基线)
    → 循环检测(完全相同操作+结果 → 首次自愈,第二次 HITL)
    → MidRunCompression(上下文接近窗口上限时自动压缩)
  → 步骤完成 or 继续循环
  → 所有步骤完成 → Run 结束
    → 认知结算(主模型提炼认知产物 → 持久化记忆)
几个关键设计决策:
Plan 是线性清单,不是 DAG。 模型驱动步骤完成(plan(action=update, status=done)),引擎只做工作账本盖章——记录"这步是否有非 plan 工具调用发生过"。引擎不隐式推进、不自动跳过、不做认知判断。为什么不用 DAG?因为 LLM 擅长线性推理,DAG 依赖声明(depends_on)引入了"引擎决定步骤先后"的复杂性,实测中 DAG 反而让模型更容易困惑。
循环检测的两阶段终止协议。 CycleDetector 检测的是"可证明的死循环"——完全相同的操作 + 完全相同的结果,连续出现多次。不是"你跑太久了"的计时器。第一次触发时注入纠正消息并重置计数器;第二次触发才 HITL 问用户。超时 60 秒无响应则自动终止并保存进度。
用 Java 伪代码理解循环检测的两阶段协议:
// 循环检测的两阶段终止协议——概念模型
public class CycleDetector {
    private int identicalCallCount = 0;
    private String lastCallSignature = "";  // 操作 + 参数 + 结果的哈希

    // 阈值配置(wescode 编程场景的默认值)
    static final int IDENTICAL_WARN = 4;   // 警告阈值
    static final int IDENTICAL_TERM = 7;   // 终止阈值
    static final int ACTION_TERM = 50;     // 同类工具累计阈值

    public CycleResult check(ToolCall call, ToolResult result) {
        String signature = hash(call.name, call.args, result.output);

        if (signature.equals(lastCallSignature)) {
            identicalCallCount++;
        } else {
            // 参数或结果不同 → streak 减半(progress-aware)
            identicalCallCount = Math.max(0, identicalCallCount / 2);
            lastCallSignature = signature;
        }

        if (identicalCallCount >= IDENTICAL_TERM) {
            // 第二阶段:HITL 问用户
            return CycleResult.HITL_REQUIRED;
        } else if (identicalCallCount >= IDENTICAL_WARN) {
            // 第一阶段:注入纠正消息,给模型第二次机会
            return CycleResult.SELF_HEAL;
        }
        return CycleResult.OK;
    }
}
认知结算是 Run 生命周期的强制阶段。 每次 Run 结束时主对话模型提炼四类认知产物(会话状态 / 事实偏好 / 纠正 / 教训),写入持久化 Memory。认知结算用的是主对话模型本身,不是辅助模型——"总结质量 = 对话质量"。
Run 生命周期与 SSE 连接解耦。 网络断开不会取消正在执行的 Run——重新连接后可以续播事件。
各路线的天花板

| 维度 | 提示词路由 | 上下文编排 | 认知引擎 |
|---|---|---|---|
| 最大自主步数 | 3-5 步(上下文断裂) | 15-30 步(受窗口限制) | 50+ 步(MidRunCompression + 循环检测) |
| 错误恢复 | 报错后重试或终止 | 上下文内修正,但不记得犯过同样的错 | 两阶段终止 + 认知结算避免重蹈覆辙 |
| 跨会话连续性 | 无——关掉对话一切归零 | 有限(需手动记忆保存) | 引擎级持久化 Memory,自动注入 |
| 行为验证 | 无 | 可运行测试,不对比行为差异 | L2.5 行为基线——"测试绿了但行为变了"也能检测 |
| 代码结构理解 | 依赖模型自身能力 | Embedding 语义搜索 | CKG 调用图(10 万行 5-15 秒,内部测试数据) |
| 适合的任务规模 | 单文件修改、简单 bug fix | 跨文件功能开发、中等重构 | 大型重构、持续迭代、需要跨会话一致性 |
| 认知积累 | 无 | 无 | 认知结算提炼关键发现,复利增长 |
CKG + CSE + L2.5 各做什么
三个组件覆盖"找到影响面 → 确认改法正确 → 验证改完没问题"的完整链路:
| 组件 | 回答的问题 | 原理 | 性能 |
|---|---|---|---|
| CKG(代码知识图谱) | "改了这里还要改哪里" | tree-sitter 本地构建调用图,6 种关系边 | 10 万行 5-15 秒,增量 100-500ms(内部测试数据) |
| CSE(约束满足引擎) | "这个改动违反了项目的隐式规矩吗" | 签名约定、分层规则、命名规范、依赖约束 | 实时检查,每次工具调用后触发 |
| L2.5(行为基线) | "测试绿了,但行为变了吗" | 对比修改前后 API 响应结构、状态码、错误消息 | 取决于测试套件规模 |
CKG 告诉你影响面(改哪里),CSE 告诉你约束(怎么改才对),L2.5 告诉你结果(改完真的没问题吗)。三者的结合是路线三与路线二的核心差异。
wescode 的 Agent 做不到什么
诚实说:
| 做不到 | 为什么 | 替代方案 |
|---|---|---|
| 跨仓库协调 | 1 workspace = 1 Cell,物理隔离 | 分别在各仓库执行,人工协调接口契约 |
| 商业判断决策 | API 设计取舍、产品优先级不是代码分析能回答的 | Agent 提供技术对比,人做最终决策 |
| UI / E2E 自动化 | 无内置浏览器自动化 | Playwright MCP(可选外设) |
| 动态分派追踪 | obj[methodName]() 运行时才确定 | grep 兜底 + 类型推断,覆盖率约 85-95% |
| 超大规模重构(100+ 文件) | 上下文压力和验证复杂度同时增长 | 分批执行,每批 20-30 文件 |
| 你没表达过的偏好 | 结算只存你明确表达过的事实和偏好 | 显式告诉 Agent 或写入规则文件 |
FAQ
Q:路线二已经够用了,为什么还要路线三?
对"在同一个对话里完成一个功能"的场景,路线二确实够用——Cursor 在这个赛道上是标杆。问题在两方面:一是跨会话连续性——你上周教 AI 的项目约定,这周换个对话就全忘了;二是结构分析的准确性——Embedding 找"名字像的代码",CKG 找"真正有调用关系的代码"。8000 行项目差异不大,80000 行项目会明显感知到。
Q:认知引擎是不是过度设计?
对 10 分钟完成的单文件修改,确实体现不出优势。投入产出比在大型项目持续开发时才显现:跨会话认知连续性、CKG 精确影响分析、L2.5 行为验证——这些在长期项目中的收益远超初期学习成本。这和数据库选型一样——SQLite 够用就不要上 PostgreSQL,但数据量和并发上来了你需要它。
Q:三条路线会融合吗?
大概率会。上下文编排型已在吸收记忆特性(如 Cursor Memory),认知引擎型也在优化开箱体验。最终差异不在"有没有某个功能",而在各自的工程深度——就像数据库都支持 SQL,但底层存储引擎的差异决定了各自擅长的场景。
Q:选哪条路线取决于什么?
取决于你的任务特征。单文件改 bug → 路线一或路线二都够。跨文件功能开发 → 路线二。大型重构 + 长期迭代 + 需要跨会话一致性 → 路线三。不存在"最好的路线",只有最匹配当前任务规模和周期的路线。
Q:CKG 索引 10 万行要 5-15 秒,大项目会不会很慢?
首次索引是全量扫描,之后文件变更触发增量更新,通常在 100-500ms 完成。索引跑在本地 SQLite 上,不需要联网。对比 Embedding 方案:同规模项目的首次向量化通常需要几分钟且需要向量数据库。CKG 更快、更精确、完全离线。
Q:用了路线三就不需要人工 code review 了吗?
不是。Agent 做的是"已知规则的自动化验证"——CSE 检查签名约定、L2.5 对比行为差异。但 code review 的核心价值在"设计思路对不对"、"抽象合理吗"——这些需要项目上下文和工程品味,Agent 做不到。正确的分工:Agent 消灭机械性遗漏,人类聚焦设计判断。
Q:认知结算会拖慢每次对话吗?
结算发生在 Run 结束后,不阻塞你的下一条消息。耗时通常在 2-5 秒。结算产物对用户不可见——不会弹出气泡,你唯一感知到它的方式是"下次对话时 Agent 记得上次的项目细节"。
本文对各路线能力的描述基于 2026-09 的公开文档和功能。
三条路线不是好坏之分,是天花板不同。如果你的日常主要是单文件修改和快速问答,路线一已经够用;如果经常做跨文件重构和长期迭代,值得试试引擎级的认知循环。