中文语境下的代码理解:国产工具真的更强吗
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
"通义灵码写中文项目更丝滑"、"Trae 天生懂中文"、"Cursor 是英语世界的产品,中文不行"——这些说法在国内开发者社区里非常流行。
结论先说:AI 编程工具的中文理解能力首先取决于底层大模型,不是工具本身。国产工具的真正优势在于本地化体验——界面、社区、延迟、支付方式。而代码结构分析则完全与语言无关。
一、中文在代码中长什么样
国内团队的真实项目里,中文出现在多个层面:
层面 1——中文标识符 + 业务逻辑注释:
class 审批流引擎:
    def 提交审批(self, 申请单: dict) -> dict:
        """
        金额 < 5000 直接通过;5000-50000 需部门经理审批;
        > 50000 需总经理审批。跨部门报销需要额外加签。
        """
        金额 = 申请单["报销金额"]
        审批人列表 = self._确定审批链(金额, 申请单["是否跨部门"])
        return self._创建审批实例(申请单, 审批人列表)
层面 2——中文业务配置和领域常量:
const 审批状态 = {
  待提交: 'DRAFT', 审批中: 'PENDING',
  已通过: 'APPROVED', 已驳回: 'REJECTED',
} as const;

type 请假类型 = '年假' | '事假' | '病假' | '婚假' | '产假';

interface 请假申请 {
  申请人工号: string;
  请假类型: 请假类型;
  请假天数: number;
  当前状态: typeof 审批状态[keyof typeof 审批状态];
}
层面 3——中文错误消息和日志:
public class 库存不足异常 extends BusinessException {
    public 库存不足异常(String 商品编码, int 请求数量, int 实际库存) {
        super(String.format(
            "商品[%s]库存不足:请求%d件,当前库存%d件,缺口%d件",
            商品编码, 请求数量, 实际库存, 请求数量 - 实际库存));
    }
}
层面 4——中文业务 DSL 和规则表达式:
# 真实的业务规则引擎配置
DISCOUNT_RULES = {
    "满300减50": lambda total: total - 50 if total >= 300 else total,
    "新客首单八折": lambda total, is_new: total * 0.8 if is_new else total,
    "会员日全场九折": lambda total, is_member_day: total * 0.9 if is_member_day else total,
    "跨店满减不叠加": lambda total, cross_store: max(total - 100, total * 0.85) if cross_store else total,
}
AI 工具需要理解的不只是中文字面意思——确定审批链 暗含权限层级,跨部门报销需要额外加签 是需要落实到代码的业务规则,库存不足异常 的错误消息格式隐含前端展示需求,满300减50 和 跨店满减不叠加 蕴含业务互斥语义。这些理解能力来自哪里?来自底层大模型。
二、中文能力来自模型——四个模型同一 Prompt
给四个主流模型同一个中文 prompt:
"实现
计算会员等级函数。累计消费 < 5000 普通;5000-20000 银卡;20000-50000 金卡;≥ 50000 钻石。连续 12 月无消费降一级,有免降级保护的豁免。"
Claude Sonnet:
function 计算会员等级(会员: 会员信息): 会员等级 {
  if (需要降级(会员) && !会员.免降级保护) {
    return 降一级(当前等级(会员.累计消费));
  }
  return 当前等级(会员.累计消费);
}
沿用中文命名,函数拆分清晰。中文理解完全没有问题。
GPT-4o:
function calculateMemberLevel(member: MemberInfo): MemberLevel {
  const currentLevel = getBaseLevel(member.totalSpending);
  if (shouldDowngrade(member) && !member.downgradeProtected) {
    return downgrade(currentLevel);
  }
  return currentLevel;
}
自动将中文标识符转为英文。逻辑正确,但风格转换了。
DeepSeek V3:
function 计算会员等级(会员: 会员信息): 会员等级 {
  let 等级 = this.获取基础等级(会员.累计消费);
  const 月数差 = 计算月份差(new Date(), 会员.最后消费日期);
  if (月数差 >= 12 && !会员.免降级保护) {
    等级 = this.降级(等级);
  }
  return 等级;
}
沿用中文命名,变量命名风格贴近国内习惯(月数差、获取基础等级)。
通义千问:
function 计算会员等级(会员: 会员信息): 会员等级 {
  const 距上次消费月数 = 计算距今月数(会员.最后消费日期);
  const 需要降级 = 距上次消费月数 >= 12 && !会员.免降级保护;
  const 基础等级 = 会员.累计消费 >= 50000 ? '钻石'
    : 会员.累计消费 >= 20000 ? '金卡'
    : 会员.累计消费 >= 5000 ? '银卡' : '普通';
  return 需要降级 ? 降低一级(基础等级) : 基础等级;
}
中文命名最自然,变量名读起来就是完整中文(距上次消费月数、需要降级),代码即注释。
| 维度 | Claude Sonnet | GPT-4o | DeepSeek V3 | 通义千问 |
|---|---|---|---|---|
| 中文 prompt 理解 | ✅ 正确 | ✅ 正确 | ✅ 正确 | ✅ 正确 |
| 中文标识符续写 | ✅ 沿用 | 自动转英文 | ✅ 沿用 | ✅ 最自然 |
| 中文注释风格 | 简洁 | 英文注释 | 口语化 | 最接近国内规范 |
四个模型都正确理解了业务逻辑。 差异在代码风格——GPT-4o 倾向把中文标识符"翻译"成英文,通义千问中文命名最符合国内习惯。这是训练数据偏向,不是理解能力差距。

三、国产工具横向对比
| 维度 | 通义灵码 | Trae | CodeGeeX |
|---|---|---|---|
| 出品方 | 阿里云 | 字节跳动 | 智谱 AI |
| 形态 | VS Code 插件 | 独立 IDE(VS Code Fork) | VS Code 插件 / IDE |
| 价格 | 个人免费(约 100 次/日限制) | 完全免费 | 完全免费无限制 |
| 底层模型 | 通义千问系列 | 豆包 / DeepSeek | GLM 系列 |
| 代码去向 | 阿里云服务端 | 字节后端 | 智谱服务端 |
| 最强场景 | Java / Spring Boot / 阿里云 SDK | 全流程 Builder 模式 | 私有化部署(唯一支持) |
三个工具在纯中文代码理解上和接入同级别模型的工具差距不大——底层模型能力相近。它们各自的真正优势:
- 通义灵码:对阿里云生态的理解是独到优势。写 Spring Cloud Alibaba、调用 OSS、配置 Nacos 时补全准确率更高——不是"懂中文",是训练数据里阿里云代码占比高。
- Trae:Builder 模式是亮点。描述完整需求后能自动创建文件结构、写代码、跑测试。延迟约 200ms,使用流畅。
- CodeGeeX:唯一支持完全私有化部署。金融、政府等不允许代码出网的场景里是唯一选项。代价是 GLM 模型在复杂推理上弱于 Claude / DeepSeek。
四、真正的中文优势不是模型——是本地化体验
把"中文好"拆开看:
| 维度 | 国产工具 | Cursor / Copilot | wescode |
|---|---|---|---|
| 界面语言 | 中文原生 | 英文 | 中文原生 |
| 社区 | 钉钉/飞书群,当天回复 | Discord / GitHub(英文) | 中文社区 |
| 教程 | B 站/掘金/知乎,大量中文原生 | 英文为主 | 中文原生 |
| 网络延迟 | 境内 50-100ms | 跨境 200-500ms | 本地分析 + BYOK 接国内 API |
| 支付 | 免费 / 支付宝 | 信用卡 USD $20/月 | BYOK 按量(DeepSeek ~1-2 元/百万 token,支付宝) |
对于英语能力有限的开发者,社区和文档差异的实际影响比"模型懂不懂中文"大得多。
五、结构分析是语言无关的——CKG 的独特维度
代码理解还有另一个维度:结构分析——不是理解代码在说什么,而是知道代码之间的调用关系。
class 订单服务 {
  private 库存服务: 库存接口;
  async 创建订单(请求: 创建订单请求): Promise<订单> {
    const 库存 = await this.库存服务.批量锁定(请求.商品列表);
    return this._生成订单(请求, 库存);
  }
}

class Redis库存服务 implements 库存接口 {
  async 批量锁定(商品列表: 商品项[]): Promise<锁定结果> { /* ... */ }
}
修改 库存接口.批量锁定 的参数时,你需要知道谁在调用它、谁实现了它。这个问题的答案和标识符是中文还是英文没有任何关系。
tree-sitter 解析下面两段代码走完全相同的 AST 路径:
class 订单服务 { 库存服务: 库存接口 }       // 中文
class OrderService { inventory: IInventory }  // 英文
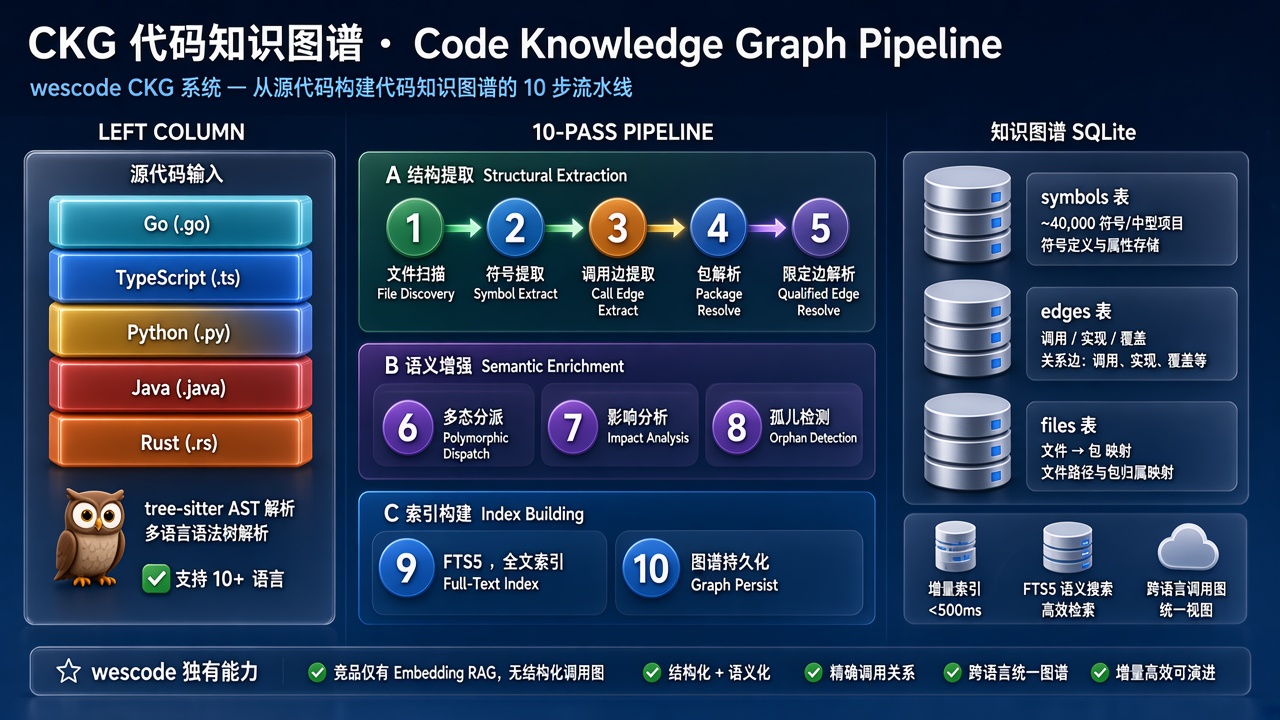
AST 层面两者结构一致——都是 class 声明 + typed 属性。CKG 构建的 CALLS / IMPLEMENTS / IMPORTS 关系图不依赖标识符语言,只依赖语法结构。
用 Java 举一个更完整的例子:
// src/service/支付服务.java
public class 支付服务 {
    private final 订单仓库 订单仓库;
    private final 支付网关 支付网关;

    public 支付结果 发起支付(Long 订单号) {
        订单 order = 订单仓库.查询(订单号);
        return 支付网关.扣款(order.获取金额(), order.获取支付方式());
    }
}

// CKG 分析结果(和标识符语言无关):
// 支付服务.发起支付 → CALLS → 订单仓库.查询
// 支付服务.发起支付 → CALLS → 支付网关.扣款
// 支付服务 → DEPENDS_ON → 订单仓库, 支付网关
你修改 支付网关.扣款 的签名,CKG 会精确告诉你 支付服务.发起支付 第 8 行需要同步修改。Embedding 搜索会返回"语义相近"的代码——退款服务.发起退款、支付工具类.验签——名字像但无关。
wescode 的 CKG:
- 不上传代码到任何服务器
- 不调用任何 LLM
- 不关心标识符是中文、英文还是日文
- 10 万行项目索引 5-15 秒(内部测试数据)
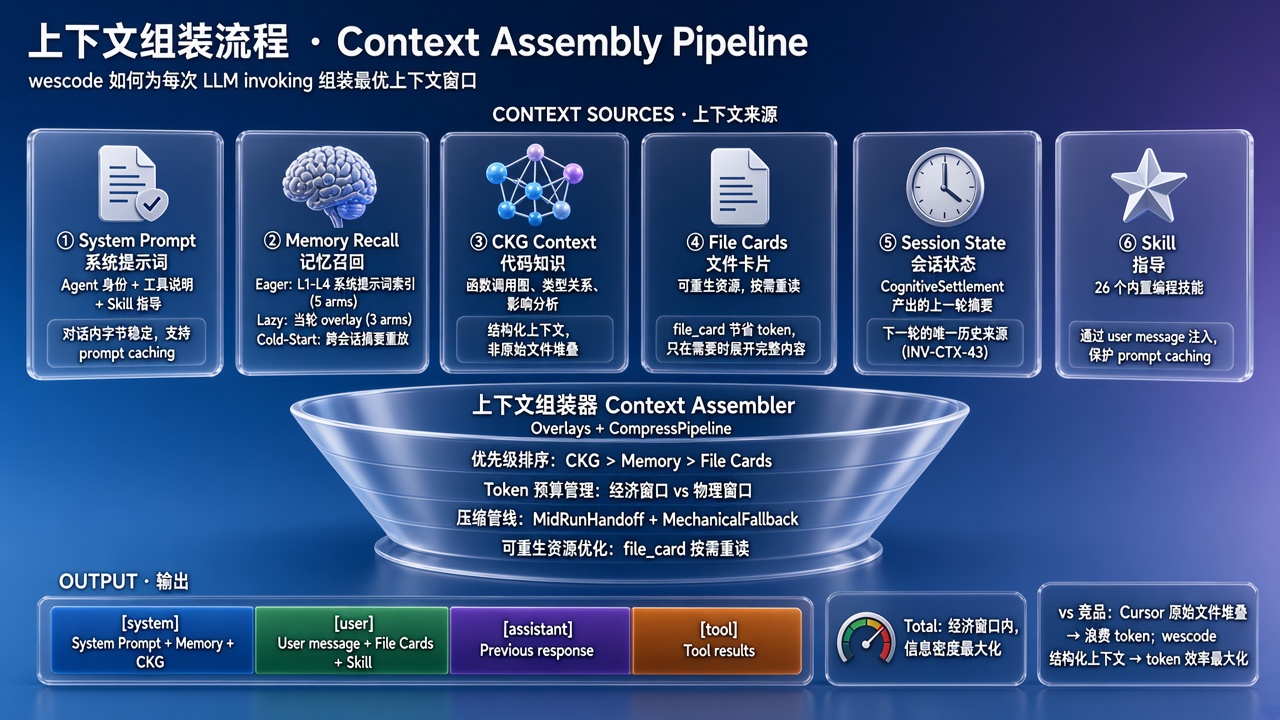
问"修改 批量锁定 会影响谁"时,CKG 精确返回调用链。其他工具依赖 Embedding 向量索引找相关代码,返回"语义相近"片段,不保证覆盖所有真正的调用方。
六、有工具 vs 没工具:中文项目的典型场景
以"修改中文接口参数"这个任务为例:把 库存服务.批量锁定(商品列表: 商品项[]) 改为 库存服务.批量锁定(锁定请求: 批量锁定请求)。
| 步骤 | 手动操作 | 通义灵码 / Trae | wescode |
|---|---|---|---|
| ① 找所有调用方 | grep "批量锁定" + 人工确认,~15 分钟 | 当前文件 / Embedding 搜索,~2 分钟 | CKG 精确返回 3 个调用方 + 1 个接口实现,~3 秒 |
| ② 区分直接调用 vs 接口调用 | 人工读代码,~10 分钟 | 无法区分 | CKG 自动标注:2 CALLS + 1 IMPLEMENTS |
| ③ 修改接口定义 + 所有实现 | 手写,~20 分钟 | 手动逐文件,~5 分钟 | 一次全量修改,~1 分钟 |
| ④ 检查是否有遗漏 | 再 grep 一遍 + Review,~10 分钟 | 无法确认 | CKG 确认修改覆盖 100% 调用方 |
| 总耗时 | ~55 分钟 | ~7 分钟(不完整) | ~2 分钟(完整) |
关键差距不在速度——在完整性。grep 搜 批量锁定 会找到注释里的、字符串里的、已注释掉的;Embedding 搜索会返回 单个锁定、批量解锁 这些名字像的函数。CKG 只返回真正的调用方和实现方——零干扰、零遗漏。
七、BYOK 按任务选模型——中文场景的最优解
wescode BYOK 模式让你自由搭配:
| 任务 | 推荐模型 | 理由 |
|---|---|---|
| 日常补全 | DeepSeek V3 | 中文原生 + 极高性价比 |
| 复杂推理 | Claude Sonnet | 推理能力顶尖 |
| 中文文档生成 | 通义千问 | 中文表达最自然 |
| 大上下文 | Claude / Gemini | 200K+ 窗口 |
一个项目里可以按任务切换模型。 对比固定模型的工具:通义灵码只能用千问系列,Trae 主要用豆包,它们在特定场景下优秀,但无法覆盖所有需求。
wescode 接 DeepSeek V3 实测:中文标识符续写自然、中文业务逻辑理解准确、不会把中文变量名"翻译"成英文。再加上 CKG 提供结构层分析——DeepSeek 理解业务语义,CKG 精确定位调用关系,两者互补。
和通义灵码的差异:
| wescode + DeepSeek V3 | 通义灵码 | |
|---|---|---|
| 中文理解 | ✅ DeepSeek 中文原生 | ✅ 千问中文原生 |
| 模型自由 | 支持自由切换 | 仅千问系列 |
| 调用图分析 | CKG 本地分析 | 依赖 Embedding |
| 代码安全 | 代码不出设备 | 上传阿里云 |
| 阿里云 SDK | 一般 | ✅ 明显优势 |
八、数据安全:不可忽略的维度
| 工具 | 代码去向 | 数据处理方式 |
|---|---|---|
| Cursor | 海外服务器 | 代码上传做 Embedding + LLM 推理 |
| 通义灵码 | 阿里云服务端 | 代码片段上传做补全推理 |
| Trae | 字节后端 | 代码上传做 Builder 分析 |
| CodeGeeX | 智谱服务端(支持私有部署) | 云端推理 / 本地推理(私有部署) |
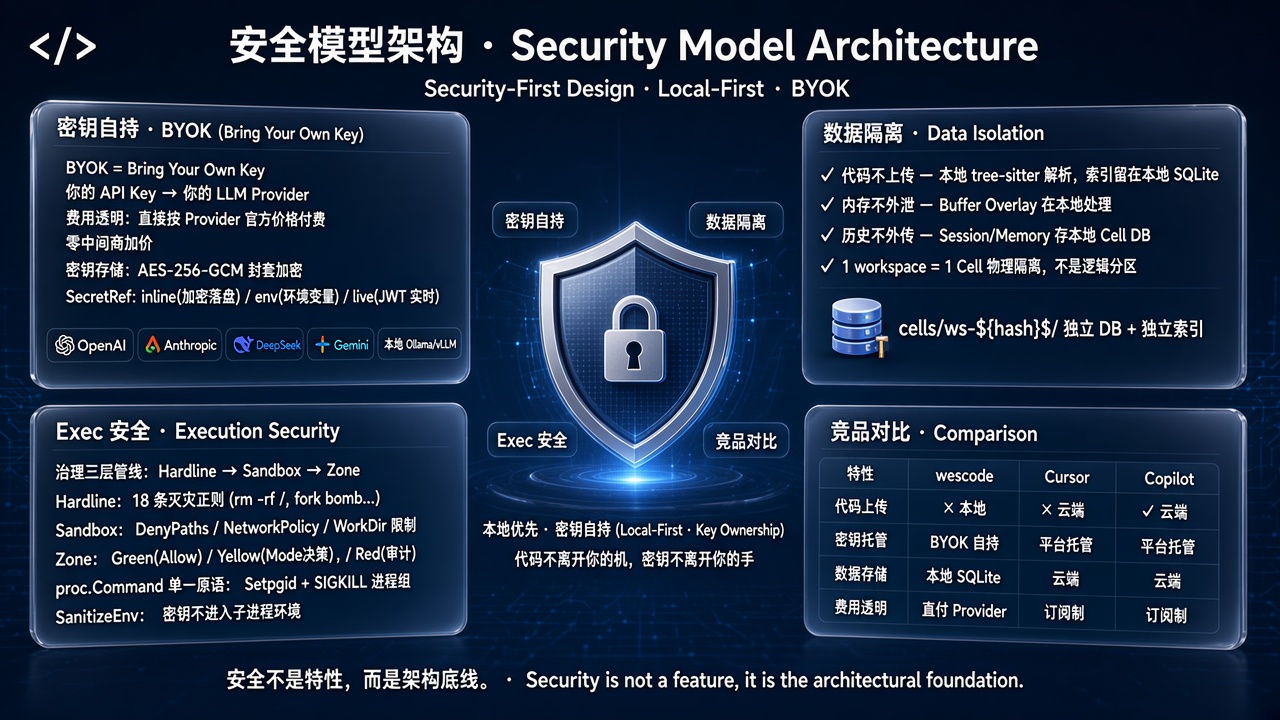
| wescode | 代码不出设备 | CKG 全本地,仅 LLM prompt 走网络 |
BYOK 模式下你选择模型提供商——想数据留国内接 DeepSeek API,要求极高安全接本地部署模型(如 Ollama + Qwen2.5-Coder)。
这里有一个重要的技术细节:wescode 的 CKG 索引(占代码理解工作量的 80%)完全在本地完成——10-Pass 解析、关系图构建、调用链查询,全部在你的电脑上。只有当你向 AI 提问时,问题 + 被 CKG 选出的相关代码片段才会发给 LLM——这和把整个代码库上传去做 Embedding 是完全不同的数据暴露面。
九、选型建议
| 如果你… | 推荐 | 理由 |
|---|---|---|
| 重度阿里云生态 | 通义灵码 | 对 Spring Cloud Alibaba 补全最准 |
| 要免费全流程 AI 开发 | Trae | Builder 模式 + 完全免费 |
| 代码不能出网 | CodeGeeX 私有部署 / wescode + 本地模型 | 唯二可行选项 |
| 大项目精确影响分析 | wescode | CKG 调用图 |
| 按任务选最优模型 | wescode BYOK | 中文用 DeepSeek,推理用 Claude |
常见问题
Q1:项目全中文标识符,应该选国产工具吗?
不必。Claude、GPT、DeepSeek 对中文理解都很好。差异在代码风格——GPT 倾向转英文,DeepSeek/千问沿用中文。通过 BYOK 接 DeepSeek 就能解决。选工具的决定因素不是"中文好不好",而是"工具怎么理解你的代码结构"——50 个文件之间的调用关系,任何模型都搞不定,这需要调用图。
Q2:CKG 对中文变量名有特殊处理吗?
没有。tree-sitter 把 订单服务.创建订单() 和 OrderService.createOrder() 解析为完全相同的 AST 结构。调用图是语法级别的,不需要"理解"标识符含义。实际上 tree-sitter 甚至不知道你用的是什么自然语言——它只看语法 token 的角色(class 声明、方法定义、属性访问、函数调用)。
Q3:wescode 界面是中文吗?和 Cursor 相比本地化做到什么程度?
wescode 界面中文原生,菜单、设置、错误提示都是中文。文档和社区也是中文。和 Cursor 最大的本地化差异不在界面——而是 wescode 的 BYOK 默认推荐国内可用的 API(DeepSeek、通义千问、智谱 GLM),支付宝/微信支付直接在模型提供商官网充值。Cursor 的 $20/月 订阅需要绑国际信用卡。
Q4:同时用通义灵码做补全 + wescode 做重构,会有冲突吗?
技术上不冲突——两者可以同时安装在 VS Code / VS Code Fork 里。但补全可能会同时触发两个插件,建议在设置里指定优先级,或者关掉其中一个的自动补全。实际使用模式:日常写代码靠通义灵码的快速补全(150ms),遇到跨文件重构或需要理解调用关系时切到 wescode 的 Agent 模式。
本文对各工具的描述基于 2026 年 11 月公开信息。各工具政策和模型可能更新,以官方最新说明为准。