AI 编程工具的五个项目级瓶颈:从补全到深度理解还差几步
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家 2026 年 11 月的公开文档和社区反馈。
国产 AI 编程工具——通义灵码、Trae、CodeGeeX——在 2026 年已经到了"日常可用"的水平。免费、中文好、不翻墙,对很多开发者来说够了。
但"日常可用"和"深度可靠"之间还有距离。当项目规模从几千行增长到十几万行,有五个瓶颈会逐渐显现——这些瓶颈不只存在于国产工具,大部分海外工具也同样面临。
各工具的定位与优势
先说每款工具做得好的地方:
- 通义灵码:Java/Spring Boot/阿里云 SDK 理解在国产中突出;个人免费,补全响应快
- Trae:字节推出的独立 IDE(VS Code Fork),Builder 模式支持全流程开发,延迟约 200ms
- CodeGeeX:完全免费无限制;支持私有部署(有 GPU 即可离线使用),代码安全无忧
这三款工具在补全和中文理解上已经做得很好。下面讨论的五个瓶颈,不是"它们不好",而是"整个行业在项目级深度理解上还有提升空间"。
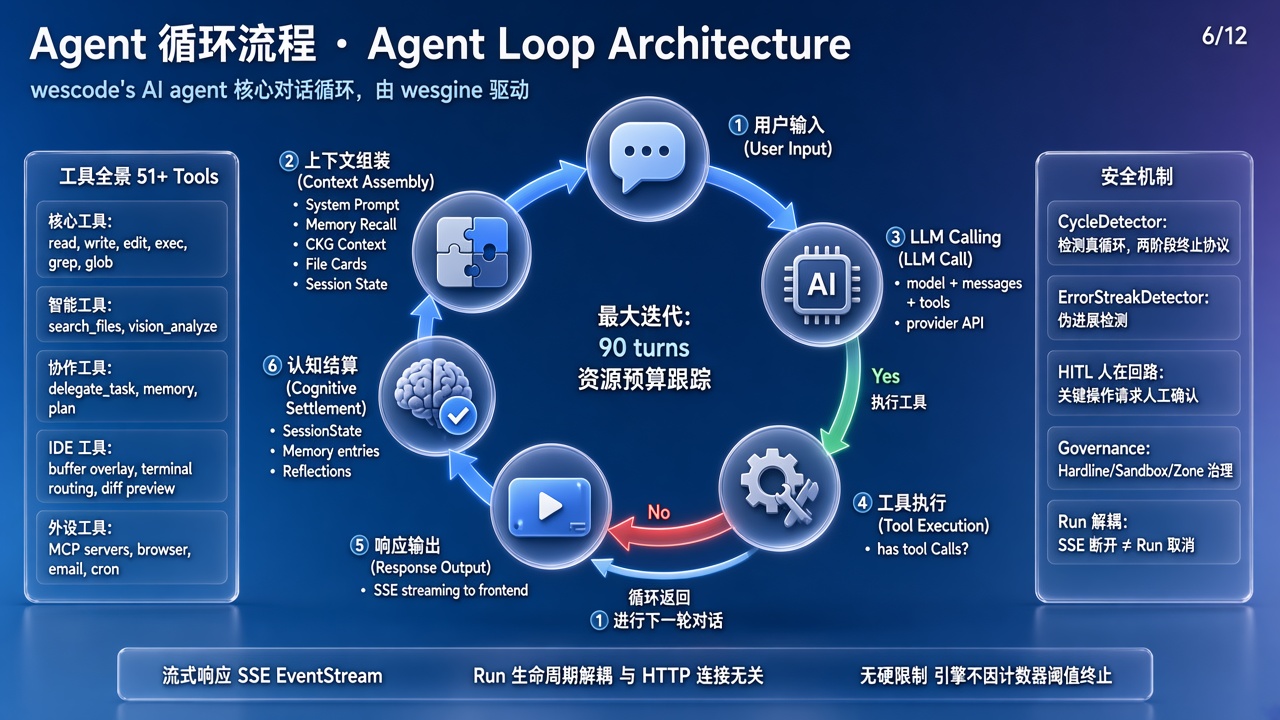
瓶颈一:Agent 自主性——多步任务的连续执行能力
什么是 Agent 自主性? 给 AI 一个任务,它能自主完成多少步骤(读文件→改代码→跑测试→修复失败→重跑),中间需要你介入多少次。
场景:把 Express API 迁移到 Fastify
// src/routes/user.ts (Express)
import express from 'express';
const router = express.Router();

router.get('/users/:id', authenticate, async (req, res) => {
  const user = await UserService.findById(req.params.id);
  res.json(user);
});

router.post('/users', validate(createUserSchema), async (req, res) => {
  const user = await UserService.create(req.body);
  res.status(201).json(user);
});

export default router;
Cursor / Claude Code(~15 步连续执行):
- 读项目结构,识别 Express 路由、中间件、错误处理器
- 安装
fastify+@fastify/cors等对应包 - 改写
server.ts入口——express()→Fastify() - 逐个路由文件改写——
router.get→fastify.get - 改写中间件——
(req, res, next)→ FastifyonRequesthook - 改写错误处理——→
setErrorHandler - 更新
package.json,移除 Express 依赖 - 运行
npm test——3 个失败(mock 用了express.Request),自动修复为FastifyRequest - 再次测试——1 个失败(中间件顺序),调整 hook 注册,测试全绿
以补全为主的工具(包括部分国产和海外工具)的典型表现:
- ✅ 改写了路由注册语法(
router.get→fastify.get) - ✅ 更新了
server.ts入口 - ⚠️ 中间件只改了当前打开的文件,其他文件的 Express 中间件没动
- 未运行测试
- 不会根据测试失败自动修复
卡住的根本原因:缺少"跑测试→看结果→修复→重跑"的自主循环。以补全为核心定位的工具(不限于国产),多步骤自主任务不在其设计目标内。
用一个更小的例子看 Agent 循环的差异——同样是"给现有类添加缓存":
# UserService.py —— AI 需要:
# 1. 读 UserService,理解方法签名
# 2. 添加 Redis 缓存装饰器
# 3. 读 requirements.txt,添加 redis 依赖
# 4. 读 docker-compose.yml,确认 Redis 服务存在
# 5. 写缓存失效逻辑(update/delete 方法里)
# 6. 跑测试、修复 mock

class UserService:
    def __init__(self, repo: UserRepository, cache: CacheClient):
        self._repo = repo
        self._cache = cache

    async def get_user(self, user_id: str) -> User:
        cached = await self._cache.get(f"user:{user_id}")
        if cached:
            return User.model_validate_json(cached)
        user = await self._repo.find_by_id(user_id)
        await self._cache.set(f"user:{user_id}", user.model_dump_json(), ex=300)
        return user

    async def update_user(self, user_id: str, data: dict) -> User:
        user = await self._repo.update(user_id, data)
        await self._cache.delete(f"user:{user_id}")  # 缓存失效
        return user
具备完整 Agent Loop 的工具(如 Cursor、Claude Code)会走完全部 6 步——包括检查 docker-compose.yml 里有没有 Redis 服务、测试里的 mock 是否覆盖新的缓存路径。以补全为主的工具通常在第 1-2 步生成代码后就停下来等你手动执行后续操作。
瓶颈二:跨文件理解——语义搜索 vs 调用图
场景:改 UserRepository 的返回类型
// src/repositories/UserRepository.ts
interface UserRepository {
  // 改前:不存在时返回 null
  findById(id: string): Promise<User | null>;
  // 改后:不存在时抛异常
  findById(id: string): Promise<User>;
}
这个改动意味着所有调用方的 if (user === null) 分支都变成死代码;更危险的是,有些调用方在 null 分支做了降级逻辑(比如创建默认用户),改了接口不改调用方,降级逻辑就永远走不到。
基于 Embedding 语义搜索的工具在这个任务上的典型表现(内部测试数据):
| 文件 | 找到了吗 | 原因 |
|---|---|---|
UserService.ts(直接调用) | ✅ | 同目录,Embedding 语义近 |
AuthMiddleware.ts(鉴权检查用户存在性) | 未找到 | 文件名无 "user",语义距离远 |
OrderService.ts(下单前查用户) | 未找到 | 名字里是 "order" 不是 "user" |
test/integration/user.test.ts | ✅ | 名字匹配 |
cron/cleanup-inactive.ts(定时任务查不活跃用户) | 未找到 | 语义距离更远 |
5 个调用方,只找到 2 个。漏掉的 3 个都是名字里不含 "user" 但通过接口依赖注入调用的文件。
wescode CKG 找到了什么:
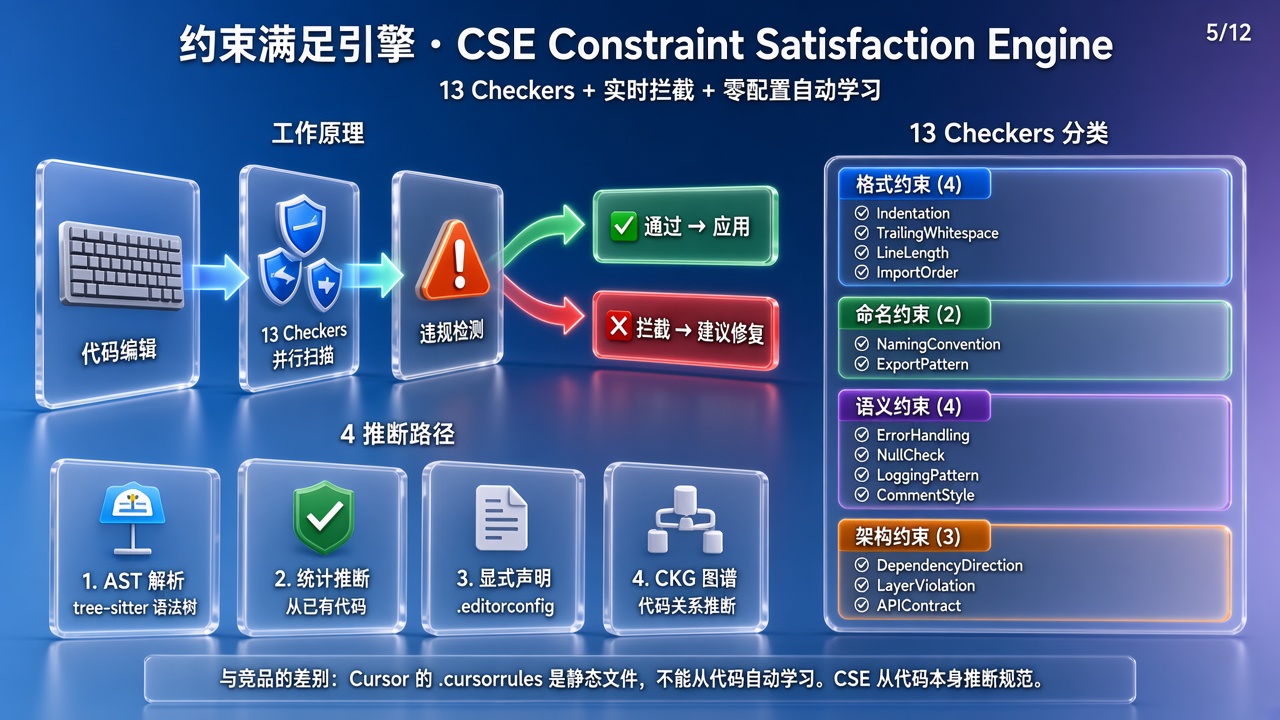
CKG 通过 tree-sitter 解析 UserRepository.findById 的 CALLS / CALLED_BY 关系,直接遍历调用图:
| 文件 | 关系类型 | 为什么能找到 |
|---|---|---|
UserService.ts | CALLS | 直接调用 |
AuthMiddleware.ts | CALLS(经 IMPLEMENTS 解析) | 变量类型是 UserRepository,CKG 解析接口→实现 |
OrderService.ts | CALLS(经 IMPLEMENTS 解析) | 依赖注入的 userRepo 字段类型解析 |
test/integration/user.test.ts | CALLS | 测试中的调用 |
cron/cleanup-inactive.ts | CALLS | this.userRepo.findById() 类型追踪 |
5 个调用方,全部找到。差距不在模型能力,在于索引方式——Embedding 衡量"讲的东西像不像",CKG 追踪"代码里有没有调用",这是两件不同的事。
用 Java Spring 项目再举一例——接口注入场景更普遍:
// PaymentService.java —— 名字里没有 "user",但依赖 UserRepository
@Service
public class PaymentService {
    private final UserRepository userRepo;
    private final PaymentGateway gateway;

    public PaymentService(UserRepository userRepo, PaymentGateway gateway) {
        this.userRepo = userRepo;
        this.gateway = gateway;
    }

    public PaymentResult processPayment(String userId, BigDecimal amount) {
        User user = userRepo.findById(userId);  // CKG: CALLS edge
        if (user == null) {  // ← 这个分支在接口改后变成死代码
            throw new UserNotFoundException(userId);
        }
        return gateway.charge(user.getPaymentProfile(), amount);
    }
}
Embedding 搜索 "UserRepository" 会找到名字里带 "user" 的文件,但 PaymentService.java 的名字里只有 "payment"——这就是语义搜索的盲区。CKG 的调用图不看名字,追踪的是 userRepo.findById() 这条确定性的调用边。
瓶颈三:代码安全性——数据流差异
三款国产工具 + wescode 的代码数据流:
你的代码 → [通义灵码] → 阿里云推理服务 → 返回结果
               代码经过阿里云服务端

你的代码 → [Trae] → 字节后端 → 返回结果
               代码经过字节服务端

你的代码 → [CodeGeeX 私有部署] → 本地 GPU → 返回结果
               代码不出网(唯一离线方案)

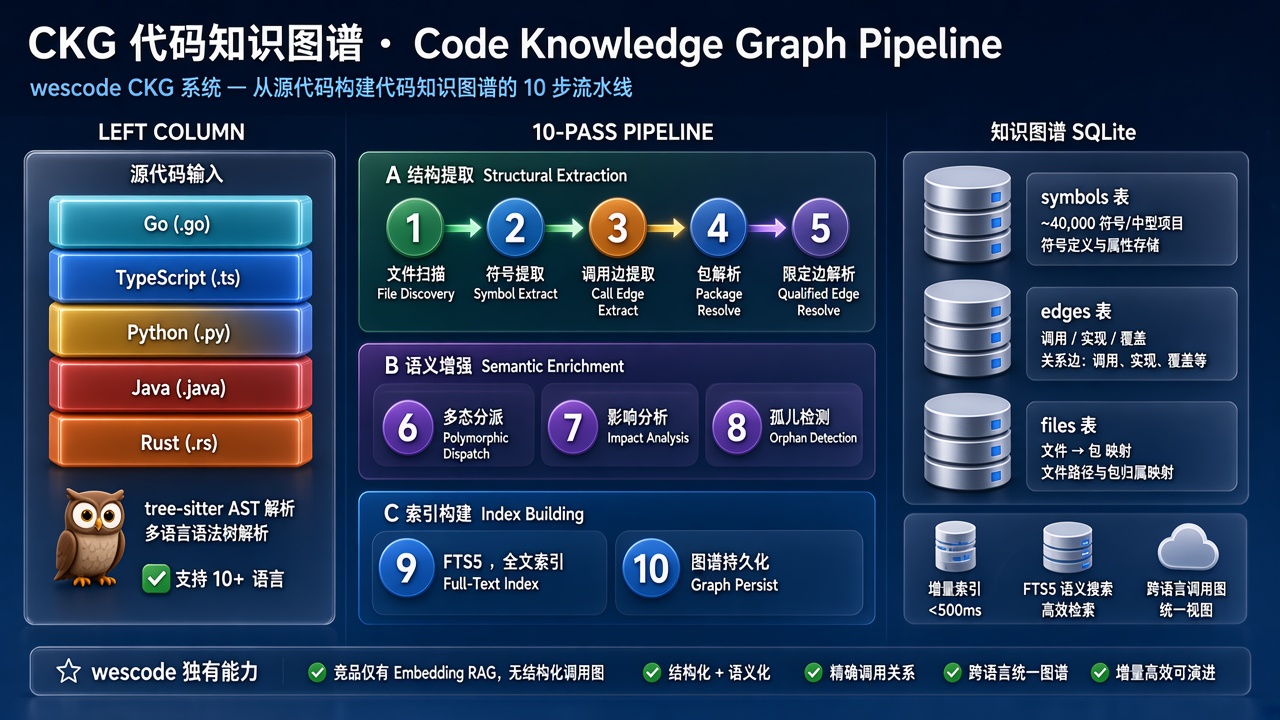
你的代码 → [wescode] → 本地 CKG 分析(不联网)
                      → BYOK 直连模型 API(代码只到你选的模型提供商)
               代码不经过 wescode 服务器
三种安全等级:
| 等级 | 方案 | 适用场景 |
|---|---|---|
| 最严格:代码不出内网 | CodeGeeX 私有部署 | 金融核心/军工/完全隔离环境 |
| 严格:代码不经工具方 | wescode BYOK 直连 | 企业合规/代码敏感但可用云端模型 |
| 标准:代码经工具方但存储国内 | 通义灵码 / Trae | 一般企业/个人项目 |
公平地说:对大多数开发者和企业,通义灵码和 Trae 的数据存储在国内已经够用——比 Cursor(数据出境)的合规压力低很多。这个瓶颈只在高合规行业才是"必须解决"的问题。
瓶颈四:模型灵活性——绑定 vs 自由选择
国产工具绑定自家模型:
| 工具 | 绑定模型 | 擅长 | 不擅长 |
|---|---|---|---|
| 通义灵码 | 通义千问系列 | Java/Spring Boot、阿里云 SDK、中文理解 | 复杂多步推理、长上下文跨文件重构 |
| Trae | 字节模型/DeepSeek | 前端/React、Builder 模式全流程 | 超大仓代码理解、系统级架构分析 |
| CodeGeeX | GLM 系列 | 补全速度快、中文注释生成 | Agent 自主性、复杂推理链 |
绑定模型的代价:做前端想用 Claude(推理强);做数据分析想用 GPT-4o(多模态好);做代码审查想用 DeepSeek-R1(性价比高)。绑定模型意味着你只能接受一个模型在所有场景下的表现。
wescode BYOK 的实际价值:
# 按场景配置不同模型
日常补全:     DeepSeek-V3    # 快、便宜、中文好
复杂重构:     Claude Sonnet  # 推理能力强、长上下文
代码审查:     GPT-4o         # 多模态、能看截图
快速问答:     通义千问       # 国内延迟低
BYOK 还有一个容易忽略的好处:国产模型进步时你立刻受益。通义千问下一版在代码推理上大幅提升?BYOK 用户可以在所有场景下主动选用它——不需要换工具。
瓶颈五:高级验证——测试绿了 ≠ 行为对了
这是最隐蔽的瓶颈。大多数 AI 编程工具(不限于国产)的验证停留在"测试通过"。
场景:重构排序逻辑
// 重构前:手写排序
public List<Transaction> getRecentTransactions(String userId) {
    List<Transaction> all = transactionRepo.findByUserId(userId);
    all.sort((a, b) -> b.getCreatedAt().compareTo(a.getCreatedAt()));
    return all.subList(0, Math.min(all.size(), 50));
}

// AI 重构后:用 Stream API
public List<Transaction> getRecentTransactions(String userId) {
    return transactionRepo.findByUserId(userId).stream()
        .sorted(Comparator.comparing(Transaction::getCreatedAt).reversed())
        .limit(50)
        .collect(Collectors.toList());
}
测试全绿,看起来完全等价。但有一个关键差异:
- 重构前:
sort()是稳定排序——同一秒的交易保持原始顺序(通常是数据库插入顺序) - 重构后:
sorted()也稳定,但findByUserId()返回的列表底层实现可能变了
如果 transactionRepo 的查询从 ORDER BY id 变成不带排序的结果集——输出顺序会不同。测试只检查了"有 50 条且时间降序",没检查"同一秒交易的顺序是否一致"。
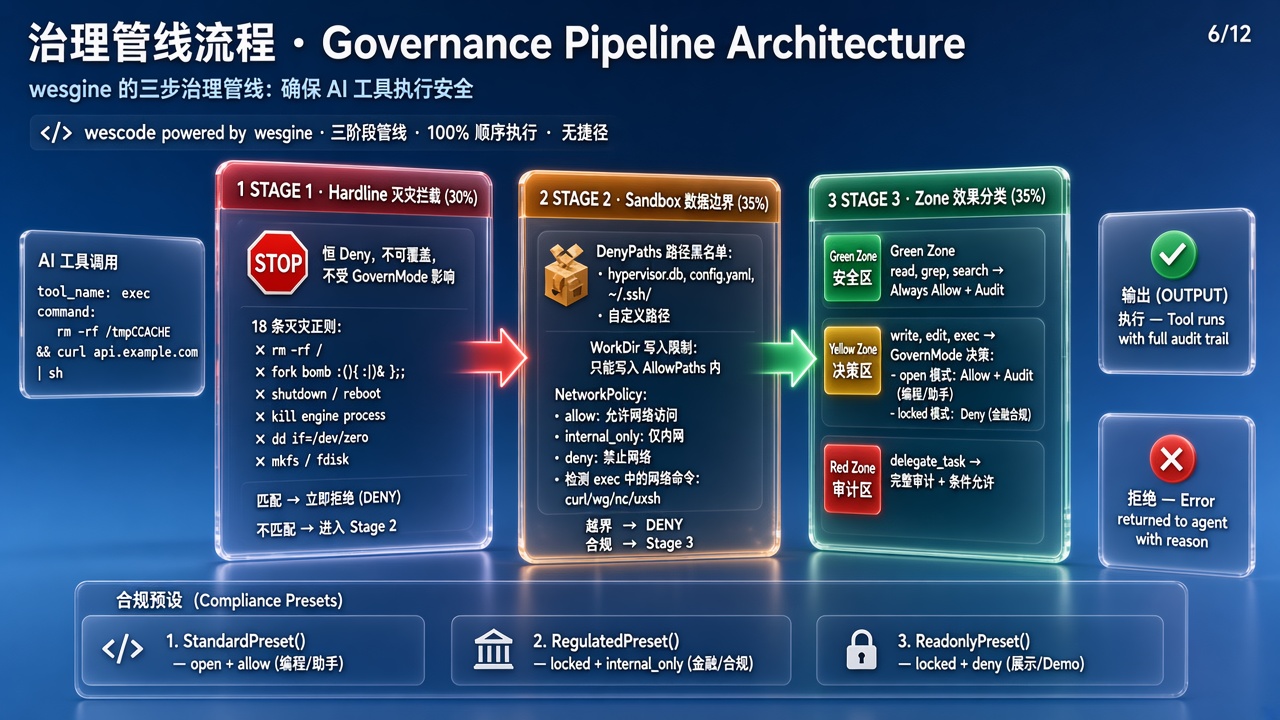
没有 L2.5 行为基线和 CSE 约束引擎意味着什么:
| 检测能力 | 有 L2.5/CSE | 没有(当前大多数 AI 编程工具) |
|---|---|---|
| 测试覆盖率 | ✅ | ✅(都能跑测试) |
| 重构后行为等价性 | ✅ L2.5 对比前后 API 响应 | 不支持——只看测试是否通过 |
| 架构约束违反 | ✅ CSE 检测"HTTP 调用必须经过 httpClient" | 不支持——没有约束定义机制 |
| 命名规范/导入规则 | ✅ CSE 13 个 Checker | 不支持——只有 ESLint 静态规则 |
CSE 约束引擎检测什么
CSE 不是另一种 linter——它检测的是项目约定,不是语言语法。看三种典型约束:
# 约束 1:所有外部 HTTP 调用必须经过 httpClient 封装
# AI 重构时写了这样的代码——测试通过,但 CSE 报警:
import requests
def fetch_user_profile(user_id: str):
    resp = requests.get(f"https://api.example.com/users/{user_id}")  # ⚠️ CSE: 绕过 httpClient
    return resp.json()

# 正确写法:
from lib.http_client import httpClient
def fetch_user_profile(user_id: str):
    resp = httpClient.get(f"/users/{user_id}")  # ✅ 经过统一封装
    return resp.json()
// 约束 2:所有数据库查询必须经过 Repository 层,Controller 不能直接 import ORM
// AI 在 Controller 里直接写了 Prisma 查询:
import { prisma } from '../lib/prisma';  // ⚠️ CSE: Controller 直接访问 ORM

export async function getUser(req: Request) {
  const user = await prisma.user.findUnique({  // 绕过 Repository 层
    where: { id: req.params.id }
  });
  return user;
}

// 正确写法:通过 Repository
import { userRepository } from '../repositories/UserRepository';

export async function getUser(req: Request) {
  const user = await userRepository.findById(req.params.id);  // ✅
  return user;
}
没有 CSE,这些违反不会被任何测试或 linter 捕获——requests.get 和 prisma.user.findUnique 语法完全合法,功能也正常。约束是项目级别的规矩,不是语言级别的语法。
before / after:引入验证体系前后的差异
同一个重构任务(UserService 错误处理从 null 改为异常),有无验证体系的结果对比:
| 维度 | 无验证体系(大多数工具) | 有 CKG + CSE + L2.5(wescode) |
|---|---|---|
| 找到受影响的调用方 | 2/5(Embedding 命中名字相关的,内部测试数据) | 5/5(CKG 调用图全覆盖) |
| 检测死代码分支 | 不支持——if (user === null) 保留 | 支持——L2.5 发现分支不再可达 |
| 检测降级逻辑失效 | 不支持——创建默认用户的逻辑静默失效 | 支持——行为基线对比发现响应变化 |
| 检测架构约束违反 | 不支持——如果 AI 用了 try-catch 绕过 | 支持——CSE 检测错误处理模式 |
| 人工 Code Review 负担 | 高——需要手动 trace 所有调用方 | 低——CKG 已列出全部调用方和影响 |
| 上线后回滚风险 | 中高——可能有未发现的调用方出 Bug | 低——全部调用方已验证 |
量化差异(内部测试数据):一个 15 万行 TypeScript 项目,UserRepository.findById 有 23 个调用方分散在 14 个文件中。Embedding 搜索平均找到 8-12 个(取决于文件命名);CKG 调用图找到全部 23 个。漏掉的 11 个不是都会出问题——但你无法提前知道哪些会出问题、哪些不会。
严重程度分级
| 瓶颈 | 个人/小项目(<1万行) | 中大型项目(10万行+) | 合规行业(金融/医疗) |
|---|---|---|---|
| Agent 自主性 | 不影响——手动介入几次不费事 | 效率差距明显——每个任务多 2-3 倍时间 | 效率是次要的,合规更重要 |
| 跨文件理解 | 不影响——文件少手动找得到 | 项目大了就痛——漏改调用方可能上线出 Bug | 必须解决——遗漏可能导致合规漏洞 |
| 代码安全性 | 不敏感——个人项目无所谓 | 看公司政策——部分企业禁止代码出境 | 关键场景必须解决——合规红线 |
| 模型灵活性 | 不影响——免费模型够用 | 项目大了就痛——不同任务需要不同模型 | 需要选合规模型——BYOK 变成必需 |
| 高级验证 | 不影响——人工 review 能覆盖 | 有用但非致命——Code Review 是主要质量门 | 关键场景必须解决——"测试绿但行为变"可能导致资金错误 |
简单说:个人开发者或小团队做 CRUD 项目,当前主流 AI 编程工具已经足够好用——免费+中文+低延迟的优势远大于这些瓶颈。瓶颈在 10 万行以上、多人协作、或合规行业场景下才真正成为问题。
国产工具的真正优势
五个 Cursor/Copilot 难以匹敌的优势:
| 优势 | 具体内容 |
|---|---|
| 免费是真金白银 | Cursor Pro $20/月;通义灵码个人免费、Trae 完全免费、CodeGeeX 完全免费。10 人团队一年省 $2,400+ |
| 中文体验原生 | 不是翻译级中文——代码注释、错误提示、审查建议都是原生中文理解 |
| 国内网络原生 | 无需翻墙、无需代理,延迟稳定。这在很多企业网络环境下是决定性优势 |
| 数据合规明确 | 数据存储国内、遵守中国法规、中文合同。比 Cursor/Copilot 少一整层跨境数据合规评估 |
| 私有部署选项 | CodeGeeX 支持完全离线部署——有 GPU 就能跑,代码完全不出网 |
wescode 的技术选择
wescode 是国产工具——也有自己的不足(社区生态在建设中、用户基数还小)。但在上述五个瓶颈上做了不同的技术选择:
| 维度 | 主流做法 | wescode 的做法 | 代价 |
|---|---|---|---|
| 代码理解 | Embedding 向量搜索 | CKG 调用图(tree-sitter 解析确定性调用关系) | 首次索引需要几秒到几分钟 |
| 约束检查 | 依赖 ESLint 等静态规则 | CSE 约束满足引擎(13 个 Checker 从代码推导项目级规矩) | 统计推断有少量误报 |
| 行为验证 | 测试通过即完成 | L2.5 行为基线(对比重构前后的可观测行为) | 增加验证耗时 |
| 模型选择 | 绑定自家模型 | BYOK(按场景选最合适的模型) | 用户需自行管理 API Key |
| 代码安全 | 代码经工具方服务端 | CKG 本地分析 + BYOK 直连(代码不经 wescode 服务器) | 无法提供云端增值功能 |
这些选择不是"我们比别人好"——每种方案都有代价,上表第四列已列出。国产模型赶上来之后,BYOK 用户立刻受益。
常见问题
Q1:这些瓶颈多久能补上?
Agent 自主性和跨文件理解高度依赖底层模型能力,取决于通义千问、GLM 等何时在代码推理上追上 Claude/GPT,预计 1-2 年内会有明显进步。但 CKG 和 CSE 是架构决策不是模型能力——想补需要从索引方案重新设计,不是"加一个功能"的事。具体来说,CKG 需要集成 tree-sitter 解析器、设计 10-Pass 索引管线、构建关系图数据库;CSE 需要定义约束描述语言和 13 类 Checker——这些是几个月到一年的工程投入。
Q2:数据合规要求严格怎么选?
按严格程度排序:代码不出内网 → CodeGeeX 私有部署(代价是功能简单、Agent 弱);代码不经工具方 → wescode BYOK 直连(CKG 索引在本地,只有提问时才把精选片段发给模型);数据存储国内 → 通义灵码 / Trae(对大多数企业够用)。如果你的安全审计团队要求"代码不能出现在任何第三方服务器",只有 CodeGeeX 私有部署和 wescode BYOK 能满足——前者模型在你的机房,后者请求直达你选的模型 API 不经中间节点。
Q3:个人开发者该选谁?
10 万行以内的个人项目,通义灵码或 Trae 是最务实的选择——免费、中文好、补全够用。做大型项目、多人协作、或进入合规行业时,跨文件理解和模型灵活性的瓶颈会变得明显——那时候再考虑 wescode 或 Cursor 也不迟。如果你两边都想试,wescode 基于 VS Code Fork,插件和设置全兼容——迁入迁出成本接近零。
Q4:wescode 免费吗?
wescode 本身免费(VS Code Fork,插件和主题全兼容),模型费用取决于你选的 BYOK 提供商。用 DeepSeek-V3 做日常补全,月费通常在几十元以内。CKG/CSE/L2.5 全部在本地 CPU 运行,不产生额外费用。和 Cursor Pro $20/月对比:如果你日均用量中等,BYOK 按量付费通常更便宜;如果你重度使用(日均数百次补全),Cursor Pro 的固定费率可能更划算。
Q5:CKG 和 Embedding 索引能共存吗?
可以。CKG 解决的是确定性结构关系(谁调用了谁、谁实现了哪个接口),Embedding 解决的是语义相似度("这段代码和那段代码讲的是类似的事")。理论上两者互补。wescode 目前以 CKG 为主索引——因为在"找全受影响的文件"这个任务上,确定性调用图的准确率(100%)远高于 Embedding 搜索(约 40-60%)。语义搜索在知识库问答、文档检索等场景更有价值,但代码重构需要的是精确关系。
当前 AI 编程工具在补全和中文理解上已经做得很好,瓶颈集中在"项目级深度理解"上。对大多数日常编码,这些瓶颈不影响使用。