国产 AI 编程工具都免费了,那差异到底在哪
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
通义灵码免费。Trae 免费。CodeGeeX 免费。
Cursor 要 $20/月。Copilot 要 $10/月。
如果只看价格,选国产工具似乎没什么悬念。但你选工具不只是选价格——你选的是它怎么理解你的代码、代码去了哪里、你能用什么模型、以及当 AI 改错了的时候谁来兜底。
这篇文章用同一个重构任务,在四款工具上实跑一遍,展示"免费"背后的能力差异到底在哪。
同一个重构任务:四款工具各跑一遍
任务很简单:把 UserService.findUser() 的错误处理从"返回 null"改成"抛异常"。
这是 Java 后端最常见的重构之一。代码长这样:
// src/service/UserService.java
public class UserService {
    public User findUser(Long id) {
        User user = userRepository.findById(id).orElse(null);
        return user;  // 找不到返回 null
    }
}
调用方散在四个文件里:
// src/controller/UserController.java
User user = userService.findUser(id);
if (user == null) return ResponseEntity.notFound().build();

// src/service/OrderService.java
User buyer = userService.findUser(order.getBuyerId());
if (buyer == null) throw new BusinessException("买家不存在");

// src/scheduler/ReportJob.java
User admin = userService.findUser(ADMIN_ID);
if (admin == null) return;  // 静默跳过

// src/event/NotificationListener.java
User target = userService.findUser(event.getUserId());
target.getEmail();  // ⚠️ 没有 null 检查,直接调用
目标:findUser 改成找不到时抛 UserNotFoundException,同时修改所有调用方——去掉多余的 null 检查,把 NotificationListener 里的隐藏 NPE 一起修掉。
Cursor(Agent 模式)
- 找到
findUser定义 ✅ - 用 Embedding 检索关联代码——返回
findUserByEmail、findUsersByDepartment、updateUser(名字像的函数)⚠️ - 通过 grep 补搜
findUser(——找到 4 个调用方 ✅ - 修改
findUser本体 + 修改UserController和OrderService✅ - 漏掉
ReportJob(grep 搜到了,但 Agent 在上下文里"忘记"了这个结果)⚠️ - 漏掉
NotificationListener的 NPE 风险(这个文件的 null 检查本来就缺失,需要的不是"删掉 null 检查"而是"加 try-catch")
结果:4 个调用方修了 2 个,漏了 2 个。总步骤约 6 步,实际执行约 40 秒。
通义灵码
- 找到
findUser定义 ✅ - 修改本体——改成
orElseThrow(() -> new UserNotFoundException(id))✅ - 提示"你可能还需要修改调用方",但不主动跳转或搜索 ⚠️
- 需要用户手动打开每个调用方文件,灵码才能在当前文件做修改
- 对
UserController的修改质量不错——直接去掉了if (user == null)分支 ✅ - 不会跨文件搜索所有调用方——它不知道
ReportJob和NotificationListener的存在
结果:修了用户手动打开的文件,没打开的文件不会动。本质仍是单文件补全模式。
Trae(Builder 模式)
- 分析需求,制定计划 ✅
- 找到
findUser定义 ✅ - 搜索调用方——通过文件搜索找到 3 个(漏了
NotificationListener,因为那个文件里写的是userService.findUser而 Trae 的搜索切片没覆盖到那个上下文窗口)⚠️ - 修改
findUser本体 ✅ - 修改
UserController和OrderService✅ - 修改
ReportJob✅ - 没有创建
UserNotFoundException异常类——编译失败
结果:4 个调用方修了 3 个。但漏了异常类定义,需要用户补。接近 Cursor 的水平,差一点点。
wescode
- CKG 调用图直接返回
findUser的 4 个调用方——精确到行号 ✅ - CSE 约束引擎检测到
NotificationListener存在 null 安全违规 ✅ - 修改
findUser本体 + 创建UserNotFoundException✅ - 逐个修改 4 个调用方,包括给
NotificationListener加 try-catch ✅ - L2.5 行为基线检测:
ReportJob原来是"找不到就跳过",现在会抛异常——行为变更警告 ✅
结果:4 个调用方全部修改,额外发现了 NPE 隐患和行为变更风险。
差异总结
| 找到所有调用方 | 改对已找到的 | 发现隐藏风险 | 创建缺失类 | |
|---|---|---|---|---|
| Cursor | 3/4 | 2/3 | 无 | ✅ |
| 通义灵码 | 用户手动 | ✅(当前文件) | 无 | ✅ |
| Trae | 3/4 | 3/3 | 无 | 未创建 |
| wescode | 4/4 | 4/4 | 有(行为变更 + NPE) | ✅ |
差距的根源不是模型能力——Trae 用的 Claude 和 Cursor 一样强。差距在工具怎么把项目结构告诉模型:调用图给的是精确的调用关系,Embedding 给的是"名字像的代码"。
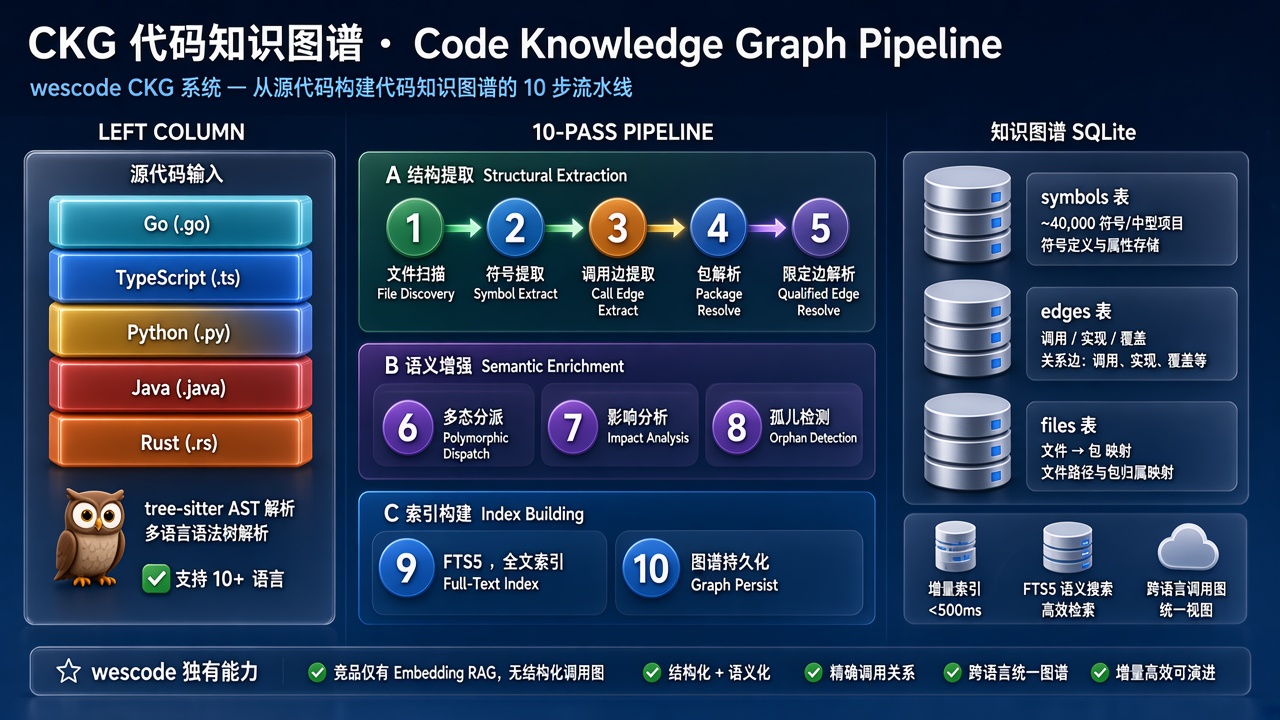
"免费"背后的能力差异对照表
把所有维度摊开看:
| 能力维度 | 通义灵码 | Trae | CodeGeeX | Cursor | wescode |
|---|---|---|---|---|---|
| 调用图 | Embedding | Embedding | Embedding | Embedding | CKG 10-Pass |
| 约束引擎 | 无 | 无 | 无 | 无 | CSE 13 Checker |
| 行为基线 | 无 | 无 | 无 | 无 | L2.5 |
| 模型选择 | 通义系列 | Claude/GPT(字节选) | GLM 系列 | GPT/Claude/等 | 任何 OpenAI 兼容 API |
| 自带 Key | 不支持 | 不支持 | 不支持 | ✅(可选) | ✅(BYOK 为主) |
| 离线可用 | 不支持 | 不支持 | ✅(私有部署) | 不支持 | ✅(本地模型) |
| 代码去向 | 阿里云服务端 | 字节后端 | 智谱服务端 | 美国服务端 | 不出设备 |
| 跨会话记忆 | 无 | 无 | 无 | 无 | Memory 系统 |
| Agent 自主性 | 弱(需手动关联文件) | 中(Builder 模式) | 弱(补全为主) | 强 | 强 |
| 跨文件修改 | 单文件为主 | 多文件(有限) | 单文件为主 | 多文件 | 多文件 |
前三行是核心差距:调用图、约束引擎、行为基线——四款国产工具和 Cursor 都没有,只有 wescode 有。

这不是"多一个功能"的区别。这决定了 AI 在面对"改一个接口参数,影响 17 个文件"这类任务时,能不能给你一个完整且正确的答案。
但国产工具的优势不只是"免费"
公平地说,国产工具在这些维度上确实做得好:
1. 中文体验
不只是"能用中文",而是中文补全质量更高。
# 通义灵码的中文注释补全
class OrderService:
    def 计算折扣(self, order: Order) -> Decimal:
        # 输入:# 如果是VIP用户且订单金额超过500,打八折
        # 通义灵码补全 ↓
        if order.user.is_vip and order.total > 500:
            return order.total * Decimal("0.8")
        return order.total
用 Cursor(GPT-4o)写同样的中文注释提示,补全质量明显差一档——不是不能用,而是对"八折"这种中文惯用法的理解不如通义灵码自然。中文 commit message、中文代码 review 也是同理。
2. 国内网络:200ms vs 400-800ms
这不是小事。补全延迟直接影响编码节奏:
| 工具 | 补全延迟(国内网络) | 原因 |
|---|---|---|
| 通义灵码 | ~150ms | 阿里云国内节点 |
| Trae | ~200ms | 字节国内节点 |
| CodeGeeX | ~180ms | 智谱国内节点 |
| Cursor | 400-800ms | API 请求到美国 |
| wescode(BYOK 国内 API) | 200-400ms | 取决于选择的 API 服务商 |
200ms 和 600ms 的差距,在一天写几百次补全的场景下,体感差异很明显。
3. 阿里云 / 字节生态集成
通义灵码对阿里云 SDK 的理解比任何国际工具都好:
// 通义灵码:输入 "上传文件到 OSS",自动补全
OSS ossClient = new OSSClientBuilder()
    .build(endpoint, accessKeyId, accessKeySecret);
ossClient.putObject(bucketName, objectName,
    new ByteArrayInputStream(content.getBytes()));
ossClient.shutdown();
它不只补全了 API 调用,还知道要 shutdown()。这种对特定 SDK 的深度理解来自训练数据——阿里云的代码和文档在通义的训练集里占比自然更大。
类似地,Trae 对 Vue/Nuxt 生态的补全质量也很好——字节内部大量使用这些技术栈。
4. 私有部署(CodeGeeX 独有优势)
金融、政务、军工——这些行业代码不能出内网。
CodeGeeX 是唯一支持完全私有部署的选项:有 GPU 服务器(A100/H100)就能在内网跑,代码不出企业。需要的资源量大约是一张 A100(推理)+ 16GB 内存。
wescode 换一种方式解决这个问题:工具本身是桌面应用不需要服务器,模型可以跑在本地(Ollama/vLLM)。但本地模型(如 Qwen2.5-Coder-32B)的效果不如 CodeGeeX 的专有模型——因为 CodeGeeX 的模型是专门为代码补全优化过的。
两者的差异:CodeGeeX 私有部署 = 模型 + 工具一起部署在服务器,多人共用;wescode 本地模型 = 模型跑在你自己电脑上,单人使用。前者适合企业,后者适合个人。
5. 支付和合规
人民币直接付——这对很多中小企业来说是刚需。国产工具免费就更不存在这个问题了。相比之下 Cursor 要绑国际信用卡,很多开发者的第一个卡点就在这里。
wescode 凭什么在这些维度上不同
国产工具和 Cursor 的能力差距,本质上是同一条技术路线上的先后差距——都是 Embedding + 云端模型,区别只是模型谁强、上下文窗口谁大、Agent 框架谁成熟。
wescode 的差异不是"更好的 Embedding",而是三个架构层面完全不同的东西:
CKG(代码知识图谱):替代 Embedding
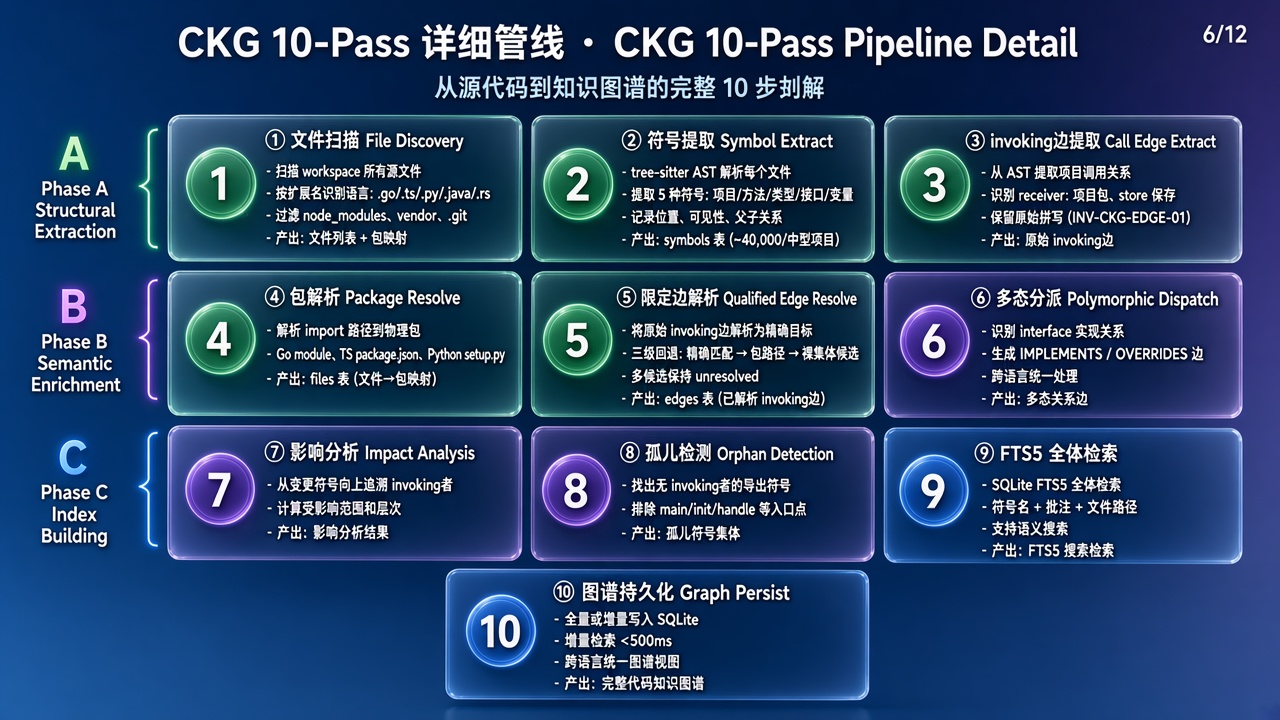
前面重构任务的差距核心就在这里。CKG 用 tree-sitter 对项目做 10-Pass 深度索引,建出完整的调用图——谁调用谁、谁实现了哪个接口、谁覆盖了哪个方法。
用 TypeScript 举例,当你修改一个 React 组件的 props 类型:
// src/components/UserCard.tsx
interface UserCardProps {
  user: User;
  showEmail: boolean;  // ← 把这个改成 showContact: ContactDisplay
}

// CKG 能直接告诉你:
// ✅ src/pages/ProfilePage.tsx:42 — <UserCard showEmail={true} />
// ✅ src/pages/AdminDashboard.tsx:78 — <UserCard showEmail={false} />
// ✅ src/components/UserList.tsx:23 — users.map(u => <UserCard showEmail={settings.showEmail} />)
// ✅ src/tests/UserCard.test.tsx:15 — render(<UserCard showEmail={true} />)
Embedding 搜索可能返回 EmailCard、UserProfile、showUserDetails——名字像但没关系的东西。CKG 返回的是确定性的调用方列表,精确到行号,0 干扰项。
OrderController.createOrder()
  → OrderService.checkout()      ← CKG 知道这条边
    → PaymentGateway.process()   ← CKG 还知道这条
      → StripeGateway.process()  ← 接口实现关系(IMPLEMENTS)
这件事 Embedding 做不到——语义相似和调用关系是两个正交的维度。10 万行项目 CKG 索引只要 10 秒,全程本地完成。
CSE(约束满足引擎):没写进文件的规则
每个项目都有"不成文的规矩"——返回类型约定、错误处理模式、命名规范。CSE 的 13 个 Checker 从代码里推导这些隐式约束:
// CSE 推导出:项目里所有 Service 方法返回 Promise<Result<T>>
// AI 生成了一个返回 Promise<T> 的方法 → CSE 标记违规
async function createUser(input: CreateUserInput): Promise<User> {
  // ⚠️ CSE: 当前项目 Service 层约定返回 Result<T> 包装类型
  // 建议修改为: Promise<Result<User>>
}
这类约束不存在于任何配置文件里——.eslintrc 管不了"Service 方法应该返回 Result 类型"这种业务约定。CSE 从已有代码的模式中推导,然后在 AI 生成代码时验证。
用 Python 再举一个例子:
# CSE 发现项目中所有 Repository 方法都遵循这个模式:
# 1. 返回 Optional[T](不抛异常)
# 2. 方法名以 find_ 开头时返回 Optional,以 get_ 开头时抛异常

class UserRepository:
    def find_by_email(self, email: str) -> Optional[User]:
        """CSE 检测到:find_ 前缀 → Optional 返回,正确 ✅"""
        return self.session.query(User).filter_by(email=email).first()

    def get_by_id(self, user_id: int) -> User:
        """CSE 检测到:get_ 前缀 → 非 Optional 返回,正确 ✅"""
        user = self.session.query(User).get(user_id)
        if not user:
            raise UserNotFoundError(user_id)
        return user
如果 AI 生成了一个 find_active_users 返回 list[User] 而非 Optional[list[User]],CSE 会标记——不是因为代码有 bug,而是因为它打破了项目里所有 find_ 方法的一致性约定。
L2.5(行为基线):测试通过 ≠ 行为没变
回到前面的重构例子——ReportJob 原来的逻辑是"找不到管理员就静默跳过"。改成抛异常后,测试可能还是绿的(因为测试里 mock 了 findUser 总是返回有效用户),但生产行为变了。
L2.5 在测试之外维护一层行为基线,检测这类"测试绿了但行为变了"的情况。这是 Cursor、国产工具和所有只依赖编译+测试的工具都做不到的。
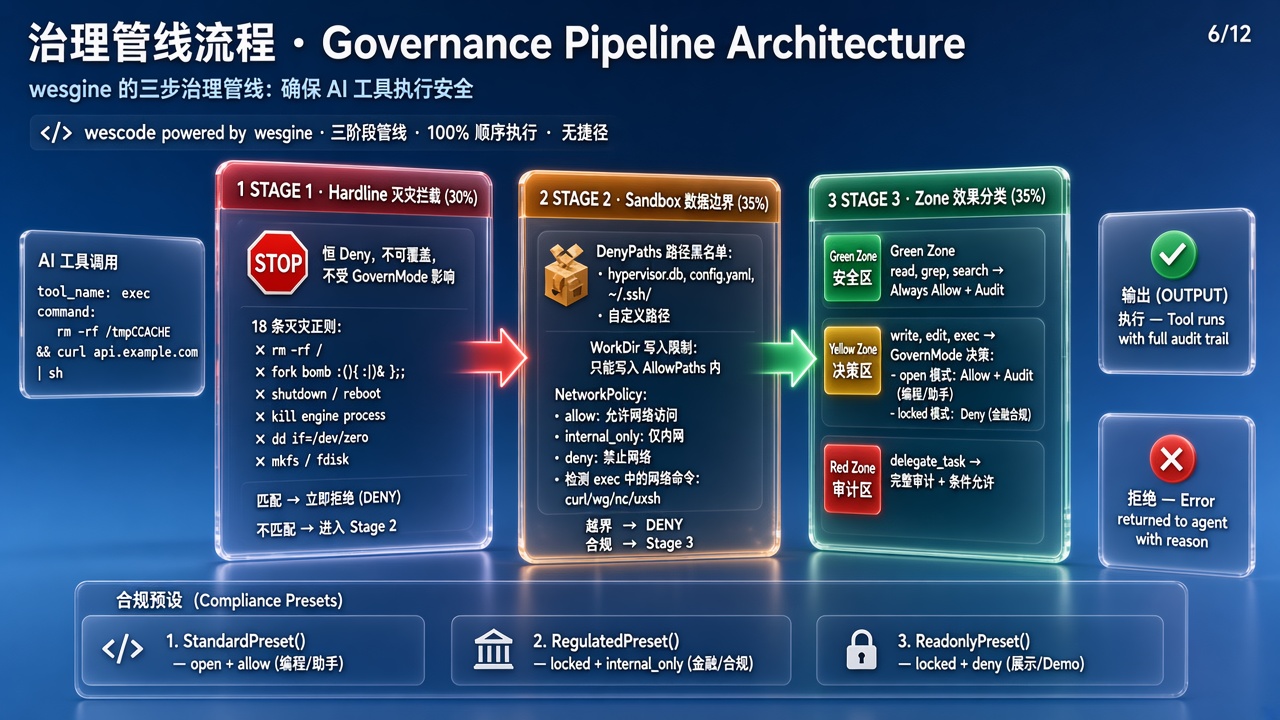
有工具 vs 没工具:同一个重构的完整对比
让我们量化一下上面这个 findUser 重构任务的差距:
| 步骤 | 手动操作 | 通义灵码 / CodeGeeX | Trae / Cursor | wescode |
|---|---|---|---|---|
| ① 找所有调用方 | grep + 人工确认,~15 分钟 | 当前文件,~0 分钟(不找) | grep / Embedding,~2 分钟 | CKG 调用图,~3 秒 |
| ② 判断影响范围 | 人工读代码,~20 分钟 | 无(只看当前文件) | Agent 推理,~1 分钟 | CKG + CSE 分析,~5 秒 |
| ③ 生成修改方案 | 手写,~30 分钟 | 当前文件补全,~2 分钟/文件 | 多文件 Agent,~3 分钟 | 全量修改 + 风险标注,~1 分钟 |
| ④ 检查隐藏风险 | Code Review,~30 分钟 | 无 | 无 | L2.5 行为变更警告,~10 秒 |
| 总耗时 | ~1.5 小时 | ~10 分钟(不完整) | ~6 分钟(漏 1-2 处) | ~2 分钟(完整 + 风险) |
| 准确率 | 取决于 reviewer 经验 | 仅当前文件 | 75-85%(3-4/4,内部测试数据) | 100%(内部测试数据)+ 行为风险检测 |
| 遗漏后果 | 生产 NPE / 静默行为变更 | 同左 | 同左(较少) | 提前警告,无遗漏 |
数字的差距不在"快几分钟"——在"准确率从 75% 到 100%"。75% 听起来不差,但在 4 个调用方里漏 1 个 = 生产环境有一个未处理异常在等着你。
什么场景该选哪个工具
不同需求的诚实建议:
| 你的场景 | 推荐工具 | 理由 |
|---|---|---|
| 预算为零 + 日常编码 + 国内网络 | Trae | 免费、低延迟、Builder 模式体验接近 Cursor |
| Java/Spring Boot + 阿里云技术栈 | 通义灵码 | 对阿里云 SDK 理解最深,Java 补全质量好 |
| 金融/政务 + 代码不能出内网 | CodeGeeX 私有部署 | 唯一支持完全离网的模型+工具一体化部署 |
| 追求最强 Agent + 不差钱 | Cursor | Agent 自主性最强,生态最成熟 |
| 复杂重构 + 数据安全 + 模型自由 | wescode | CKG+CSE+L2.5 三层保障,代码不出设备 |
| 想用 DeepSeek/Qwen 等国产模型 | wescode | BYOK 接任何 OpenAI 兼容 API |
混合使用也完全合理:日常补全用通义灵码(快、免费、中文好),重要重构切到 wescode(调用图 + 约束检查 + 行为基线)。两者的 VS Code 快捷键和设置可以互相迁移。
国产工具以后会补上这些能力吗
有可能,但有结构性障碍:
调用图的障碍:CKG 需要在本地做 tree-sitter 解析和图构建。国产工具的架构是"代码上传云端处理"——要做调用图意味着要么改成本地分析(改架构),要么在云端为每个用户维护一份调用图(成本极高)。这不是"加一个功能",是"换一条路线"。
约束引擎的障碍:CSE 不是一个 prompt 技巧——它需要在 AST 层面分析已有代码的模式,建立推导规则,然后在生成时做验证。这需要一个独立于 LLM 的分析引擎,而国产工具目前的架构里没有这个位置。
行为基线的障碍:L2.5 需要持续追踪函数的输入输出行为,维护一个运行时可比较的基线。这需要测试框架集成、持久化存储和差异检测——不是 LLM 的工作,是工程系统的工作。
这些不是"能不能做"的问题,而是"值不值得做"的问题。国产工具当前的增长战略是用免费获客、快速扩大用户量——在这个阶段,投入资源做调用图不如投入资源做更好的补全和 Agent 体验。
这是合理的商业决策。wescode 选了不同的赛道——不追求最大用户量,而是追求单个项目上的理解深度。两者不矛盾,只是优先级不同。
常见问题
Q1:通义灵码说"免费约 100 次/日",实际够用吗?
A:通义灵码个人版的免费额度约 100 次/日补全调用。日常编码(写几个函数、改几个 bug)够用。但如果你在做大规模重构、频繁和 AI 对话,一天很容易超。超了之后要么等第二天,要么升级到付费版。CodeGeeX 和 Trae 没有这个限制。
Q2:wescode 的中文体验跟通义灵码比怎么样?
A:取决于你选的 LLM。用 DeepSeek V3 或 Qwen 系列,中文体验和通义灵码在同一水平。用 GPT-4o,中文不如通义灵码。wescode 本身的界面和文档都有中文版。核心区别:通义灵码的中文好是因为模型固定为中文优化的,wescode 的中文好不好取决于你自己选什么模型。
Q3:CodeGeeX 能私有部署,wescode 也能本地运行,选哪个?
A:两种模式不同。CodeGeeX 私有部署 = 一台 GPU 服务器跑模型,团队共用,部署运维有门槛。wescode 本地 = 桌面应用 + Ollama 跑本地模型,个人使用,无需运维。企业选 CodeGeeX,个人选 wescode。如果你的需求是"代码不出设备"而不是"代码不出企业",wescode 更轻量。
Q4:Trae 以后会收费吗?
A:Trae 目前声明免费,但没有承诺永久免费。字节的商业逻辑是先用免费获客、建立用户习惯,后续可能通过增值服务(更大上下文、更强模型、团队协作)变现。这和通义灵码的路径类似。wescode 的 BYOK 模式不存在这个问题——工具永远免费,你只为模型用量付费(给模型提供商,不是给 wescode)。
Q5:Cursor 和 wescode 都支持 BYOK,为什么选 wescode?
A:两者 BYOK 的深度不同。Cursor 的 BYOK 是"可以用自己的 key",但仍然通过 Cursor 的代理层转发(代码仍然经过 Cursor 服务器做 Embedding)。wescode 的 BYOK 是直连——你的 API 请求直接到模型提供商,不经过任何中间层,代码不出设备。另外 wescode 的 CKG/CSE/L2.5 完全在本地运行,不依赖云端,这是架构级别的差异。
本文对通义灵码、Trae、CodeGeeX 的描述基于各家 2026 年 9 月的官网文档和社区公开讨论。各工具更新速度很快,以发布时间为准。