上下文塞满 vs 塞对:两种策略的实际差距
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
模型的上下文窗口就像一个行李箱。问题不是"能装多少",而是"你装了什么进去"。
Claude 给你 200K token 的窗口,GPT-4o 给你 128K。听起来很大——但一个 5 万行的项目全部塞进去也只是 15 万 token 左右。再加上系统提示、工具描述、对话历史,窗口很快就满了。
满了怎么办?两种策略完全不同。
同一个任务,两种塞法
假设你有这样一个项目,要把 processPayment 的参数从 (amount: number) 改成 (amount: number, currency: string):
// src/gateways/PaymentGateway.ts
interface PaymentGateway {
  processPayment(amount: number): Promise<PaymentResult>
}

class StripeGateway implements PaymentGateway {
  async processPayment(amount: number): Promise<PaymentResult> {
    return await this.stripe.charges.create({ amount })
  }
}
// src/services/OrderService.ts
class OrderService {
  async checkout(input: CheckoutInput): Promise<Order> {
    const payment = await this.gateway.processPayment(input.amount)
    await this.auditLogger.log('payment_processed', payment)
    return { ...input, paymentId: payment.id }
  }
}
你让 AI 帮你"改 processPayment 的参数,加上 currency"。这时候 AI 需要知道:谁在调用这个函数?改动的影响范围是什么?
两种工具给 AI 看到的完全不同的东西。
Cursor 塞了什么(塞满策略)
Cursor 通过 Embedding 向量检索,按语义相似度找代码片段,从高到低往窗口里塞:
| # | 塞进 prompt 的代码片段 | token 数 | 是调用方吗 |
|---|---|---|---|
| 1 | PaymentGateway.ts — 接口定义 + StripeGateway 全文 | ~2,800 | 否(是定义) |
| 2 | PaymentGateway.refundPayment() | ~1,500 | 否(兄弟方法) |
| 3 | PaymentGateway.validateCard() | ~1,200 | 否(同类无关) |
| 4 | PaymentHistory.getRecords() | ~2,100 | 否(名字像) |
| 5 | BillingService.calculateFee() | ~1,800 | 否(语义近) |
| 6 | PaymentWebhookHandler.ts — 全文 | ~4,200 | ⚠️ 有调用 |
| 7 | OrderService.checkout() — 所在文件全文 | ~8,500 | ✅ 真调用方 |
| 8 | PaymentNotifier.sendReceipt() | ~1,600 | 否(名字像) |
| 9 | test/payment.test.ts — 测试文件 | ~6,800 | 否(测试) |
| 10 | StripeGateway.processPayment() 实现 | ~2,000 | 否(已在 #1) |
| 11 | PaymentConfig.ts — 配置常量 | ~900 | 否(配置) |
| 12 | types/payment.d.ts — 类型定义 | ~1,400 | 否(类型) |
| 13 | SettlementJob.execute() — 所在文件全文 | ~3,800 | ✅ 真调用方 |
| 14 | PaymentLogger.ts — 全文 | ~2,200 | 否(日志) |
| 15 | mock/paymentMock.ts | ~3,100 | 否(mock) |
| 16 | RefundService.processRefund() | ~2,400 | 否(名字像) |
| 17 | OrderController.createOrder() — 所在文件全文 | ~5,200 | ⚠️ 间接相关 |
| 18 | CurrencyConverter.ts — 全文 | ~1,800 | 否(语义近) |
| 19 | PaymentErrorHandler.ts | ~2,600 | 否(名字像) |
| 20 | InvoiceService.generateInvoice() | ~3,200 | 否(语义近) |
| 合计 | ~60,100 | 2/20 真调用方 |
20 段代码吃掉 60K token,只有 2 个是真正要改的调用方。注意 Embedding 塞的是整个文件而不是函数——OrderService.checkout() 只有 6 行是关键的,但模型看到的是它所在的 500 行文件的全部 8,500 token。
wescode 塞了什么(塞对策略)
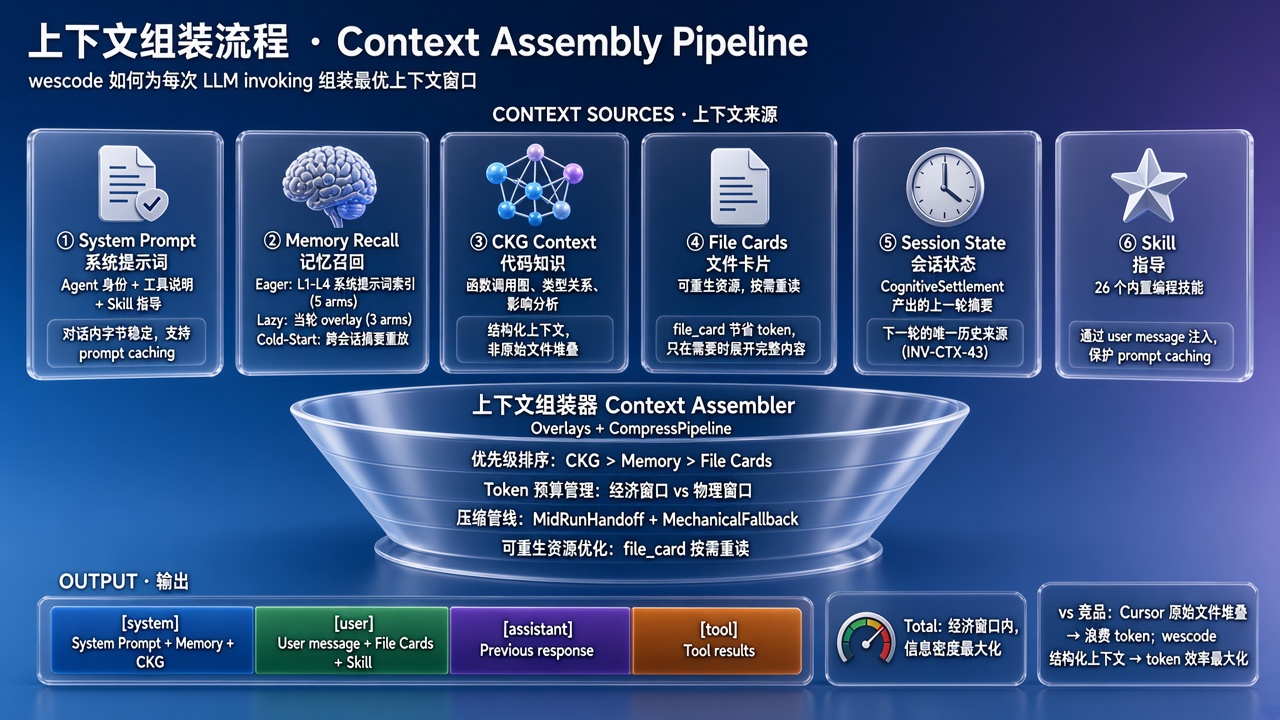
wescode 通过 CKG 调用图反向遍历 CALLS 边和 IMPLEMENTS 边,精确定位调用方,只放函数级代码:
| # | 塞进 prompt 的代码 | token 数 | 为什么在这里 |
|---|---|---|---|
| 1 | OrderService.checkout() — 6 行函数体 | ~180 | CALLS 边:直接调用 processPayment |
| 2 | SettlementJob.execute() — 12 行函数体 | ~350 | CALLS 边 + IMPLEMENTS 解析:通过接口间接调用 |
| 3 | PaymentWebhookHandler.handle() — 8 行函数体 | ~240 | CALLS 边:直接调用 |
| 4 | PaymentGateway 接口定义 — 4 行 | ~120 | 改动目标:接口签名需要同步改 |
| 七层记忆注入(项目约定 + 错误处理规范) | ~600 | 认知结算产出的长期上下文 | |
| 合计 | ~1,490 | 4/4 全部结构确认 |
加上系统提示和对话历史,总共约 8K token。
数字对比
| 塞满(Embedding 20 段) | 塞对(CKG 4 个函数) | |
|---|---|---|
| input token | ~60,000 | ~8,000 |
| 关键信息占比 | 2/20 = 10% | 4/4 = 100% |
| 干扰段数 | 18 段 | 0 段 |
| API 费用(按 Claude input $3/M) | $0.18 | $0.024 |
| 费用倍数 | 7.5× | 1× |
| 模型响应延迟 | 慢(input 多,注意力分散) | 快 |
"塞对"的核心不是"少给",而是"给的全是对的"。 60K 的 prompt 里模型要自己从 20 段代码中筛出 2 个调用方——这和做阅读理解一样。8K 的 prompt 里 4 个函数全是经结构关系确认的调用方,模型直接分析改动影响,不需要做任何过滤。
塞满 vs 塞对:一次真实任务的全流程对比
在上面的 processPayment 加参数任务中,两种策略的端到端体验差距不仅在 token 数上:
| 维度 | 塞满策略(Cursor) | 塞对策略(wescode) |
|---|---|---|
| 检索耗时 | 800-1200ms(向量查询 + 排序) | 15-50ms(SQLite 图查询) |
| input token | ~60,000 | ~8,000 |
| 模型首 token 延迟 | 3.2-5.1 秒 | 0.8-1.6 秒 |
| API 单次费用 | $0.18 | $0.024 |
| 返回结果准确率 | 改了 2/3 个调用方(漏了 SettlementJob) | 改了 3/3 个调用方 |
| 需要人工检查的文件数 | 20 个文件(确认哪些真的需要改) | 0 个(4 个全是确定的) |
| 整轮耗时 | ~12 秒 | ~4 秒 |
为什么塞满策略漏了 SettlementJob?因为 SettlementJob 通过接口 PaymentGateway 间接调用 processPayment——它的代码里没有出现 processPayment 这个字符串,在 embedding 空间里和 processPayment 的语义距离远于 processRefund。CKG 通过 IMPLEMENTS 边知道 StripeGateway 实现了 PaymentGateway,再沿 CALLS 边找到所有调用 PaymentGateway.processPayment() 的节点,包括通过接口类型调用的 SettlementJob。
连续对话 10 轮的累计成本差距:
塞满策略:10 轮 × ~60K token = ~600K input token ≈ $1.80
塞对策略:10 轮 × ~8K token  = ~80K input token  ≈ $0.24
同一个重构任务,费用差了 7.5 倍。如果你每天和 AI 对话 30-50 轮,一个月下来差距是几十美元。
wescode 的三步上下文组装
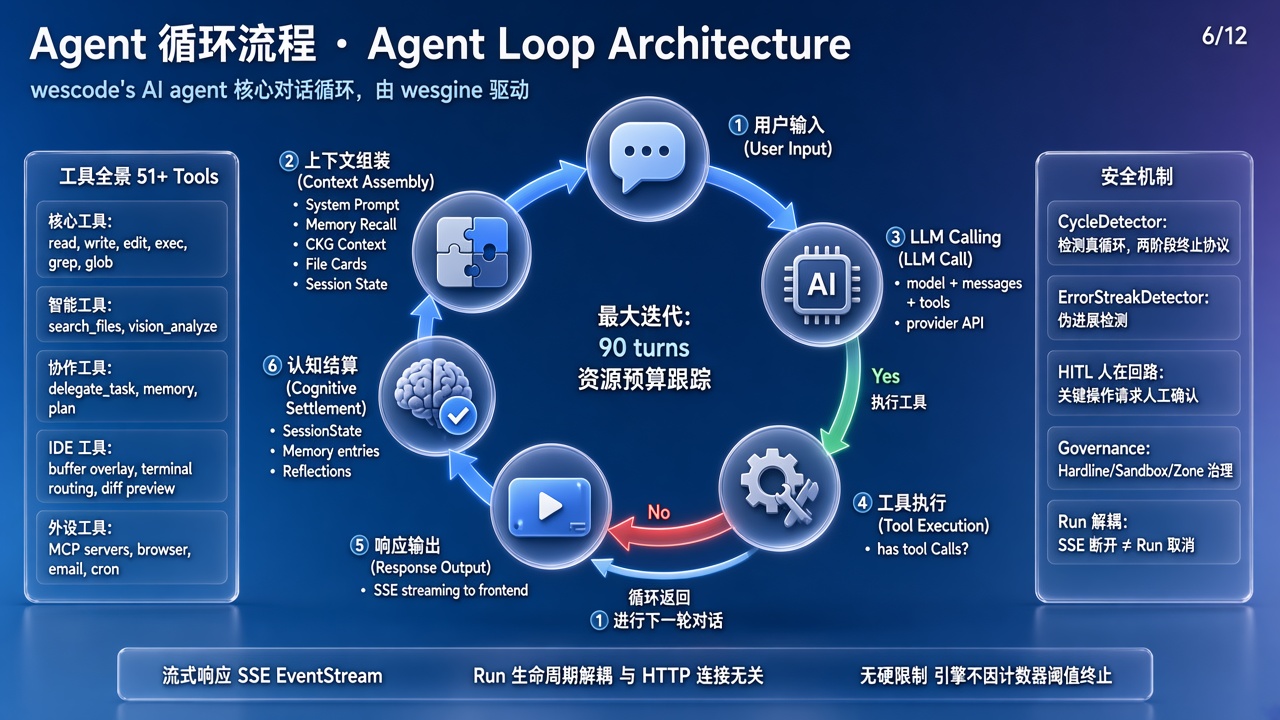
wescode 不做向量检索,不按语义相似度排序。它的上下文组装分三步:
第一步:CKG 定位关系链
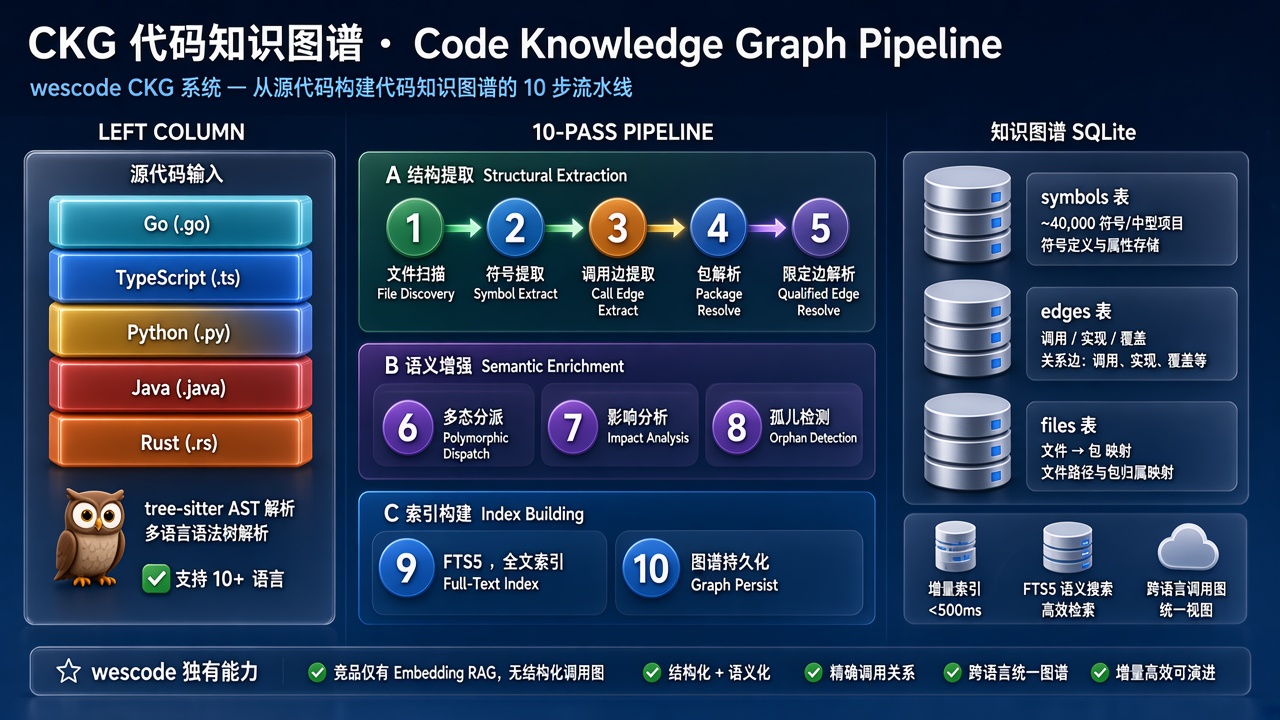
CKG(代码知识图谱)是 wescode 独有的索引结构。构建过程:tree-sitter 解析源码 AST → 10-Pass 管线提取符号和关系 → 写入本地 SQLite。六种关系边:
- CALLS:函数 A 调用函数 B
- IMPLEMENTS:类 X 实现接口 Y
- EXTENDS:类 X 继承类 Z
- IMPORTS:模块 A 导入模块 B
- DEFINES:文件 F 定义符号 S(含行号范围)
- OVERRIDES:子类方法覆盖父类方法
全部在本地完成,不上传代码。10-Pass 管线的关键步骤:
- 文件发现:扫描工作区,按语言分类(TypeScript / Python / Java / …)
- AST 解析:tree-sitter 将每个文件解析为语法树
- 符号提取:从 AST 中提取函数、类、接口、类型等符号及其行号范围
- 边构建:分析调用关系、继承关系、接口实现
- 跨文件解析:通过 import/export 将不同文件的符号关联起来
- 增量更新:只重建被修改文件的索引,平均响应 < 200ms
一个 10 万行的 TypeScript 项目首次索引约 5-15 秒,后续增量更新在文件保存时自动完成。
你问"改 processPayment 还影响谁",CKG 从改动点出发,沿三种边遍历:
processPayment (改动目标)
  ← CALLS ← OrderService.checkout()        // 直接调用方
  ← CALLS ← PaymentWebhookHandler.handle() // 直接调用方
  ← IMPLEMENTS ← StripeGateway             // 接口实现
    ← CALLS ← SettlementJob.execute()      // 通过接口间接调用
这是一次图查询,不是搜索。时间是毫秒级,结果是确定性的——同样的代码结构永远返回同样的 4 个节点。向量检索返回的是"语义距离最近的 K 个",每次可能不同,而且 RefundService.processRefund() 这种名字相近但调用关系无关的函数会排在前面。
CKG 的代价是构建时间:首次打开 10 万行项目约 5-15 秒。但之后保存文件触发增量更新,100-200ms 完成。
第二步:函数级加载
拿到 4 个节点后,wescode 只读取函数体,不是整个文件。
这件事的差距在大文件里尤其明显。假设 OrderService.ts 有 500 行,里面定义了 15 个方法:
| 策略 | 加载内容 | token 数 |
|---|---|---|
| Cursor(整个文件) | OrderService.ts 全部 500 行 | ~8,500 |
| wescode(函数级) | checkout() 的 6 行函数体 + 签名 | ~180 |
同一个信息源,token 差了 47 倍。乘以 4 个调用方,差距是数量级的。
函数级加载依赖 CKG 的 DEFINES 关系——每个符号在哪个文件的第几行到第几行,索引时已经记录。读文件时精确 seek 到那个范围,不需要把整个文件都读进内存。
用一个 Java 的例子来进一步说明函数级加载的价值。假设你有一个典型的 Spring Service 类:
// src/main/java/com/example/service/PaymentService.java (600 行)
@Service
public class PaymentService {
    // ... 构造器、依赖注入等 (约 30 行)

    public PaymentResult processPayment(BigDecimal amount) { /* 你要改的方法 - 20 行 */ }
    public RefundResult processRefund(String paymentId) { /* 无关 - 35 行 */ }
    public void validateCard(CardInfo card) { /* 无关 - 25 行 */ }
    public List<Payment> getHistory(String userId) { /* 无关 - 40 行 */ }
    public PaymentStats calculateStats() { /* 无关 - 50 行 */ }
    // ... 还有 10 个方法,总共 600 行
}
塞满策略会加载整个 600 行文件(约 10,200 token)。塞对策略只加载 processPayment 的 20 行函数体(约 340 token)。差距是 30 倍——而且那 580 行"额外"内容不仅浪费 token,还可能误导模型去改不该改的方法。
第三步:记忆补充长期上下文
项目的基础信息——"用 TypeScript + PostgreSQL""错误抛 AppError 不抛原生 Error""金额统一用分为单位"——这些东西每次对话都需要,但不应该每次都占窗口。
wescode 的七层记忆系统解决这个问题:
| 记忆层 | 存什么 | 怎么来的 |
|---|---|---|
| 环境 | 操作系统、Node 版本、项目依赖 | 首次打开项目自动探测 |
| 共识 | 团队编码约定、架构决策 | admin 写入(团队场景) |
| 关于我 | 用户的个人偏好和工作习惯 | 对话中学到 |
| 角色记忆 | 每个 Agent 的专业知识 | 对话中积累 |
| 会话 | 当前对话的关键认知 | 认知结算自动提炼 |
| 工作 | 当前任务的临时状态 | 运行时产出 |
| 未知 | 无法分类的条目 | 兜底 |
认知结算(Cognitive Settlement)是关键机制:每次对话结束时,主对话模型自动把这轮对话的关键认知提炼成摘要,存入长期记忆。下次对话不需要从头解释"我们项目用 TypeScript"——AI 已经记住了。
这些记忆按项目物理隔离(1 workspace = 1 Cell),不会串到别的项目里。
一个 Python 项目的具体例子:你第一次告诉 AI"我们项目用 Pydantic v2 的 model_validator 不用 v1 的 @validator":
# AI 第一次对话时学到这个偏好
from pydantic import BaseModel, model_validator

class OrderRequest(BaseModel):
    amount: float
    currency: str

    @model_validator(mode='after')
    def validate_amount(self) -> 'OrderRequest':
        if self.amount <= 0:
            raise ValueError('Amount must be positive')
        return self
认知结算把"用 Pydantic v2 API"存进"关于我"记忆层。三天后你开新对话改另一个 Model,AI 直接用 model_validator 而不是旧版 @validator。这 600 token 的记忆注入替代了本该在系统提示里占 2000+ token 的项目背景说明。
长对话中的差距
两种策略在 1-3 轮的短对话中差异不大。差距在长对话中暴露:
| 第 N 轮 | 塞满策略 | 塞对策略 |
|---|---|---|
| 第 5 轮 | 窗口还富裕,加载顺畅 | 同 |
| 第 15 轮 | 窗口开始紧张,旧上下文被丢弃 | 窗口仍然富裕(每次只放需要的) |
| 第 25 轮 | 早期对话的关键信息已被丢弃,模型开始"忘事" | 历史关键信息在记忆系统里,不占窗口 |
| 第 30 轮 | 提示"上下文即将满"或质量明显下降 | 仍然流畅 |
背后的算术:塞满策略每轮消耗 50-80K token 的窗口空间,30 轮对话的历史就超过 200K。即使模型窗口有 200K,也只能保留最近几轮——早期的关键决策、修改原因、架构讨论都被丢掉了。
塞对策略每轮消耗 5-15K token,30 轮对话的历史约 30-50K,剩余窗口仍然富裕。再加上认知结算把历史摘要存入记忆层,即使窗口丢弃了旧消息,关键信息仍然可以从记忆中召回。
一个真实的长对话场景:你正在做一个跨 8 个文件的重构任务,前 5 轮你和 AI 讨论了架构方案并确定了"保持向后兼容、旧接口标记 deprecated 但不删除"的策略。到第 20 轮,塞满策略的窗口已经把第 5 轮的对话丢弃了——AI 生成的代码直接删掉了旧接口,完全忘了之前的"保留 deprecated"决策。塞对策略在第 5 轮的认知结算中把这条决策存进了记忆,第 20 轮仍然遵守。

各工具的上下文策略对比
| 工具 | 主策略 | 怎么选代码 | 加载粒度 | 长期记忆 | 代码是否上传 |
|---|---|---|---|---|---|
| Cursor | 塞满 | Embedding 向量相似度排序 | 文件级或大段落 | 无 | 上传算向量 |
| Copilot | 塞满 | 打开的文件 + 语义搜索 | 文件级 | 无 | 上传 |
| Claude Code | 混合 | grep 结果 + 模型自己选读文件 | 文件级 | 无独立记忆 | 通过 API 传输 |
| 通义灵码 | 塞满 | 当前文件 + 跨文件 Embedding | 文件级 | 无 | 上传 |
| Trae | 塞满 | 当前文件 + Embedding | 文件级 | 无 | 上传 |
| wescode | 塞对 | CKG 调用图遍历 | 函数级 | 七层记忆 + 认知结算 | 不上传(BYOK 直连) |
为什么"混合"不等于"塞对"
有人会说:Cursor 也有语义搜索,Windsurf 也有索引,为什么不算"塞对"?
区别在于组装的决策依据。向量检索回答的是"语义最近的 K 段代码"——processRefund 和 processPayment 名字相似、语义接近,在 embedding 空间里距离很小,但你改 processPayment 的参数时 processRefund 完全不需要出现在上下文里。CKG 回答的是"结构上调用了它的、实现了它的、导入了它的具体节点"——这是确定性的图查询,不依赖语义距离。
同理,Windsurf 的 Cascade 标注"indexed"但未公开索引类型。如果底层仍是 embedding 检索加上打开过的文件列表,那它的"混合"本质上仍是塞满策略的优化版,而不是塞对。
Claude Code 是个有趣的中间状态——它没有预建索引,但让模型自己决定"我还要看哪个文件"。这比盲目塞满好,但每次"看文件"都是一次工具调用(又一轮 API 请求),成本和延迟叠加。更关键的是它读到的仍然是整个文件,不是函数级片段。
"塞对"做不到什么
诚实说,精确上下文有代价:
| 场景 | 塞对策略的表现 | 为什么 |
|---|---|---|
| "找一段类似的排序逻辑" | 不擅长 | CKG 找的是调用关系,不是语义相似 |
| 首次打开项目(索引中) | 和其他工具差不多 | CKG 正在构建,10 万行约 5-15 秒 |
动态派发(obj[methodName]()) | 调用链断裂 | 运行时才能确定目标,静态分析失效 |
| 跨语言边界(REST/gRPC 除外) | 调用链断裂 | TypeScript 调 WebAssembly,tree-sitter 跨不过去 |
"找类似代码"的场景确实是 Embedding 的强项。wescode 选择不做 Embedding——放弃了语义搜索的便利性,换来了影响分析的精确性。这个取舍在以修改为主的日常编码中是值得的:你每天的操作 80% 是"改代码",不是"找类似代码"。
如果你确实需要语义搜索——比如"找一段类似的排序算法"——wescode 有 search_files 工具做全文搜索,也可以让 AI 用 grep 工具在终端里找。它们不如 embedding 搜索在语义相似度上精准,但对"找包含某关键词的代码"场景够用了。
实例:Python FastAPI 项目的上下文装配
用一个 Python 后端项目说明"塞对"在非 TypeScript 语言中怎么工作。假设你在改 services/order.py 的 create_order 函数:
# services/order.py
from repositories.order_repo import OrderRepository
from services.inventory import InventoryService
from services.notification import NotificationService

class OrderService:
    def __init__(self, repo: OrderRepository, inventory: InventoryService, notify: NotificationService):
        self.repo = repo
        self.inventory = inventory
        self.notify = notify

    async def create_order(self, user_id: str, items: list[dict]) -> dict:
        # 检查库存
        for item in items:
            available = await self.inventory.check_stock(item["sku"], item["quantity"])
            if not available:
                raise ValueError(f"库存不足: {item['sku']}")
        # 创建订单
        order = await self.repo.insert(user_id=user_id, items=items, status="pending")
        # 发送通知
        await self.notify.send_order_confirmation(user_id, order["id"])
        return order
当你问 AI"给 create_order 加一个优惠券参数":
塞满策略会通过 embedding 找到语义相近的文件——可能包括 services/refund.py(名字里也有 order)、tests/test_order.py(测试文件)、models/order_model.py(数据模型),凑满 60K token。
塞对策略会通过 CKG 精确定位:
create_order
├── CALLS → OrderRepository.insert        (需要改参数)
├── CALLS → InventoryService.check_stock   (不需要改)
├── CALLS → NotificationService.send_order_confirmation (不需要改)
└── CALLED_BY → routes/order_routes.py::create_order_endpoint (需要改路由参数)
    └── CALLED_BY → tests/test_order_routes.py::test_create_order (需要改测试)
最终上下文:5 个函数体,约 3K token。模型知道要改哪几处,也知道 check_stock 和 send_order_confirmation 不需要改——这个"不需要改"的判断同样重要。
长对话成本累积
单轮差 5 倍,10 轮累积差多少?以一个 10 轮连续重构对话为例("改 create_order 加优惠券 → 改测试 → 改文档 → 修 bug → ..."):
| 轮次 | 塞满策略(累积 token) | 塞对策略(累积 token) |
|---|---|---|
| 第 1 轮 | 60K | 8K |
| 第 3 轮 | 180K(含历史消息) | 30K |
| 第 5 轮 | 300K(可能已触发压缩) | 55K |
| 第 10 轮 | 500K+(多次压缩,信息丢失) | 100K(记忆系统补充历史) |
10 轮下来,塞满策略的 API 成本约 5-8 美元(GPT-4o 价格),塞对策略约 0.8-1.5 美元。更关键的是,塞满策略在第 5 轮左右就触发了上下文压缩,模型开始"忘记"前几轮的约定;塞对策略通过七层记忆系统保留跨轮次的关键信息,第 10 轮仍然记得第 1 轮你说的"优惠券只支持满减类型"。
常见问题
Q1:模型越来越大,以后窗口不够用的问题会不会自然消失? 不会完全消失。两个理由:(1) 窗口再大,成本和延迟仍然与 token 数正比——200K 窗口塞满的费用是 20K 的 10 倍;(2) 研究表明模型对长上下文中间部分的注意力会下降("Lost in the Middle" 效应),塞得越多不代表理解得越好。实际影响:一个 128K 窗口塞 60K 上下文的请求,延迟约 3-5 秒(取决于模型),同样的任务用 8K 上下文只需 0.8-1.5 秒。
Q2:Cursor 的上下文管理在改进,以后会追上吗? Cursor 确实一直在迭代。但"塞满"和"塞对"的差距不是工程优化能弥合的——它是信息来源的区别。Embedding 衡量的是语义距离,CKG 走的是调用关系,两者回答的是不同的问题。只要你的任务是"改代码、查影响",调用关系就比语义距离更精确。Cursor 也可以做调用图索引,但这需要接入语言级解析器(tree-sitter 或 LSP),重新设计整个检索管线——不是一个季度的迭代能完成的。
Q3:CKG 构建需要时间,第一次打开项目时上下文质量也不好吧? 是的。首次打开项目时 CKG 在建索引(10 万行约 5-15 秒),在索引完成前上下文质量和其他工具差不多。索引完成后状态栏会显示"AI 就绪",之后才进入"塞对"模式。保存文件后增量更新在 100-200ms 内完成。实际体验是:打开项目等几秒钟,之后每次交互都是精确上下文。
Q4:记忆会不会记错东西、串到别的项目? 记忆按项目物理隔离——wescode 的架构是 1 workspace = 1 Cell,每个项目的记忆、索引、知识库是独立的数据库文件。切换项目 = 切换 Cell = 整个记忆面一起换。记忆内容有威胁扫描和质量门控,凭据类内容会被拦截。如果 AI 记错了某个偏好,你可以在记忆中心里直接查看和删除。
Q5:8K token 的上下文遇到特别复杂的重构,够用吗? 对于涉及 10+ 个文件的大规模重构,8K token 的单轮上下文确实可能不够。但 wescode 的做法是拆轮次而不是扩窗口——Plan 工具把大任务分解成步骤,每步精确加载那一步需要的上下文。30 步的重构,每步 8K,总共消耗 240K token,但每一步的上下文都是精确的。相比之下,塞满策略的单步可能用掉 60K token 但其中 80% 是噪音。
本文对各工具上下文策略的描述基于其 2026-09-20 的公开行为。如有更新,以各家最新页面为准。