免费额度的真相:调用次数、降级策略、隐性上限
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
"免费"是 AI 编程工具最有吸引力的标签。但当你真正用起来——写了半天代码突然提示"今日次数已用完",或者发现补全质量莫名下降——你才会意识到:免费额度的设计,决定了你的工作节奏。
这篇文章只聊一个具体问题:主流 AI 编程工具的免费方案到底给了什么、怎么限制的、以及那些文档里不会写明的隐性上限。
一、先摆事实:各家免费额度详细对比
| 工具 | 免费额度 | 限制方式 | 达到上限后 | 付费起步价 |
|---|---|---|---|---|
| Cursor Free | 2000 次补全 + 50 次高级请求/月 | 按次数/月 | 高级请求切慢速模型;补全停止 | $20/月 Pro |
| Copilot Free | 2000 次补全 + 50 次聊天/月 | 按次数/月 | 分别停止,等下月重置 | $10/月 Individual |
| Claude Code | 无免费计划 | API 按量(token) | 余额耗尽即停 | 按 token 计费 |
| Trae | 完全免费(2026 年现状) | 无明确限制 | 高峰期可能排队 | 目前无付费版 |
| 通义灵码 | 个人免费,约 100 次/日 | 按日重置 | 等第二天 | 企业版按团队定价 |
| CodeGeeX | 完全免费 | 无限制 | 无限制 | 无(支持私有部署) |
| wescode | 工具永久免费,无限制 | 工具不限制 | AI 功能按 API 用量付费 | 取决于模型供应商 |
二、Cursor Free 的 2000 次补全到底怎么算
每次 Tab 触发算一次。你在编辑器里写代码,Cursor 自动弹出补全建议,你按 Tab 接受——消耗 1 次。一个活跃的全栈开发者一天大约触发 100-200 次补全,大约 10-20 个工作日就用完了。
50 次高级请求:每次 Chat 对话消耗 1 次。日均 1.7 次——对活跃开发者来说大约只够 2-3 天的集中编码。
用完后不是直接停用,而是降级:高级请求用完切慢速模型,补全用完直接停止。这个"降级而非断供"的策略很聪明:你不会被突然打断,但会持续感到不满——补全变慢、回答质量下降,精准推动你升级到 $20/月的 Pro。
Copilot Free 的隐藏条件
GitHub Copilot Free 看起来和 Cursor 类似(2000 补全 + 50 聊天),但有一些不太明显的差异:
- 补全和聊天分开计数、分开停止。补全用完了你还能聊天,反过来也是——比 Cursor 的"全面降级"体验略好
- 聊天限制包含 Agent 模式:Copilot 的 Agent 功能(多文件编辑、终端操作)也消耗聊天次数。一次复杂的 Agent 任务可能消耗 5-10 次聊天额度
- 学生和开源维护者可以申请 Copilot Pro 免费使用——如果你符合条件,这是目前性价比最高的免费方案
通义灵码的日限制模式
通义灵码的"每日 ~100 次"是另一种设计思路。优点是每天重置,不存在"月中就没了"的焦虑;缺点是高强度编码日会不够用——做大型重构时一天 200+ 次交互很正常,下午就可能被限流。
三、"免费"的三种商业模型
模型 A:功能阉割(Cursor Free / Copilot Free)
产品功能完整但额度不够。传统 SaaS Freemium——用降级体验推动付费转化。你付出的:忍受降级 + 代码经过后端。
模型 B:补贴获客(Trae)
和当年网约车补贴一个逻辑。免费不等于永久免费——从免费到收费是大概率事件。你在 Trae 上建立的工作习惯,可能在某一天需要付费才能继续。
模型 C:开源免费(wescode)
编辑器本身基于开源代码构建,不提供 LLM 服务,不运营 GPU 集群——没有每个用户背后的 GPU 账单。免费是结构性的,不是策略性的。API 调用费直接交给模型供应商。

四、免费工具背后的 GPU 成本结构
免费不代表没有成本——只是成本不在你这边。
每次你按 Tab 接受一次补全,背后发生的是:代码片段(2000-8000 token)上传到后端 → GPU 推理 → 返回建议。单次推理成本约 $0.003-0.006(2-4 分钱)。Cursor Free 的 2000 次免费补全,GPU 直接成本约 $6-12/月,加上运维约 $15-25——和 Pro 订阅价格几乎持平。
这意味着免费用户几乎不产生利润——厂商的利润来自付费转化。免费额度的设计目标不是让你免费用下去,而是让你刚好尝到甜头、刚好不够用。
更关键的是额度耗尽后的降级策略:Cursor Free 用完高级请求后,模型从 GPT-4o / Claude Sonnet 降级为 GPT-4o-mini——补全质量肉眼可见地下降,复杂重构建议变得不可靠,多文件修改的上下文理解明显退化。Copilot Free 月底额度耗尽后直接停止服务。降级不是"功能变少",而是"工具变笨"——你的工作流还在,但产出质量在月中某个时刻突然跳变。
Token 计费的精确差异
不同模型的 tokenizer 差异直接影响费用,中文开发者尤其需要关注:
| 模型 | 中文 1000 字 ≈ token 数 | 代码 1000 字符 ≈ token 数 | 百万输入 token 价格 |
|---|---|---|---|
| GPT-4o | ~1500 | ~800 | $2.50 |
| Claude Sonnet 4 | ~1200 | ~750 | $3.00 |
| DeepSeek V3 | ~800 | ~600 | $0.27 |
| Qwen 2.5 | ~700 | ~650 | ~$0.20 |
GPT 系列对中文效率较低(每汉字约 1.5 token),写中文注释比英文贵 50%。DeepSeek 和 Qwen 对中文优化更好——同样的中文代码,DeepSeek 比 GPT-4o 便宜约 20 倍(单价低 10 倍 × token 数少一半)。
以下 Python 脚本可以帮你精确估算不同使用模式下的月费:
# cost_calculator.py - API 成本计算器
from dataclasses import dataclass

@dataclass
class ModelPricing:
    name: str
    input_per_million: float   # $/百万输入 token
    output_per_million: float  # $/百万输出 token

MODELS = {
    "deepseek-v3":   ModelPricing("DeepSeek V3",   0.27,  1.10),
    "gpt-4o":        ModelPricing("GPT-4o",        2.50, 10.00),
    "claude-sonnet": ModelPricing("Claude Sonnet",  3.00, 15.00),
    "qwen-2.5":      ModelPricing("Qwen 2.5",      0.20,  0.60),
}

def estimate_monthly(interactions: int, avg_in: int, avg_out: int,
                     days: int = 22, model: str = "deepseek-v3") -> str:
    p = MODELS[model]
    total_in = interactions * avg_in * days
    total_out = interactions * avg_out * days
    cost = (total_in / 1e6) * p.input_per_million \
         + (total_out / 1e6) * p.output_per_million
    return f"{p.name:18s} 月费 ${cost:.2f} (¥{cost*7.2:.1f},日均 ¥{cost*7.2/days:.2f})"

# 中度开发者:每天 40 次交互,1500 输入 / 800 输出 token
for m in MODELS:
    print(estimate_monthly(40, 1500, 800, model=m))
运行结果(中度使用,每天 40 次交互):
DeepSeek V3        月费 $1.13 (¥8.1,日均 ¥0.37)
GPT-4o             月费 $10.56 (¥76.0,日均 ¥3.46)
Claude Sonnet      月费 $14.52 (¥104.5,日均 ¥4.75)
Qwen 2.5           月费 $0.69 (¥5.0,日均 ¥0.23)
五、BYOK 月费 vs 使用量曲线
| 使用强度 | 描述 | BYOK(DeepSeek 为主) | BYOK(Sonnet 为主) | 对比 Cursor $20 |
|---|---|---|---|---|
| 轻度 | 周均 2-3 天编码 | ~$1 | ~$3 | BYOK 省 95% |
| 中度 | 每天 30-50 次交互 | ~$3 | ~$12 | BYOK 省 40-85% |
| 重度 | 全天密集对话 | ~$8 | ~$25 | BYOK 持平或略贵 |
| 极重度 | 长上下文 + Agent 循环 | ~$20 | ~$80 | BYOK 显著更贵 |
交叉点:DeepSeek V3 为主力时,大约在重度使用才和 Cursor 持平——大部分开发者用 BYOK 比订阅制便宜。
BYOK 的成本可预测性
- 实时可见:每次 API 调用在供应商后台实时可查
- 预算上限:在 OpenAI / Anthropic 设置月度消费上限,到达后自动停止
- 按需切换:日常用 DeepSeek($0.27/M token),关键任务临时切 Sonnet($3/M token)
- 无沉没成本:不用的月份费用为零
下面三段脚本覆盖个人监控、成本预估、团队审计三个场景,直接复制即可运行——它们调用的是各 LLM 供应商的通用 API,不依赖特定编辑器。
TypeScript:额度用量监控
// quota-monitor.ts - 额度 / BYOK 用量监控
interface UsageSnapshot { used: number; limit: number; resetAt: Date }

function checkQuota(usage: UsageSnapshot) {
  const remaining = usage.limit - usage.used;
  const percent = (remaining / usage.limit) * 100;
  const daysLeft = Math.ceil(
    (usage.resetAt.getTime() - Date.now()) / 86_400_000
  );
  const burnRate = usage.used / (30 - daysLeft || 1);
  const daysRemaining = remaining / burnRate;

  if (percent <= 5)
    return `⚠️ 仅剩 ${remaining} 次(${percent.toFixed(1)}%),` +
           `预计 ${daysRemaining.toFixed(0)} 天耗尽,距重置 ${daysLeft} 天`;
  if (daysRemaining < daysLeft * 0.5)
    return `⏳ 按当前速率,额度将在重置前耗尽,建议降低频率或升级`;
  return null; // 额度充裕
}

// BYOK 月度预算监控
function checkBudget(spentUSD: number, budgetUSD: number, dayOfMonth: number) {
  const projected = (spentUSD / dayOfMonth) * 30;
  if (projected > budgetUSD * 1.2)
    return `📊 当前 ${spentUSD.toFixed(2)},预计月底 ${projected.toFixed(2)},` +
           `超预算 ${((projected / budgetUSD - 1) * 100).toFixed(0)}%`;
  return null;
}
六、"免费"的隐性成本——不是钱,而是能力限制
额度只是表面限制。更重要的是免费版在能力维度上的缩水:
| 维度 | 免费工具通常的限制 | wescode BYOK | 代价/局限 |
|---|---|---|---|
| 模型选择权 | 绑定一个或少数几个模型 | 任意 OpenAI 兼容 API | 需自行管理多个 Key |
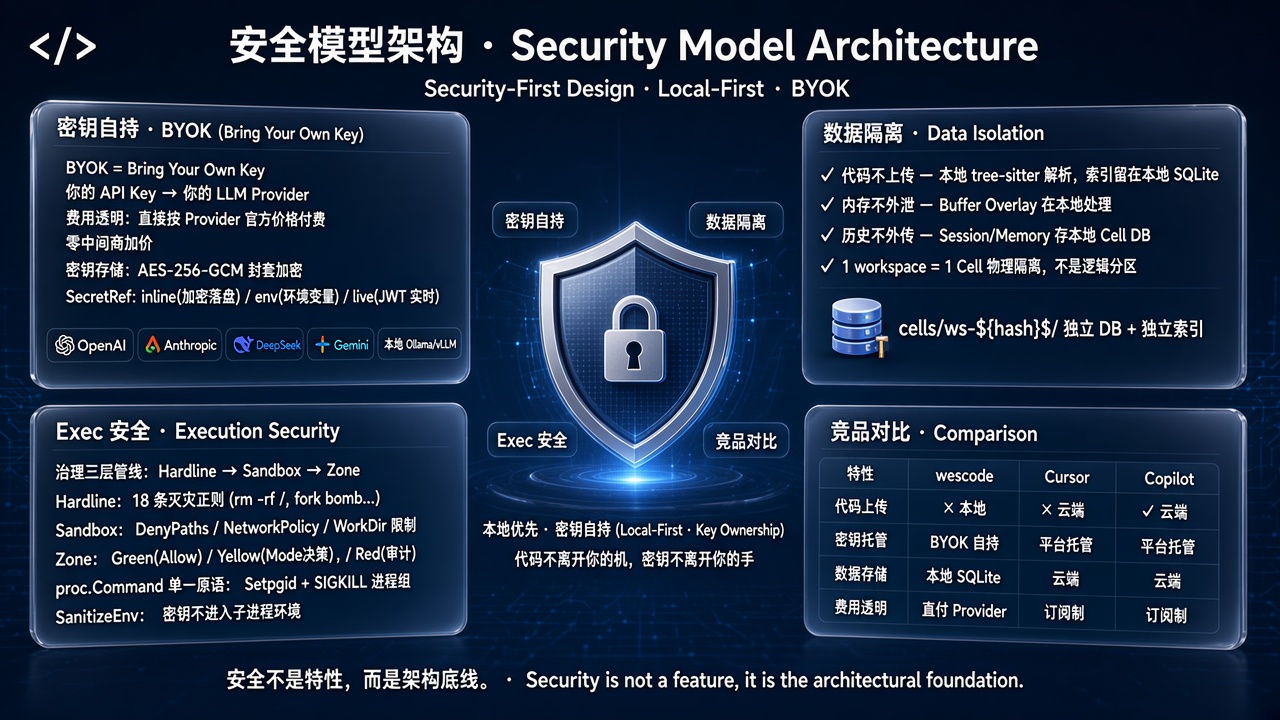
| 数据路径 | 代码经过工具厂商服务器 | BYOK 直连,代码不经第三方 | 无平台级缓存加速 |
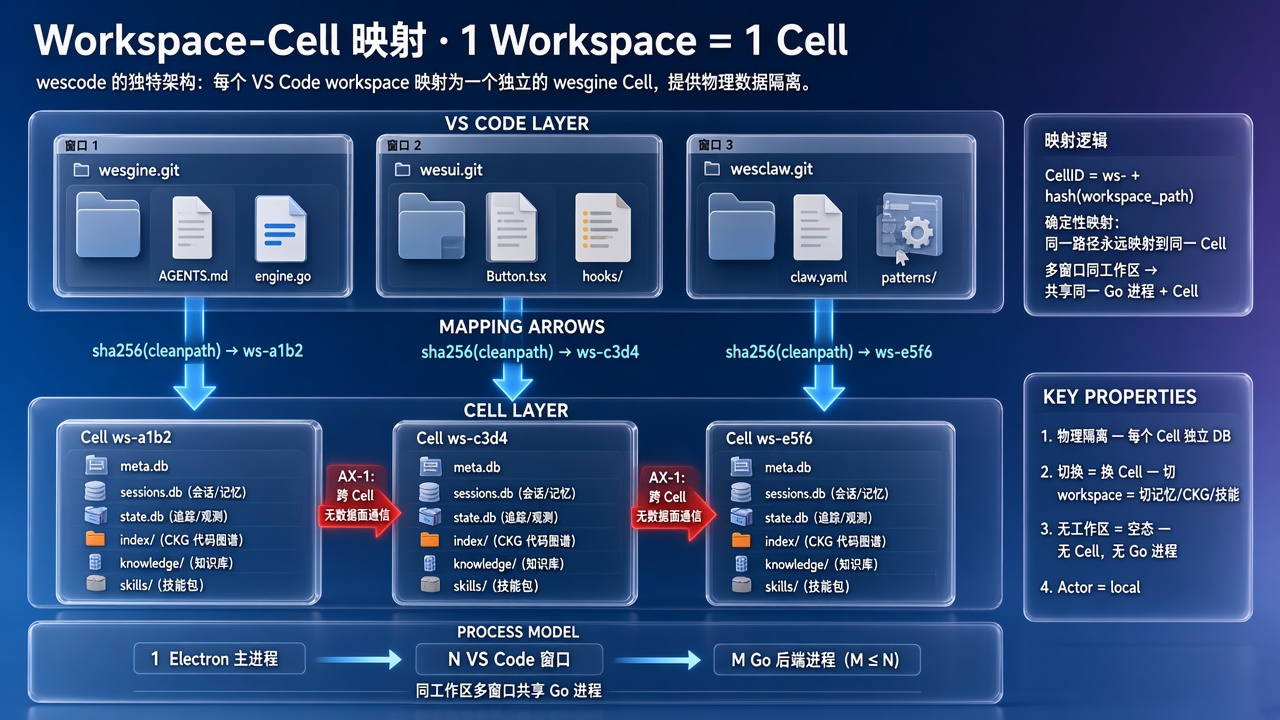
| 代码分析深度 | 无调用图、无约束引擎 | CKG + CSE 免费无限制 | 首次索引需数秒 |
| 使用节奏 | 用完等重置,工作被打断 | 按量付费,不存在"用完" | 重度使用成本可能超订阅 |
| 断网可用 | 不可用 | 索引 + 导航 + 影响分析可离线 | 云端 AI 仍需联网 |
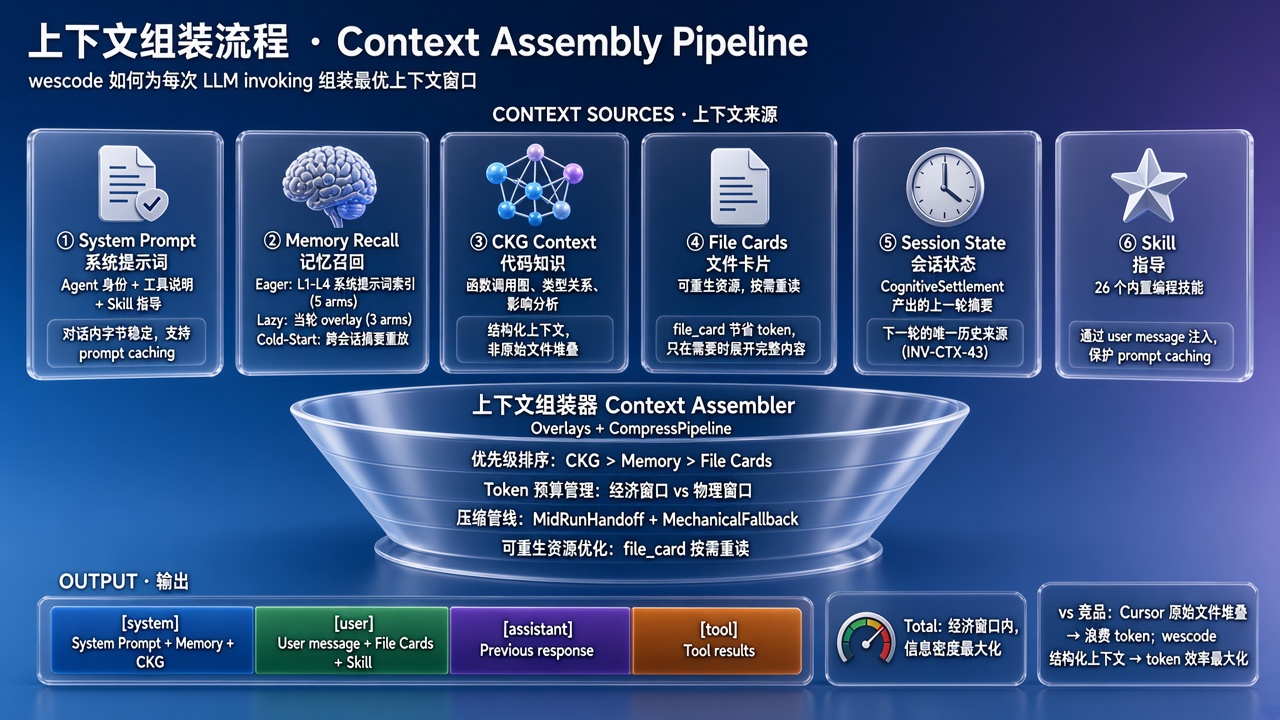
模型选择权是容易被忽略的隐性成本。免费版把你锁在一个模型上——你不能说"这个任务用 DeepSeek 便宜,那个任务用 Claude 效果好"。而实际开发中,不同任务对模型能力的要求差异很大:
- 代码补全 / 简单重构:DeepSeek V3 足够,成本极低
- 复杂架构分析 / 大规模重构:Claude Sonnet 更擅长长上下文推理
- 快速问答 / 文档生成:GPT-4o mini 或 Qwen 就够用
- 数学 / 算法题:专门的推理模型表现更好
数据路径是另一个容易被忽略的维度。Cursor 和 Copilot 的请求必须经过其后端服务器——即使你用 BYOK,Cursor 仍然会代理请求。对于处理敏感业务代码的团队来说,这可能是合规红线。wescode 的 BYOK 是真正的直连:API 请求从你的设备直接发往模型供应商,中间没有任何第三方节点。
七、企业级用量审计
对企业团队,AI 工具成本需要可审计、可归因。以下 Java 示例展示精细成本归因:
// CostAuditService.java - 企业用量审计
import java.time.*;
import java.util.*;
import java.util.stream.Collectors;

public class CostAuditService {
    public record UsageRecord(String userId, String projectId,
                              String model, int inputTokens,
                              int outputTokens, double costUsd,
                              LocalDateTime timestamp) {}

    public record CostReport(double totalUsd,
                             Map<String, Double> byProject,
                             Map<String, Double> byModel,
                             String recommendation) {}

    public CostReport monthly(List<UsageRecord> records, YearMonth month) {
        var data = records.stream()
            .filter(r -> YearMonth.from(r.timestamp()).equals(month)).toList();
        double total = data.stream().mapToDouble(UsageRecord::costUsd).sum();
        var byProject = data.stream().collect(
            Collectors.groupingBy(UsageRecord::projectId,
                Collectors.summingDouble(UsageRecord::costUsd)));
        var byModel = data.stream().collect(
            Collectors.groupingBy(UsageRecord::model,
                Collectors.summingDouble(UsageRecord::costUsd)));

        double premiumRatio = byModel.entrySet().stream()
            .filter(e -> e.getKey().contains("sonnet") || e.getKey().contains("gpt-4"))
            .mapToDouble(Map.Entry::getValue).sum() / Math.max(total, 0.01);
        String tip = premiumRatio > 0.6
            ? String.format("高价模型占比 %.0f%%,日常切 DeepSeek 可降 40-60%% 成本", premiumRatio * 100)
            : "";
        return new CostReport(total, byProject, byModel, tip);
    }
}
关键点:订阅制(Cursor Pro / Copilot)无法做到精细归因——你只知道团队花了 N × $20/月,不知道哪个项目、哪个模型消耗了多少。BYOK 天然支持精细成本归因。
八、从免费工具迁移到 BYOK:Before / After
Before:使用 Cursor Free(典型的一个月)
| 阶段 | 事件 | 体验 | 心理状态 |
|---|---|---|---|
| 月初第 1 天 | 补全飞快,Chat 秒回 | 😊 效率拉满 | "这工具真好用" |
| 第 5 天 | Chat 用了 30 次,补全 800 次 | 😊 一切正常 | 开始注意剩余额度 |
| 第 10 天 | Chat 50 次用完,切慢速模型 | 😐 回答变慢、不够深入 | "还有 20 天才重置..." |
| 第 15 天 | 补全超 1500 次,明显变慢 | 😟 补全质量下降 | 开始"省着用" |
| 第 20 天 | 补全 2000 次用完,只剩编辑器 | 😫 回到手写代码 | "不如直接付费" |
| 下月第 1 天 | 重置,又飞快了 | 😊→😐 | 知道月底还是一样 |
这个循环精准触发损失厌恶:你已经体验过高效率,回不去了。
After:使用 wescode + BYOK(同一个月)
| 阶段 | 事件 | 体验 | 费用 |
|---|---|---|---|
| 第 1 天 | DeepSeek V3 日常编码 | 😊 效率拉满 | ¥0.37 |
| 第 5 天 | 大型重构,临时切 Claude Sonnet | 🎯 最合适的模型做最合适的事 | ¥4.75(当天) |
| 第 10 天 | 回归日常,DeepSeek 为主 | 😊 一如既往 | ¥0.37 |
| 第 15 天 | 文档生成任务,用 Qwen 2.5 | 💰 中文任务用中文优化模型 | ¥0.23 |
| 月底 | 正常工作,无任何变化 | 没有"用完"的概念 | 累计 ¥42 |
核心变化:从"我还剩几次"变成"这个任务用哪个模型最合适"——心智模型从资源焦虑转向效率优化。
迁移步骤(约 10 分钟)
- 获取 API Key(5 分钟):去 DeepSeek / OpenAI / Anthropic 官网注册
- 安装 wescode(2 分钟):从 weisyn.com 下载安装
- 配置 Key(1 分钟):设置 → LLM 供应商 → 填入 Key
- 选择默认模型(1 分钟):日常 DeepSeek V3,重要任务切 Claude
- 正常使用:操作习惯和 VS Code 完全一致,无学习成本
最大的变化不是操作,而是心态——从"我还剩几次"变成"我选哪个模型最合适"。
九、什么人应该用免费工具——诚实建议
免费工具不是坏工具。 以下场景完全应该用免费方案:
- 学生 / 初学编程:Copilot Free 或 Trae,零成本最重要,学习阶段不需要高级模型
- 开源贡献者:Copilot Free(学生和维护者可申请 Pro 免费),开源代码不怕经过服务端
- 偶尔用 AI 的人:月均 20-30 次交互,Cursor Free 或 Copilot Free 绰绰有余
- 阿里云生态开发者:通义灵码,中文体验好,日限制模式适合规律工作
不适合免费工具的场景:
- 企业代码不允许出设备 → wescode BYOK 直连,代码不经第三方
- 每天重度编码 4+ 小时 → 免费额度 10 天左右就见底,月底大半时间在降级状态
- 需要多模型按任务切换 → 免费版锁定一个模型,无法按场景选择性价比最优解
- 金融 / 涉密 / 合规项目 → 免费工具的数据路径(代码经过厂商后端)很难通过安全审计
- 团队协作需要成本归因 → 订阅制只知道人头 × 单价,无法追踪到项目和模型维度
FAQ
Q:wescode 的 BYOK 和 Cursor 的 BYOK 有什么区别? A:核心区别在数据路径。Cursor 即使用自己的 Key,请求仍经后端。wescode 直连——代码请求直接发往模型提供商,不经过第三方中转。
Q:Trae 的免费能持续多久? A:没人知道。字节在用免费策略获取市场份额,从免费到收费是大概率事件。享受免费的同时,最好有 Plan B。
Q:DeepSeek V3 真的一天不到 1 块钱? A:以中等活跃度开发者为例(每天 30-50 次交互),日均约 ¥0.3-0.8,确实不到 1 块钱。频繁做大段重构或长上下文分析会上升,但仍远低于订阅制。
Q:不同模型的 tokenizer 差异对费用影响有多大? A:影响显著。同样 1000 个中文字符,GPT-4o 消耗约 1500 token,DeepSeek V3 只消耗约 800 token——单价便宜 10 倍 × token 数少近一半,综合省约 20 倍。用上面的 Python 计算器可以精确估算。
Q:企业团队怎么控制 BYOK 成本? A:三层控制:① 供应商侧设月度消费上限(OpenAI / Anthropic 均支持);② 按团队/项目分配独立 API Key,天然成本归因;③ 建立模型使用策略——日常用 DeepSeek V3,仅关键任务用高价模型。上面的 Java 审计框架可以生成精细报告。
Q:我习惯了 Cursor 的交互方式,迁移到 wescode 需要重新学习吗? A:几乎不需要。wescode 基于 VS Code 构建,快捷键、扩展、设置完全兼容。AI 功能的操作方式类似——编辑器内 Chat、代码补全、内联编辑都在。主要区别是配置 API Key 的步骤(一次性的),以及可以自由选择模型(额外的能力,不是额外的负担)。如果你现在用 VS Code 或 Cursor,切换的学习成本约等于零。
Q:BYOK 模式下代码数据安全怎么保证? A:BYOK 直连意味着你的代码只发往你选择的模型提供商(如 OpenAI、Anthropic、DeepSeek),不经过编辑器厂商的服务器。你可以直接阅读模型提供商的数据政策(主流厂商 API 调用数据默认不用于训练),而不必信任多一层中间商。对于企业场景,还可以选择私有部署的模型,实现代码完全不出内网。