AI 的记忆分三层,主流工具做到了第几层
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
你第 17 次打开新对话,输入这段话:
我们项目用 TypeScript + React,后端 Node.js + Express。
日期处理统一用 dayjs,不要用 moment.js。
你上周说过。上上周也说过。AI 回答得很好——但它不记得你说过。
不是模型笨。是工具没有给它记忆。每次新对话,上下文从零开始。你说的项目偏好、技术决策、历史纠正,全部清零。你花了 30 秒教 AI 一件事,下次还得花 30 秒再教一遍。一天开 10 个对话,你就是 AI 的人肉缓存。
记忆的三个层次
按持久性分,AI 编程工具的"记忆"有三层:
| 层次 | 持久性 | 内容 | 用户负担 |
|---|---|---|---|
| 第一层:会话内记忆 | 仅限当前对话 | 这轮对话里你说了什么、AI 改了什么 | 无——对话内天然保持 |
| 第二层:跨会话规则 | 手动维护的文件 | .cursorrules、CLAUDE.md、.github/copilot-instructions.md | 你要写、你要改、你要记得更新 |
| 第三层:长期认知记忆 | 自动积累 + 持久化 | 偏好、纠正、决策、事实 | 无——对话结束自动提炼 |
用一个具体例子说明三层的区别——同样一条"不要用 moment.js"在三层记忆里分别怎么运作。
第一层:只在这次对话里有效
// 第一轮
// 用户:帮我写一个日期格式化工具函数
// AI 输出:
import moment from 'moment'
export const formatDate = (d: Date) => moment(d).format('YYYY-MM-DD')

// 用户:不要用 moment.js,用 dayjs
// AI 修正:
import dayjs from 'dayjs'
export const formatDate = (d: Date) => dayjs(d).format('YYYY-MM-DD')

// 同一对话的第二轮
// 用户:再写一个日期范围选择器组件
// AI 自动用 dayjs——因为对话历史里有这条纠正
下一次新对话呢? AI 又会用 moment.js。因为上下文窗口清零了。你在上一次对话里教它的事,它完全不记得。
第二层:你手动写一条规则
你打开项目根目录的 .cursorrules 文件,加一行:
日期处理统一使用 dayjs,禁止 moment.js。
以后每次新对话,AI 都能看到这条规则——它被注入到系统提示词里。
但代价是你要维护这个文件。 项目里有 30 条这样的偏好——API 前缀用 /api/v2、错误处理用 neverthrow、测试框架用 vitest、import 按类型分组排序——你需要自己记住哪些该写进去,写进去之后规范变了要不要更新。本质上是把一部分记忆负担从"每次对话重复说"转移到了"维护一个配置文件"。
第三层:AI 自己记住
用户:帮我写日期格式化
AI:(用了 moment.js)
用户:不要用 moment.js,用 dayjs
AI:好的,已改为 dayjs。

──── 对话结束,认知结算自动触发 ────
AI 提炼出一条偏好:日期库使用 dayjs,不使用 moment.js
写入长期记忆(本地 SQLite)

──── 三天后,新对话 ────
用户:帮我写一个日期范围选择器
AI:(直接用 dayjs——因为长期记忆里已有这条偏好,被注入到了系统提示词)
你什么都不用做。 不用维护文件,不用重复说,不用记住自己说过什么。
各家做到第几层
Cursor — 第一层 + 第二层
对话内有完整上下文(第一层)。跨对话靠 .cursorrules 文件和 Notepad(第二层)。@Past Chats 可以引用历史对话——但这是手动搜索后手动 @,你得记住在哪次对话里说过什么。
没有第三层。 你上次纠正 AI"不要用 moment.js",下一次对话它不知道。除非你自己写进 .cursorrules。
Claude Code — 第一层 + 第二层
对话内记忆 + CLAUDE.md 规则文件。Claude 的长上下文窗口(200K tokens)意味着单次对话可以持续很多轮不丢信息——但这是第一层的增强,不是跨对话记忆。开一个新对话,仍然从零开始。
Claude Code 还有一个隐含的记忆机制:它会在对话中主动提议更新 CLAUDE.md,让有价值的发现写回规则文件。这比纯手动维护好一步——但本质仍然是第二层,只是降低了维护门槛。
GitHub Copilot — 第一层 + 部分第二层
对话内上下文 + .github/copilot-instructions.md(2024 年底推出,功能较新)。指令文件的支持度不如 .cursorrules 成熟——比如不支持按文件类型设置不同规则。没有第三层。
通义灵码 / Trae — 第一层
主要是对话内记忆。通义灵码有"代码风格学习"功能——可以从你的代码库中学习命名风格和模式,算隐性的第二层,但不如规则文件可控和透明。Trae 没有独立的跨会话规则机制。两者都没有第三层——你的偏好和纠正不会跨会话延续。
wescode — 第一层 + 第二层 + 第三层
wescode 在前两层之上,通过认知结算(Cognitive Settlement)实现了自动化的长期认知记忆。基于 VS Code Fork,你的扩展、快捷键、主题全部保留。第三层的记忆不需要你写任何配置文件——对话结束时自动提炼,下次新对话自动生效。
认知结算:怎么把对话变成记忆
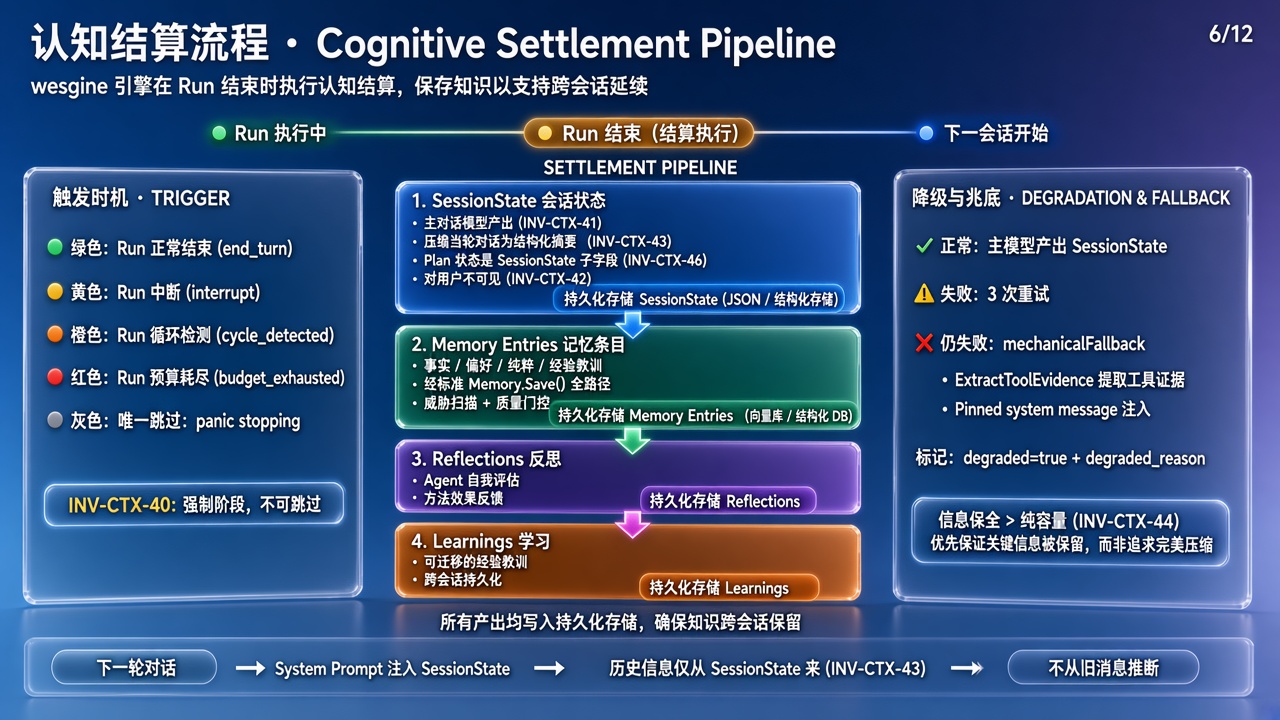
认知结算的完整技术流程:
对话进行中(用户和 AI 来回对话,正常工作)
 │
对话结束,触发认知结算(Run 终态的强制阶段)
 │
主模型提炼认知产物
(和对话用的是同一个模型,不是辅助小模型)
 │
 ┌────┼────┬────┐
 事实 偏好 纠正 决策
 │ │ │ │
去重(ContentDedupKey)
同样内容不重复写入——你说了三次"用 dayjs"只存一条
 │
冲突检测(Supersession)
新记忆和旧记忆矛盾 → 标记旧记忆"已被取代"
 │
写入本地 SQLite
每个工作区(Cell)物理隔离
 │
下次新对话自动加载到系统提示词
不占上下文窗口
Before/After 对比——两天的真实场景:
| 时间 | 没有第三层记忆 | 有第三层记忆 |
|---|---|---|
| Day 1 上午第 1 个对话 | 教 AI"用 vitest 不要 jest" | 教 AI"用 vitest 不要 jest" |
| Day 1 上午第 2 个对话 | 又要说一遍"用 vitest" | AI 已经记住,自动用 vitest |
| Day 1 下午第 3 个对话 | 又说一遍 + 教 AI"import 分三组排序" | AI 记住了 vitest + 教 import 排序 |
| Day 2 上午第 4 个对话 | 两件事都要重复 | AI 记住所有偏好,直接按规范写 |
| Day 2 下午第 5 个对话 | 发现还要教"API 错误用 Result 类型" | AI 记住前面的 + 教 Result 类型 |
| 一周后 | 每次新对话重复 5+ 条偏好(~2min/次) | 所有偏好自动生效,0 重复 |
| 累计浪费 | 一周 50+ 对话 × 2min = ~100 分钟 | 0 分钟 |
结算完成后,下一次新对话的系统提示词里会自动多出这些内容:
# 系统提示词中注入的长期记忆(用户不可见,AI 可见)
# 格式类似于:

"""
[长期记忆 — 关于我]
- 日期库使用 dayjs,不使用 moment.js(偏好,来源:对话纠正)
- 测试框架使用 vitest(偏好,来源:对话纠正)
- import 排序:React 在前,第三方次之,本地在后(偏好,来源:认知结算)
- API 错误处理使用 neverthrow 的 Result 类型(决策,来源:认知结算)
"""

# 你看不到这些注入(它们在系统提示词里,不在对话界面里)
# 但 AI 能看到——所以新对话一开始就"记得"你的偏好
三个关键设计:
主模型做提炼,不是辅助模型。 用来提炼认知的是正在对话的那个模型本身——它完整参与了对话过程,理解上下文,提炼质量等于对话质量。不是事后用一个便宜的小模型做"总结"。
写入本地,不上传。 记忆存在本地 SQLite 数据库里,不上传到任何服务器。一个重度使用半年的项目,记忆数据通常在 1-5 MB(内部测试数据)。
按工作区隔离。 每个 VS Code 工作区对应一个独立的 Cell——A 项目的记忆不会串到 B 项目。前端项目的"用 Tailwind 不用 styled-components"不会影响后端项目。
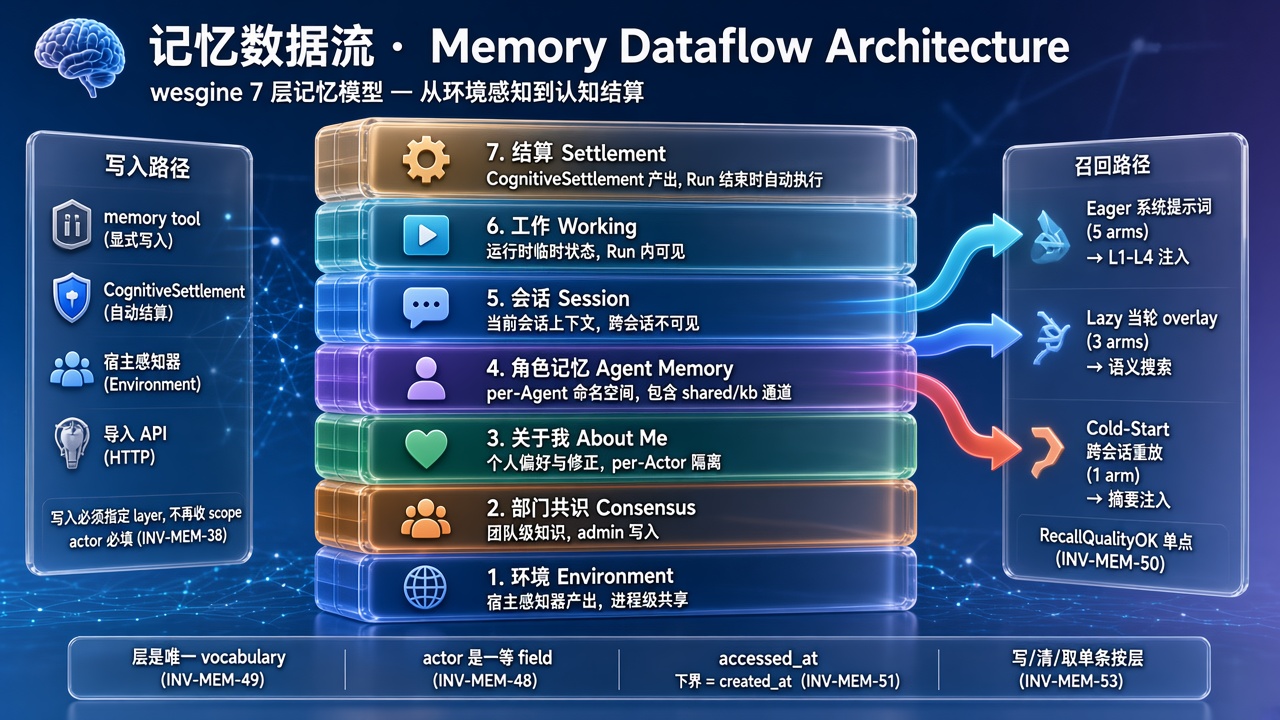
七层记忆体系
wescode 的记忆不是一个扁平列表,按用途分成七层。日常使用不需要理解全部层——记忆中心(管理界面)会展示每条记忆属于哪一层。
| 层 | 内容示例 | 来源 | 持久性 | 隔离方式 |
|---|---|---|---|---|
| 环境信息 | macOS 15.3 / Node 22 / pnpm 已安装 / Go 1.23 | 引擎感知器自动采集 | 每次启动刷新 | 按工作区(Cell) |
| 部门共识 | 团队规范:API 统一 RESTful + OpenAPI 文档 | admin 写入 | 持久 | Cell 级共享 |
| 关于我 | 偏好 tabs 缩进、dayjs、vitest、函数式风格 | 认知结算自动提炼 | 持久 | 按用户(actor)隔离 |
| 角色记忆 | Agent "code-reviewer" 的审查清单和行为准则 | 认知结算 / 手动写入 | 持久 | 按 agent 命名空间 |
| 会话记忆 | 当前对话的工作上下文和进度 | 运行时产生 | 会话期间 | 按 session |
| 工作缓存 | 临时计算中间状态、搜索结果片段 | 运行时产生 | 短期 | 按 session |
| 未识别 | 未归入以上类别的条目 | 兜底 | 视情况 | 无 |
日常开发最常触发的是第三层"关于我"——你在对话中表达的偏好、纠正、技术选型,都被认知结算自动提炼到这一层。
用 Java 类比理解记忆的层次隔离:
// 理解记忆隔离的类比——不是真实实现
public class MemoryIsolation {

    // 环境层:进程级,所有 Cell 共享宿主环境
    // SharedSnapshot(ctx) → 每进程感知一次,5min TTL
    static HostSnapshot sharedEnv;

    // 共识层:Cell 级,部门内所有人共享
    // 团队规范、架构约定
    Map<String, MemoryEntry> consensus; // key: Cell 全局

    // 关于我:Cell 内按 actor 隔离
    // 张三的偏好不会出现在李四的对话里
    Map<String, Map<String, MemoryEntry>> aboutMe;
    // aboutMe.get("zhangsan") → 张三的偏好列表
    // aboutMe.get("lisi") → 李四的偏好列表

    // 角色记忆:按 Agent 命名空间隔离
    // code-reviewer 的记忆和 architect 的记忆独立
    Map<String, Map<String, MemoryEntry>> agentMemory;
    // agentMemory.get("code-reviewer") → 审查经验
    // agentMemory.get("architect") → 架构决策
}
各工具记忆能力详细对比

不只看"有没有",看具体能记什么、怎么记、存在哪。
| 能力维度 | Cursor | Claude Code | wescode | Copilot | 通义灵码 | Trae |
|---|---|---|---|---|---|---|
| 会话内记忆 | ✅ 标准 | ✅ 长上下文强 | ✅ 标准 | ✅ 标准 | ✅ 标准 | ✅ 标准 |
| 跨会话规则文件 | ✅ .cursorrules | ✅ CLAUDE.md | ✅ 支持 | ✅ .github/ | ⚠️ 隐性学习 | 无 |
| 自动长期记忆 | 无 | 无 | 支持(认知结算) | 无 | 无 | 无 |
| 记住偏好 | 每次重说 | 每次重说 | 自动积累 | 每次重说 | 无 | 无 |
| 记住纠正 | 无 | 无 | 纠正存入记忆 | 无 | 无 | 无 |
| 冲突处理 | — | — | Supersession 检测 | — | — | — |
| 过期清理 | — | — | Digest 自动归档 | — | — | — |
| 按项目隔离 | 规则跟仓库 | 规则跟仓库 | Cell 物理隔离 | 规则跟仓库 | 无 | 无 |
| 存储位置 | — | — | 本地 SQLite | — | — | — |
| 引用历史 | ✅ @Past Chats | 无 | ✅ 自动注入 | 无 | 无 | 无 |
Cursor 和 Claude Code 的前两层已经做得很好——尤其 Claude Code 的长上下文能力让单次对话体验非常强。差距在第三层:跨会话的自动记忆积累。
记忆有什么实际用处
场景一:偏好积累。 你连续三次纠正 AI "测试用 vitest 不要用 jest"。有第三层记忆后第四次不用说了——这条纠正已经存入长期记忆,每次新对话自动生效。
场景二:决策记录。 "上周我们决定把 REST API 迁移到 tRPC"——进入记忆后,之后所有新对话生成的代码都会用 tRPC,不用每次重复这个决定。
场景三:教训学习。 AI 上次在 utils/date.ts 里用了 moment.js,你纠正了。这个纠正被认知结算存入记忆后,AI 以后不会再犯同样的错——不管过多少天、隔多少次对话。
场景四:团队新人。 新同事接手项目,打开 wescode——"关于我"层有前任积累的偏好,"部门共识"层有团队的技术规范。新人不需要读完所有历史 PR 和 README 就能让 AI 按项目约定写代码。
场景五:技术选型变更。 你上周决定"把 Mocha 换成 vitest",这条决策被认知结算存入记忆。之后所有新对话生成测试代码都用 vitest——你不需要在每个对话里提醒 AI,也不需要去改规则文件。如果两个月后你又换回 jest,新的纠正会触发冲突检测,旧的"用 vitest"被标记为已被取代。
认知结算记不住什么
诚实说,不是所有对话内容都值得变成长期记忆:
| 记不住(不会进入长期记忆) | 为什么 |
|---|---|
一次性调试命令(console.log(data) 排查完就删) | 临时操作,下次无复用价值 |
临时变量名(const tempList = ...) | 上下文依赖太强,脱离当前代码段无意义 |
| 纯操作性步骤("先打开文件 A,再跳转到第 23 行") | 是操作不是认知——记住了下次也用不上 |
| 上下文依赖太强的片段 | 和当前代码状态强耦合,代码一改就失效 |
| 跨项目知识 | A 项目的记忆不会串到 B 项目——物理隔离 |
| 引擎内部状态(Plan 步骤、任务编排中间态) | 被内容质量门控拦截,不允许写入记忆 |
这是设计选择:宁可少记,不要记错。 记错一条偏好(比如把临时尝试记成长期决策)比没记住要有害得多——记错了会持续影响后续每一次对话。
所有写入记忆的内容都经过内容质量门控和威胁模式扫描——引擎状态前缀、凭据片段都会被拦截。
换个角度理解:认知结算只记可迁移的认知——脱离当前对话、放到未来任何一次对话里仍然有用的东西。
记忆冲突和过期
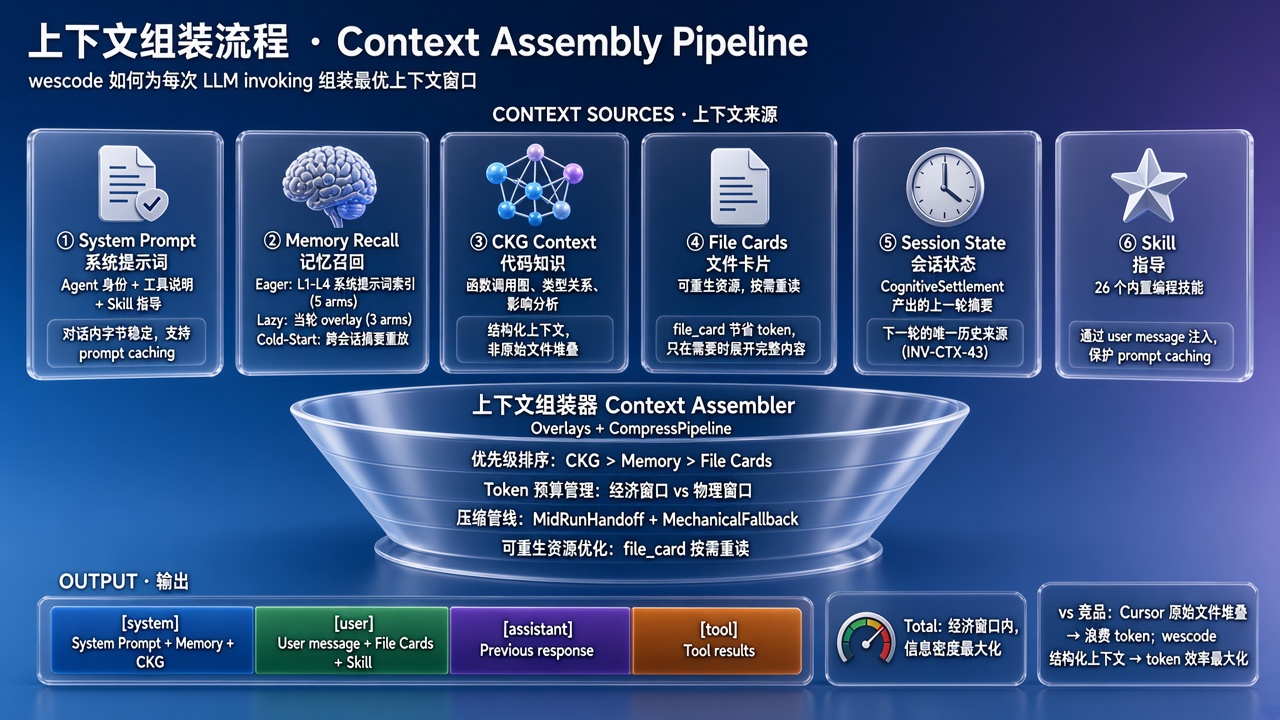
两个机制保证记忆不会越积越乱:
冲突检测(Supersession)。 你三个月前说"用 REST API",上周说"迁移到 tRPC"。两条记忆矛盾——新记忆写入时自动检测冲突,标记旧记忆为"已被取代"。被取代的记忆不再注入到对话,但保留在记忆中心可查看和恢复。
过期归档(Digest)。 长时间未被召回的记忆自动标记为 stale,超过一定期限归档。归档不是删除,需要时可以恢复。淘汰算法不是简单的 LRU——用的是 recall-frequency weighted 评分(RetentionScore),被频繁使用的记忆不会因为"最近没用到"就被错误清理。
用 TypeScript 伪代码理解冲突检测的逻辑:
interface MemoryEntry {
  id: string;
  content: string;
  kind: 'preference' | 'correction' | 'decision' | 'fact';
  createdAt: Date;
  accessedAt: Date;
  recallCount: number;
  conflicted: boolean;  // 被 Supersession 标记
  stale: boolean;       // 被 Digest 标记
}

function detectSupersession(
  newEntry: MemoryEntry,
  existingEntries: MemoryEntry[]
): MemoryEntry[] {
  const conflicted: MemoryEntry[] = [];
  for (const old of existingEntries) {
    // 语义相似度超过阈值(0.4)且包含否定标记
    if (semanticSimilarity(old.content, newEntry.content) > 0.4
        && containsNegation(newEntry.content, old.content)) {
      old.conflicted = true;
      conflicted.push(old);
    }
  }
  return conflicted;
  // "用 dayjs 不要 moment" → 旧的 "用 moment" 被标记 conflicted
}
举个例子:"用 dayjs 不用 moment.js"这条偏好被召回了 40 次——RetentionScore 很高,即使三个月没碰日期相关代码也不会被归档。而"上次那个 API 返回了 502"只被召回过 1 次,30 天没再提起就进入 stale 状态。
常见问题
Q:我不想让 AI 记住某些东西怎么办?
A:记忆中心可以查看和删除任何一条记忆。支持按层筛选——比如只看"关于我"这一层的偏好记忆,或者只看"角色记忆"。七层芯片恒定渲染——即使某一层是空的也会显示 0,让你清楚知道"这层是空的"而不是"这层不存在"。删除操作是即时的,下一次对话就不会再看到被删的记忆。
Q:Cursor 的 Notepad 和 @Past Chats 算记忆吗?
A:Notepad 是手动写笔记供对话引用,@Past Chats 是手动搜索历史对话——本质上都是第二层(手动维护)的变体。你需要主动去写、去搜、去 @。和自动积累的第三层记忆是不同的东西。
Q:Claude Code 的对话内记忆那么强,还需要第三层吗?
A:Claude Code 单次对话确实很强——200K 上下文窗口让一次对话可以持续很多轮。但 AI 编程不是一次长对话。你一天开十几个对话、一周开上百个。第一层再强,也只在当次对话里有效。第三层解决的是跨越这些对话的知识延续。
Q:记忆会不会越积越乱?
A:两个机制防止这个问题。冲突检测:新旧记忆矛盾时,旧记忆自动标记"已被取代"、不再注入。过期归档:长期未被召回的记忆自动标记 stale 并归档。淘汰用 recall-frequency weighted 评分,不是简单的 LRU。此外,所有写入都经过内容质量门控——引擎状态前缀、纯操作步骤、凭据片段都会被拦截,从源头控制记忆的质量。
Q:规则文件(.cursorrules / CLAUDE.md)和第三层记忆冲突了怎么办?
A:规则文件是显式声明,长期记忆是对话中隐式积累。如果两者矛盾——比如 .cursorrules 写了"用 moment.js",但记忆里有一条"用 dayjs"——显式声明优先。规则文件是团队级别的约定,记忆是个人偏好的积累。
本文对各工具记忆能力的描述基于其 2026-09-20 的公开文档和功能。