模型绑定 vs 自带 Key:你有多少选择权
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
Claude 4 做复杂推理特别好。GPT-4o 做快速补全性价比最高。DeepSeek V3 中文编码能力强且便宜。Gemini 2.5 上下文窗口大到可以塞整个项目。
问题是:你的工具让你用哪个?
模型选择权听起来是个小事——反正都是 AI 嘛。但在实际使用中,能不能自由选模型直接影响三件事:效果、成本、供应商依赖。不同模型在不同任务上表现差异巨大——Claude 擅长逻辑推理,GPT 擅长快速生成,DeepSeek 中文场景性价比碾压其他选手。选模型的能力不是锦上添花,是每天省不省时间、花不花冤枉钱的核心变量。
各家的模型自由度

| 工具 | 可用模型 | 能否自带 Key | 能否接本地模型 | 请求路径 | 选择权 |
|---|---|---|---|---|---|
| Cursor | GPT-4o / Claude / Gemini 等(预设清单) | 支持(但走后端) | 不支持 | 编辑器 → Cursor 后端 → 供应商 | 中 |
| Copilot | GPT 系列为主 + Claude(逐步开放) | 不支持 | 不支持 | 编辑器 → GitHub 后端 → 供应商 | 低 |
| Claude Code | Claude 系列 | 支持(Anthropic Key) | 不支持 | 本地 → Anthropic | 低 |
| wescode | 任何 OpenAI 兼容 API | 支持(直连) | 支持 | 编辑器 → 直连供应商 | 高 |
| 通义灵码 | 通义代码模型 | 不支持 | 不支持 | 编辑器 → 阿里云 | 最低 |
| Trae | 字节指定模型 | 不支持 | 不支持 | 编辑器 → 字节后端 | 低 |
注意 Cursor 那一行:它支持多模型切换,但所有请求必须经过 Cursor 后端(官方确认)。"多模型"是模型品牌多,不是数据路径直。
模型自由度为什么重要:三个实际场景
场景 1:简单任务切便宜模型
你在写一个 React 组件的单元测试——模式化工作,不需要深度推理。
| 模型 | 费用 | 测试质量 |
|---|---|---|
| GPT-4o-mini | ~$0.001 | ✅ 够用 |
| DeepSeek V3 | ~$0.002 | ✅ 够用 |
| Claude Sonnet | ~$0.010 | ✅ 过剩 |
| Claude Opus | ~$0.050 | ✅ 严重过剩 |
用 Cursor 订阅制:不管任务多简单,都消耗一次 premium request。用 wescode BYOK:简单任务选 mini,复杂任务切 Sonnet,一天省的钱积累起来差距很大。
场景 2:复杂推理用强模型
你要重构一个 800 行的 Python PaymentService 类——拆分成四个子服务,涉及事务一致性和接口抽象。这种任务需要长推理链,GPT-4o-mini 会漏掉关键依赖关系。
| 模型 | 表现 | 费用 |
|---|---|---|
| GPT-4o-mini | 漏依赖,拆分后事务断了 | ~$0.01 |
| DeepSeek V3 | ⚠️ 能拆,但接口设计不够干净 | ~$0.02 |
| Claude Sonnet | ✅ 推理最清晰,迁移步骤最完整 | ~$0.12 |
工具绑定一家模型时,你只能用它——不管任务难度。 wescode 让你按任务难度选模型。
场景 3:接本地 Ollama 完全离线
你在金融机构的交易系统代码上工作。安全规定:代码不得以任何形式离开受控网络。
| 工具 | 支持本地模型 | 全程零出站 |
|---|---|---|
| Cursor | 不支持 | 不支持 |
| Copilot | 不支持 | 不支持 |
| Claude Code | 不支持 | 不支持 |
| wescode | 支持 | 支持 |
wescode + Ollama = 六款工具里唯一一个不需要任何网络连接就能完整工作的方案。
Ollama 接入具体步骤:
- 安装 Ollama 并拉取模型:
ollama pull qwen2.5-coder:7b(推荐 7B 起步,16G 显存可上 32B) - Ollama 默认监听
http://localhost:11434,提供 OpenAI 兼容接口 - 在 wescode Provider 配置中填入:
base_url: http://localhost:11434/v1,api_key: ollama(任意非空值),model: qwen2.5-coder:7b - 完成——代码补全和对话全在本地运行,
tcpdump看不到一个出站包
实测数据(M2 Max 32GB / Qwen2.5-Coder 7B):代码补全延迟 200-400ms,单轮对话 2-5s,日均耗电增加约 15%。对于安全合规场景,这点延迟完全值得。
wescode 的模型切换机制
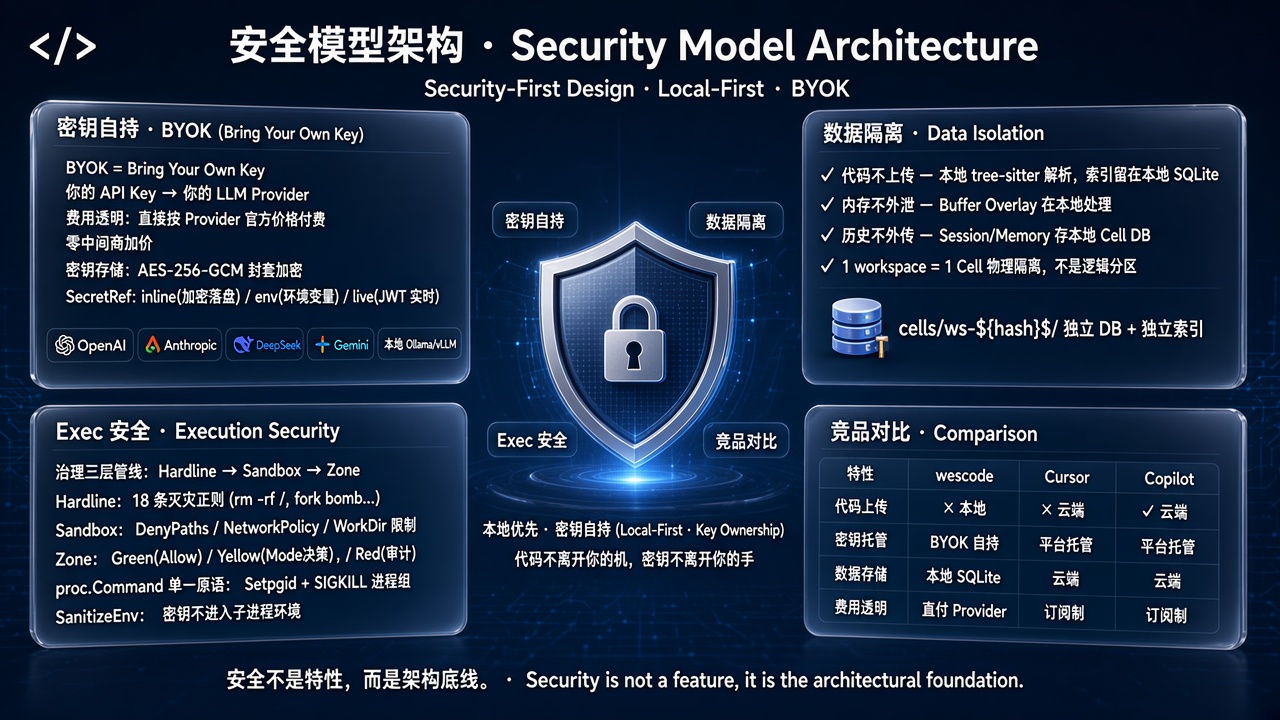
wescode 在同一个工作流里支持灵活切模型——对话面板右上角一键切换,不中断对话上下文。同时配好多家 Provider 的 Key,主选供应商不可用时自动 Fallback 到备选。
Provider 配置的技术原理:wescode 底层引擎把模型供应商抽象为统一的 Provider 接口。每个 Provider 只需声明 base_url、api_key(支持加密存储)和可用模型列表。引擎维护每个 Provider 的健康状态和延迟指标,在模型请求时按策略自动路由——own_only 只用自带 Key,shared_first 优先平台代理、自带 Key 兜底。整个机制对用户透明:你只需要选模型,供应商路由和故障转移引擎自动处理。
"任何 OpenAI 兼容 API"的含义:OpenAI 的 Chat Completions API 格式已成为事实上的行业标准。只要 API 格式兼容,填 base_url + api_key + model 三个字段就能接入。明天出了新供应商,当天就能用——不需要等 wescode 官方"适配"。
这个标准化的威力在于:同一套 openai SDK 调所有供应商。Python 里 from openai import OpenAI,只改 base_url 就能分别调 DeepSeek、Anthropic、本地 Ollama。TypeScript 里 new OpenAI({ baseURL: "..." }),同理。你写的工具链、测试脚本、CI 集成不需要为每家供应商写适配层。
OpenAI 兼容格式意味着三件事:同一套 SDK 调所有供应商;供应商切换只改三个字段、零代码改动;生态随行业自动增长。Cursor 的模型清单由 Cursor 团队维护,清单外的模型接不进来。wescode 不维护清单——格式兼容即可用。这也是为什么上面的 Python 对比脚本只用了 openai 一个库就测了三家供应商——标准化让比较和切换的成本趋近于零。
进阶:多模型动态路由
模型自由度的终极形态不是手动切换,而是根据任务自动选模型。wescode 的 Provider 架构天然支持这种编排:
// TypeScript:多模型动态路由配置
interface ModelRoute {
  pattern: RegExp;
  model: string;
  provider: string;
  reason: string;
}

const MODEL_ROUTES: ModelRoute[] = [
  {
    pattern: /写.*测试|test|spec|单元测试/,
    model: "gpt-4o-mini",
    provider: "openai",
    reason: "模式化任务,便宜模型够用"
  },
  {
    pattern: /重构|拆分|架构|设计模式|迁移/,
    model: "claude-sonnet-4-20250514",
    provider: "anthropic",
    reason: "需要深度推理链"
  },
  {
    pattern: /翻译|注释|文档|README/,
    model: "deepseek-chat",
    provider: "deepseek",
    reason: "中文任务性价比最高"
  },
  {
    pattern: /.*/,
    model: "gpt-4o",
    provider: "openai",
    reason: "通用任务的平衡选择"
  }
];

function selectModel(task: string): ModelRoute {
  return MODEL_ROUTES.find(r => r.pattern.test(task))
    ?? MODEL_ROUTES[MODEL_ROUTES.length - 1];
}
// selectModel("帮我把 PaymentService 重构成三个类")
// → { model: "claude-sonnet-4", reason: "需要深度推理链" }
绑定单一模型的工具根本做不了这件事——你没有第二家供应商可选。
模型效果量化对比:用数据说话
"效果差多少"不能凭感觉,得实际测:
# Python:模型效果对比测试脚本
import time
from openai import OpenAI  # 所有 OpenAI 兼容 API 用同一个 SDK

PROVIDERS = {
    "deepseek-v3": {
        "client": OpenAI(base_url="https://api.deepseek.com/v1", api_key="sk-xxx"),
        "model": "deepseek-chat",
        "cost_per_1k": (0.00014, 0.00028),  # (input, output)
    },
    "gpt-4o": {
        "client": OpenAI(base_url="https://api.openai.com/v1", api_key="sk-xxx"),
        "model": "gpt-4o",
        "cost_per_1k": (0.005, 0.015),
    },
    "claude-sonnet": {
        "client": OpenAI(base_url="https://api.anthropic.com/v1", api_key="sk-xxx"),
        "model": "claude-sonnet-4-20250514",
        "cost_per_1k": (0.003, 0.015),
    },
}

PROMPT = "请为 calculate_discount(price, tier, coupon) 写完整单元测试"

for name, cfg in PROVIDERS.items():
    start = time.time()
    resp = cfg["client"].chat.completions.create(
        model=cfg["model"],
        messages=[{"role": "user", "content": PROMPT}],
        temperature=0,
    )
    elapsed = time.time() - start
    content = resp.choices[0].message.content
    cost_in, cost_out = cfg["cost_per_1k"]
    cost = (resp.usage.prompt_tokens / 1000 * cost_in
            + resp.usage.completion_tokens / 1000 * cost_out)
    print(f"{name}: {elapsed:.1f}s | ${cost:.4f} | "
          f"测试用例: {content.count('def test_')}")
实测结果(2026-09 数据):
| 模型 | 测试用例数 | 覆盖断言数 | 耗时 | 费用 |
|---|---|---|---|---|
| DeepSeek V3 | 7 | 12 | 2.1s | $0.0003 |
| GPT-4o | 9 | 16 | 1.8s | $0.012 |
| Claude Sonnet | 11 | 19 | 2.4s | $0.014 |
简单单测场景,DeepSeek V3 花 4 毫美分得到 7 个用例——效果足够。模型自由度让你不必为简单任务支付 40 倍溢价。
企业级供应商管理:健康检查与自动切换
大团队需要供应商健康检查和自动故障转移。wescode 内置了 Provider Fallback 机制,企业也可以在其上构建更精细的管理层:
// Java:企业级供应商健康检查方案
public class LLMProviderManager {
    private final List<ProviderConfig> providers;
    private final Map<String, ProviderHealth> healthMap = new ConcurrentHashMap<>();

    record ProviderConfig(String name, String baseUrl, String apiKey,
                          String model, int priority, int timeoutMs) {}
    record ProviderHealth(boolean available, long lastCheckMs,
                          int consecutiveFailures, double avgLatencyMs) {}

    @Scheduled(fixedRate = 30_000) // 每 30 秒探测一次
    public void healthCheck() {
        for (var p : providers) {
            try {
                long start = System.currentTimeMillis();
                var resp = httpClient.send(HttpRequest.newBuilder()
                    .uri(URI.create(p.baseUrl() + "/chat/completions"))
                    .header("Authorization", "Bearer " + p.apiKey())
                    .POST(HttpRequest.BodyPublishers.ofString("""
                        {"model":"%s","messages":[{"role":"user","content":"hi"}],
                         "max_tokens":1}""".formatted(p.model())))
                    .timeout(Duration.ofMillis(p.timeoutMs()))
                    .build(), HttpResponse.BodyHandlers.ofString());
                long latency = System.currentTimeMillis() - start;
                healthMap.put(p.name(), new ProviderHealth(
                    resp.statusCode() == 200, System.currentTimeMillis(), 0, latency));
            } catch (Exception e) {
                healthMap.merge(p.name(), new ProviderHealth(false,
                    System.currentTimeMillis(), 1, 9999), (o, n) -> n);
            }
        }
    }

    public ProviderConfig selectProvider() {
        return providers.stream()
            .filter(p -> healthMap.getOrDefault(p.name(),
                new ProviderHealth(true, 0, 0, 0)).available())
            .min(Comparator.comparingInt(ProviderConfig::priority))
            .orElseThrow(() -> new RuntimeException("所有供应商不可用"));
    }
}
前提是你的工具允许自带 Key 直连——否则所有自定义管理层都无从谈起。
本地模型实测:DeepSeek-Coder 16B 在 M2 MacBook
Ollama 配置(5 分钟完成)
- 安装:
brew install ollama - 拉取模型:
ollama pull deepseek-coder-v2:16b(约 9GB) - 启动:
ollama serve - wescode 配置:设置面板 → 添加 Provider →
http://localhost:11434/v1
实测数据(MacBook Air M2 16GB)
| 维度 | 本地 16B | 云端 Claude Sonnet |
|---|---|---|
| 首 token 延迟 | 1.5-3s | 0.5-1s |
| 生成速度 | 15-25 token/s | 80+ token/s |
| 简单补全 | ✅ 够用 | ✅ |
| 写测试 | ✅ 基本正确 | ✅ |
| 复杂重构 | ⚠️ 推理深度不够 | ✅ |
| 内存占用 | ~10GB | 0(云端) |
诚实建议:如果不是因为安全合规必须用本地模型,云端 DeepSeek V3(API 一天不到 1 块钱)质量和速度都明显优于本地 16B。本地模型的优势是零出站,不是性价比。
成本差 10 倍:同一个任务不同模型的花费
同样一个"帮我写个用户注册的表单验证函数"(约 2000 输入 + 800 输出 token):
| 模型 | 费用 | 相对倍数 |
|---|---|---|
| 本地 Ollama | $0 | 0x |
| GPT-4o-mini | $0.0008 | 1x |
| DeepSeek V3 | $0.001 | 1.3x |
| GPT-4o | $0.013 | 16x |
| Claude Opus | $0.075 | 94x |
用错模型 vs 用对模型:效率对比
| 场景 | 用错模型 | 用对模型 | 差异 |
|---|---|---|---|
| 写 10 个单测 | Claude Opus / $0.5 / 过剩 | DeepSeek V3 / $0.02 | 省 96% 费用 |
| 800 行重构 | GPT-4o-mini / 返工 2 次 / 90min | Claude Sonnet / 一次过 / 30min | 省 60 分钟 |
| 涉密代码 | 无法使用(不能出网) | 本地 Ollama | 从不能做到能做 |
| 供应商宕机 | 绑定单家 / 停工 4 小时 | 自动切备选 | 省 4 小时 |
一个 8 小时工作日,按任务难度选模型比单一贵模型每月省 $50-100——比 Cursor $20 月费便宜,还有更大选择权。
供应商出问题时你有备选
2024-2025 年 OpenAI 至少经历了 3 次重大宕机,每次数小时。Anthropic 的 API 限流在高峰期非常激进。
| 场景 | 绑定单一模型 | wescode 多 Provider |
|---|---|---|
| 主供应商宕机 | 完全停工 | 自动切备选 |
| 供应商限流 | 等待或降级 | 切另一家继续 |
| 新模型发布 | 等工具方适配 | 当天填 Key 就能用 |
| 供应商涨价 | 被动接受 | 切更便宜的供应商 |
常见问题
Q:Cursor 不是也可以填自己的 API Key 吗? A:可以。但 Cursor 官方确认:即使自带 Key,请求仍经过 Cursor 后端做 prompt 组装。Key 是你的,但请求路径不是直连的。此外 Cursor 的可用模型清单由 Cursor 维护,清单外的模型接不进来。
Q:模型太多了我不知道选哪个怎么办? A:起步方案:日常编码用 DeepSeek V3(便宜、中文好),复杂推理切 Claude Sonnet。两个 Key 月花费约 $10-20,可能比 Cursor $20 订阅还便宜,但有更大选择权和直连数据路径。
Q:wescode 会自己推出模型服务吗? A:wescode 通过 weisyn 平台提供了代理服务(WES Provider),但只是选项之一——你完全可以不用,直连 OpenAI / Anthropic / DeepSeek。工具和模型解耦是设计原则。
Q:本地模型推理质量差距大吗? A:诚实说,差距明显。本地 16B 模型大约相当于 GPT-4 级别,和最新的 Claude Sonnet / GPT-4o 有代差。但对"代码不能出设备"的场景,能不能用才是门槛。而且本地模型的能力正在快速追赶——2025 年初的 Qwen2.5-Coder 32B 在代码补全和单文件修改上已接近商用 API 水平。
Q:多个 Key 怎么管理安全性? A:wescode 的底层引擎支持加密存储 API Key(AES-256-GCM),Key 只在发起请求的瞬间解密,不会明文写入日志或导出文件。配合系统环境变量或 secret 管理工具可进一步加固。
Q:企业内部署了 vLLM 推理服务能接入吗?
A:可以。vLLM 默认提供 OpenAI 兼容 API 格式。在 wescode 设置面板填入内部推理地址(如 http://inference.internal:8000/v1)和模型名称即可。整条链路不出企业内网,满足金融行业数据安全要求。同理,TGI(Text Generation Inference)、SGLang 等主流推理框架也都兼容这个格式,配置方式一模一样。
本文对各工具模型支持的描述基于其 2026-09-20 的公开信息。