多文件改动的一致性,谁在替你检查
利益声明:本文作者参与了 wescode 的开发。文中涉及 wescode 的技术描述基于内部测试数据;涉及其他工具的描述基于各家公开文档和社区反馈。
AI 一次改了 8 个文件,改完告诉你"全部完成"。你打开第一个文件看看,改得不错。第二个也没问题。
你真的会 8 个文件逐行看完吗?
大多数人的实际做法是:重点看 2-3 个核心文件,其他的扫一眼 diff 行数——如果改动不大就直接过了。
问题是:AI 跨文件改动时最容易犯的错,恰恰藏在你不会细看的那几个文件里。
多文件改动会错成什么样
错误一:改了定义,漏了调用方
你让 AI 给一个函数加一个参数。AI 改了函数定义,也改了它看到的两个调用方。但第三个调用方在一个它没读到的文件里——那个文件编译直接报错。
这种编译器能抓住的还算好的。更隐蔽的是:AI 改了返回值结构(比如把 {success: boolean} 改成 {ok: boolean}),但有一个调用方用 if (result.success) 做判断——编译不报错(TypeScript 里 result.success 不存在时是 undefined,等于 false),逻辑静默走错。
错误二:风格不一致
AI 在 service/ 目录下的文件里用了 async/await,在 handler/ 目录下的文件里用了 .then() 链——两种风格都能跑,但项目约定统一用 async/await。reviewer 看核心文件时没注意到 handler 文件里的风格差异。
错误三:改了 A 却没改 A 的测试
AI 改了 utils/validator.ts 的验证逻辑,但 tests/validator.test.ts 里的断言还是旧的。测试能过——因为 AI 的改动刚好没改变测试覆盖到的那几条路径。但下次有人跑完整测试矩阵时,才发现测试和实现已经不匹配。
错误四:并发修改冲突
你在改文件 A,AI 同时改了文件 A 和文件 B。如果用全文替换(让模型输出整个文件),你的改动直接被覆盖。如果用 diff,只要不是同一区域通常没问题——但 AI 不知道你在改哪里,它选的修改区域可能刚好和你的重叠。
一个跨 4 文件的完整案例
场景:给 UserResponse 接口加一个 avatar 字段。听起来很简单——改一个类型定义而已。但牵出 4 个文件的连锁改动。
改前的类型定义:
// types/user.ts
interface UserResponse {
  id: string
  name: string
  email: string
}
改后:
// types/user.ts(改后)
interface UserResponse {
  id: string
  name: string
  email: string
  avatar: string | null  // 新增
}
类型改了,下面 4 个文件必须同步:
// repositories/user.repository.ts — 查询要加字段
async findById(id: string): Promise<UserResponse | null> {
  const row = await db.query(
    'SELECT id, name, email, avatar FROM users WHERE id = $1',  // avatar 加到 SELECT
    [id]
  )
  return row ? { id: row.id, name: row.name, email: row.email, avatar: row.avatar } : null
}
// services/user.service.ts — 组装对象要填 avatar
async getUser(id: string): Promise<UserResponse> {
  const user = await this.repo.findById(id)
  if (!user) throw new NotFoundException('User not found')
  return {
    id: user.id,
    name: user.name,
    email: user.email,
    avatar: user.avatar ?? null,  // 新增:确保 avatar 始终有值
  }
}
// controllers/user.controller.ts — DTO 映射要覆盖 avatar
@Get(':id')
async getUser(@Param('id') id: string) {
  const user = await this.userService.getUser(id)
  return {
    ...user,
    avatarUrl: user.avatar ? `https://cdn.example.com/${user.avatar}` : null,
  }
}
// tests/user.service.test.ts — mock 数据和断言要包含 avatar
const mockUser: UserResponse = {
  id: '1',
  name: 'Alice',
  email: 'alice@example.com',
  avatar: 'alice.jpg',  // 新增
}

it('should return user with avatar', async () => {
  repo.findById.mockResolvedValue(mockUser)
  const result = await service.getUser('1')
  expect(result.avatar).toBe('alice.jpg')  // 新增断言
})
看起来很清晰——但让 AI 来做这件事,4 个文件全改对的概率远没你想象的高。
同样的模式在 Python 和 Java 中一样常见。比如一个 Python FastAPI 项目中加字段:
# schemas/user.py — Pydantic Model 要加字段
class UserResponse(BaseModel):
    id: str
    name: str
    email: str
    avatar: str | None = None  # 新增

# repositories/user_repo.py — ORM 查询要加字段
async def find_by_id(self, user_id: str) -> UserResponse | None:
    row = await self.db.fetch_one(
        "SELECT id, name, email, avatar FROM users WHERE id = $1",
        user_id
    )
    return UserResponse(**dict(row)) if row else None

# routers/user_router.py — 路由返回的 DTO 要覆盖 avatar
@router.get("/users/{user_id}")
async def get_user(user_id: str, service: UserService = Depends()):
    user = await service.get_user(user_id)
    return {**user.model_dump(), "avatar_url": f"https://cdn.example.com/{user.avatar}" if user.avatar else None}
Java Spring Boot 同理——Entity 加字段、Repository 的 @Query 加列、Service 的 DTO 映射加字段、Controller 的响应体同步。每一层都要改,漏任何一层都会静默出错。
各工具怎么确保多文件一致性
关键区别不在于"AI 能不能改多个文件"——2026 年的主流工具都能。区别在于 AI 怎么找到需要改的文件,以及 改完之后谁在检查。
Cursor:向量检索找关联文件
Cursor 的 Agent 把代码做 Embedding,改 UserResponse 时通过向量相似度搜索找到相关文件。
能找到的:文件里直接出现 UserResponse 字样的 — Repository、Service、Test 大概率找到。
可能漏的:Controller 里如果用了 ...spread 展开而没有显式引用 UserResponse 类型名,向量相似度可能不够高。更常见的情况是通过接口抽象间接调用 — AdminService 里写的是 repo.find(id),跟 UserResponse 没有文本重叠。
改完后 Cursor 跑编译(L0),部分场景跑测试(L1)。但不做改动后的一致性检查 — 不会主动验证"我改的这 4 个文件之间是否内在一致"。
Claude Code:grep 搜索 + 逐文件读取
Claude Code 的方式是 grep "UserResponse" 找到出现这个关键词的文件,逐个读、逐个改。
能找到的:所有字符串匹配的文件 — Repository、Service、Test 都直接引用了 UserResponse。
可能漏的:Controller 里如果只用了 const user = await this.userService.getUser(id) 然后直接 return user,没有显式出现 UserResponse,grep 搜不到。通过接口抽象的调用同理 — repo.find(id) 里没有 UserResponse 这个字符串。
同样不做改动后的自动一致性检查。
Copilot:LSP 引用 + Embedding
GitHub Copilot 在 Workspace Agent 模式下结合 LSP 的 "Find All References" 和 Embedding。LSP 能精确找到类型引用——前提是代码里有显式类型标注。
优势:直接引用 UserResponse 的地方 LSP 能精确定位。局限:运行时行为、类型推断链条上的间接依赖仍可能遗漏。
wescode:CKG 调用图精确追踪
wescode 的 CKG(代码知识图谱)用 10-Pass 深度索引管线构建了 6 种关系边:CALLS / IMPLEMENTS / IMPORTS / DEFINES / EXTENDS / OVERRIDES。
改 UserResponse 时:
- 沿 DEFINES 边找到
UserResponse在哪里被定义 - 沿 IMPORTS 边找到哪些文件导入了这个类型
- 沿 CALLS 边反向遍历找到所有使用了返回
UserResponse的函数的调用方 - 沿 IMPLEMENTS 边找到接口的其他实现类
这不是搜索 — 是图遍历的确定性结果。AdminService.lookupUser() 里写的是 repo.find(id),CKG 走 IMPLEMENTS 边从 find → UserRepository 接口 → 再沿 CALLS 边反向找到 AdminService,三步遍历、毫秒级完成。
通义灵码 / Trae
这两款工具目前的多文件改动能力相对较弱。通义灵码主要做单文件内的补全和修改,找关联文件的能力有限。Trae 的 SOLO 模式可以做多文件操作,但没有独立的一致性检查机制。
各工具查找关联文件的技术路径对比
| 工具 | 查找方法 | 找 Repository | 找 Service | 找 Controller(无显式类型引用) | 找接口抽象调用 |
|---|---|---|---|---|---|
| Cursor | Embedding 向量检索 | ✅ | ✅ | ⚠️ 看向量相似度 | 文本无重叠时漏检 |
| Claude Code | grep + 模型判断 | ✅ | ✅ | ⚠️ 看关键词匹配 | 字符串不匹配时漏检 |
| Copilot | LSP 引用 + Embedding | ✅ | ✅ | ⚠️ 看类型标注 | ⚠️ 看 LSP 覆盖 |
| wescode | CKG 图遍历 | ✅ | ✅ | ✅ CALLS 边追踪 | ✅ IMPLEMENTS 边 |
| 通义灵码 | 补全上下文 | ⚠️ | ⚠️ | 不支持 | 不支持 |
CKG + CSE + L2.5:三层联动检查流程
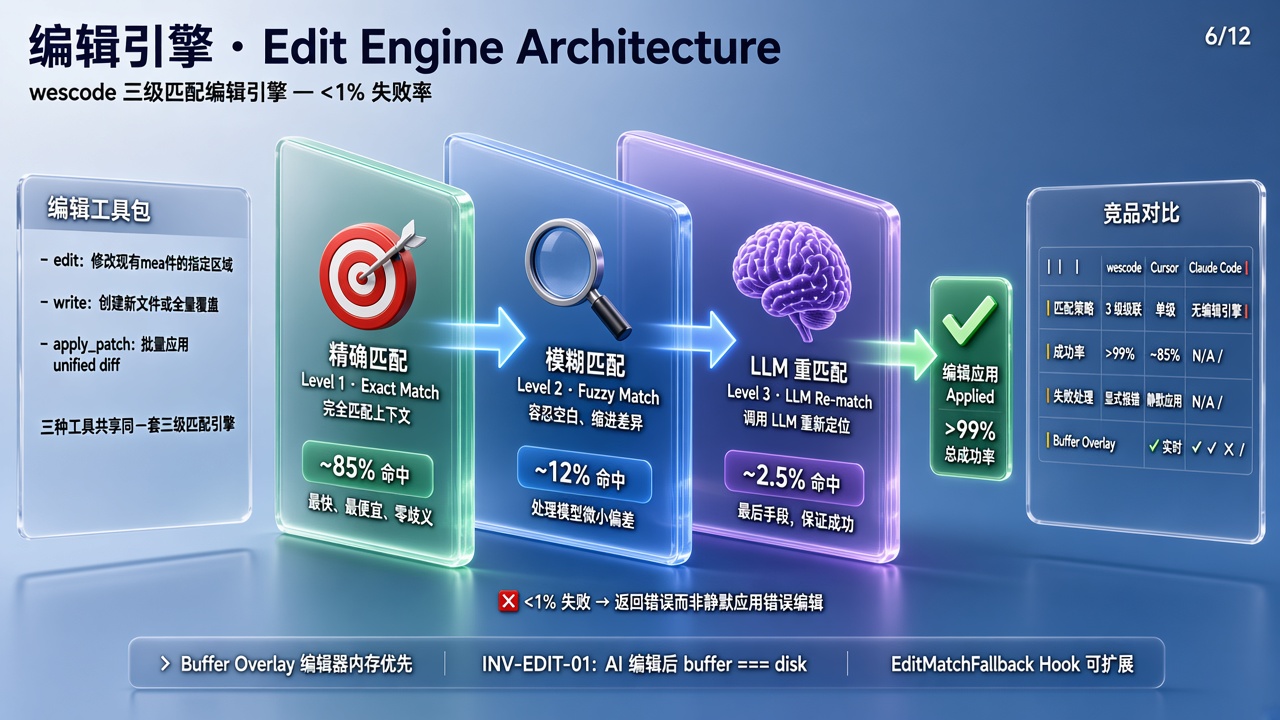
wescode 不只是在改动前找全文件。改动前、改动中、改动后各有一层自动检查:
| 阶段 | 检查层 | 做什么 | 发现什么问题 |
|---|---|---|---|
| 改动前 | CKG | 从 UserResponse 出发,遍历 CALLS / IMPLEMENTS / IMPORTS 边 | 列出全部 4 个需要同步修改的文件 + 潜在的间接调用方 |
| 改动中 | AI + CKG | AI 修改每个受影响文件,CKG 提供调用关系作为上下文 | — |
| 改动后-1 | CSE | 13 Checker × 4 推断路径,零配置检查风格一致性 | 发现 Controller 用了 ...spread 而其他文件用显式字段映射 |
| 改动后-2 | L2.5 | 改动前记录行为快照,改动后对比 | 发现 getUser(validId) 的返回 JSON 多了 avatar 字段(预期变化需确认) |
| 改动后-3 | 编译+测试 | L0 编译 + L1 测试 | 发现 Test 的 mock 数据如果漏了 avatar 字段,TypeScript 编译报错 |
CSE 怎么工作
CSE(约束满足引擎)有 13 个 Checker,覆盖命名规范、错误处理模式、异步风格、导入约定等。它不需要你写配置文件——从项目现有代码中自动学习惯例。
4 条推断路径:
- 文件级:同一文件里其他函数怎么写的
- 目录级:
services/目录下其他 service 文件怎么写的 - 项目级:整个项目里最常用的模式
- 框架级:框架的官方约定
权重递减——文件级最高,框架级最低。这意味着如果你的 services/ 目录下 10 个文件都用 async/await,AI 在第 11 个文件里用 .then() 链会被 CSE 标记。
一个 Java Spring 项目的具体例子。CSE 能检测到这种不一致:
// services/OrderService.java — 项目惯例:用 Optional + orElseThrow
public Order getOrder(String id) {
    return orderRepo.findById(id)
        .orElseThrow(() -> new NotFoundException("Order not found"));
}

// services/UserService.java — AI 改出了不同的风格:用 if + null 检查
public User getUser(String id) {
    User user = userRepo.findById(id).orElse(null);
    if (user == null) {
        throw new NotFoundException("User not found");
    }
    return user;
}
两种写法功能相同,但风格不一致。CSE 的目录级 Checker 会检测到 services/ 下其他文件都用 Optional.orElseThrow(),标记 UserService 的写法需要对齐。
L2.5 怎么工作
L2.5 在 AI 修改代码之前自动录制关键函数的行为快照:
- 识别被修改函数的调用方
- 用预设输入(valid ID / invalid ID / edge case)运行这些调用方
- 记录返回值结构、状态码、错误类型等
- AI 修改完成后,用同样的输入再跑一次
- 对比两次结果,标记变化
L2.5 标记的是事实("这个行为变了"),不做价值判断("这个变化好不好")。你看到标记后决定:这个变化是预期的(确认),还是意外的(回滚或修正)。
一个"看起来改完了但实际不一致"的案例
最阴险的不是编译报错的那种遗漏——而是编译通过、测试也过、但运行时行为不一致的情况。
回到上面的 avatar 案例。假设 AI 改完了 4 个文件,编译通过,测试也过了。但有一个微妙的不一致:
// Service 返回了 avatar: null(正确)
// Controller 用 ...spread 展开
return { ...user, avatarUrl: user.avatar ? `https://cdn.example.com/${user.avatar}` : null }

// 改前:前端收到 {"id":"1", "name":"Alice", "email":"alice@example.com"}
// 改后:前端收到 {"id":"1", "name":"Alice", "email":"alice@example.com", "avatar": null, "avatarUrl": null}
看起来行为一样——前端的 if (response.avatar) 改前改后都走 false 分支。但实际上含义从"字段不存在"变成了"字段存在但为 null"。
这在大多数场景下无害。但如果:
- 前端用了严格的 JSON Schema 校验器(区分
missing和null) - API 契约文档写了"只返回非 null 的字段"
- 下游服务用
"avatar" in response判断是否支持头像功能
这种不一致就会在某一天、某一个下游静默出错。
L2.5 能抓住这种变化——它在改动前后对比 getUser(validId) 的返回值结构,会标记"返回 JSON 的 key 集合从 3 个变成了 5 个"。你看到这个标记后可以判断:是预期的(那就确认),还是 ...spread 不该把原始字段也透传出去(那就改 Controller 只返回 DTO 字段)。
手动 Review vs 自动检查:一次真实对比
假设 AI 完成了一个跨 6 个文件的接口重构。你用两种方式来确认改动一致性:
| 对比维度 | 手动逐文件 Review | wescode 自动三层检查 |
|---|---|---|
| 耗时 | 20-40 分钟(6 个文件,每个 3-7 分钟) | 2-5 秒(CKG 遍历 + CSE + L2.5 自动跑完) |
| 找全调用方 | 靠经验和 grep | CKG 确定性遍历,漏一个算 Bug |
| 发现风格不一致 | 靠肉眼对比和记忆 | CSE 13 Checker 自动对比 |
| 发现行为变化 | 靠脑子推演逻辑 | L2.5 直接跑出来 |
| 误漏率 | 6 个文件里漏看 1-2 个是常态 | 结构确认的关系不遗漏 |
| 疲劳衰减 | 第 4 个文件开始注意力下降 | 机器不会累 |
注意:这不是说"不需要 review"——你仍然需要看 AI 改出来的东西是不是你想要的。但"改完了没有""改一致了没有""有没有行为变化"这三类机械判断应该由自动化完成,让你把有限的注意力放在"是不是我想要的设计"上。

一个完整场景走一遍
场景:把 UserService.getUser() 从返回 User | null 改成返回 User(找不到时抛异常)。
Cursor 的过程:Agent 改了 getUser() 本身,通过 Embedding 搜索找到了 2 个直接调用方并修改了 null 检查。但通过 UserRepository 接口调用的 AdminService.lookupUser() 没被搜到(因为那里写的是 repo.find(id) 不是 getUser),测试文件里 null 场景的测试也没改。编译通过(TypeScript 不强制 catch),测试大部分过(null 场景的测试因为改了抛异常所以现在反而"意外地"过了——异常没被 catch 就是测试失败,被 Jest 记为"正确地失败了")。
wescode 的过程:CKG 列出 getUser 的完整调用方(含接口实现),影响面里包含 AdminService.lookupUser()。AI 把所有调用方都改了。CSE 检查发现 AdminService 里原来有统一的 null 检查模式,现在改成了 try/catch,提示风格不一致。L2.5 检查发现 getUser(invalidId) 的行为从返回 null 变成了抛异常——标记为行为变化(这是有意的,但需要你确认)。
区别不在于"AI 写代码的质量"——两边用的可能是同一个模型。区别在于改完之后谁在替你检查。
| 对比维度 | Cursor | Claude Code | wescode | wescode 代价/局限 |
|---|---|---|---|---|
| 找全受影响文件 | 向量检索,可能漏接口调用 | grep 搜索,可能漏间接引用 | CKG 图遍历,确定性结果 | 首次索引需数秒至十余秒(内部测试数据) |
| 风格一致性检查 | 不支持 | 不支持 | CSE 13 Checker 零配置 | Checker 覆盖范围有限,自定义规则需手写 |
| 行为变化检测 | 不支持 | 不支持 | L2.5 行为快照对比 | 需项目可构建且有测试入口 |
| 编译检查(L0) | ✅ | ✅ | ✅ | — |
| 测试(L1) | 部分场景 | 需手动 | 自动触发 | 依赖项目已有测试覆盖 |
常见问题
Q1:我仔细 review 每个文件不就行了?
当然可以。但 AI 改 8 个文件只要 30 秒,你逐行 review 8 个文件需要 20-40 分钟。如果每次 AI 改完你都花比它更长的时间来检查,AI 编程的效率优势就被检查成本吃掉了。自动化的一致性检查让你把精力放在"是不是我想要的",而不是"改完了没有"。
Q2:多文件改动的错误率高吗?
看项目复杂度。简单项目(一个函数改名、几个调用方跟着改)出错率很低。复杂项目(改一个接口的契约、涉及 10+ 个文件、部分通过抽象层间接依赖)出错率显著上升。没有精确数字——但只要你经历过一次"AI 改了 8 个文件,漏了第 9 个,上线之后才发现",你就知道一致性检查的价值。
Q3:wescode 的这些检查会不会太严格,导致很多误报?
CSE 的检查结果是建议而非强制——它告诉你"这里和惯例不一致",由你决定是遵从还是有意打破。L2.5 的行为变化标记也是提醒性质——有些行为变化就是你要的(比如把 null 改成抛异常),确认一下就行。宁可多提醒一次让你确认,也不要遗漏一次让你上线后才发现。
Q4:CKG 的图遍历和 LSP 的 Find All References 有什么区别?
LSP 的引用查找依赖编辑器运行时的类型分析,精度高但只能找到显式的类型引用——代码里写了类型名的地方。CKG 的 6 种关系边覆盖了调用(CALLS)、接口实现(IMPLEMENTS)、继承覆盖(OVERRIDES)等运行时语义关系。一个函数通过依赖注入拿到的接口实例调用了另一个函数,LSP 可能只追踪到接口声明,CKG 能沿 IMPLEMENTS 边追踪到具体实现类——这在大型项目里区别很大。
本文对各工具多文件编辑能力的描述基于其 2026-09-20 的公开功能。